なぜ「セマンティックレイヤー」が急に注目されているのか
まず、なぜ2025〜2026年にかけて業界の話題が集中しているのかを、数字で確認します。
生成AIが「数値の食い違い」を可視化した 自然言語でDWH(データウェアハウス、分析用にデータを集約して保管する基盤)に問いかける仕組みは、この2年で一気に普及しました。BigQueryのGemini in BigQuery、Snowflake Cortex、Databricks Genie、Microsoft Fabric Copilot。どのDWHにもチャットで質問できる窓口が付き、社内でも試したチームが多いのではないでしょうか。
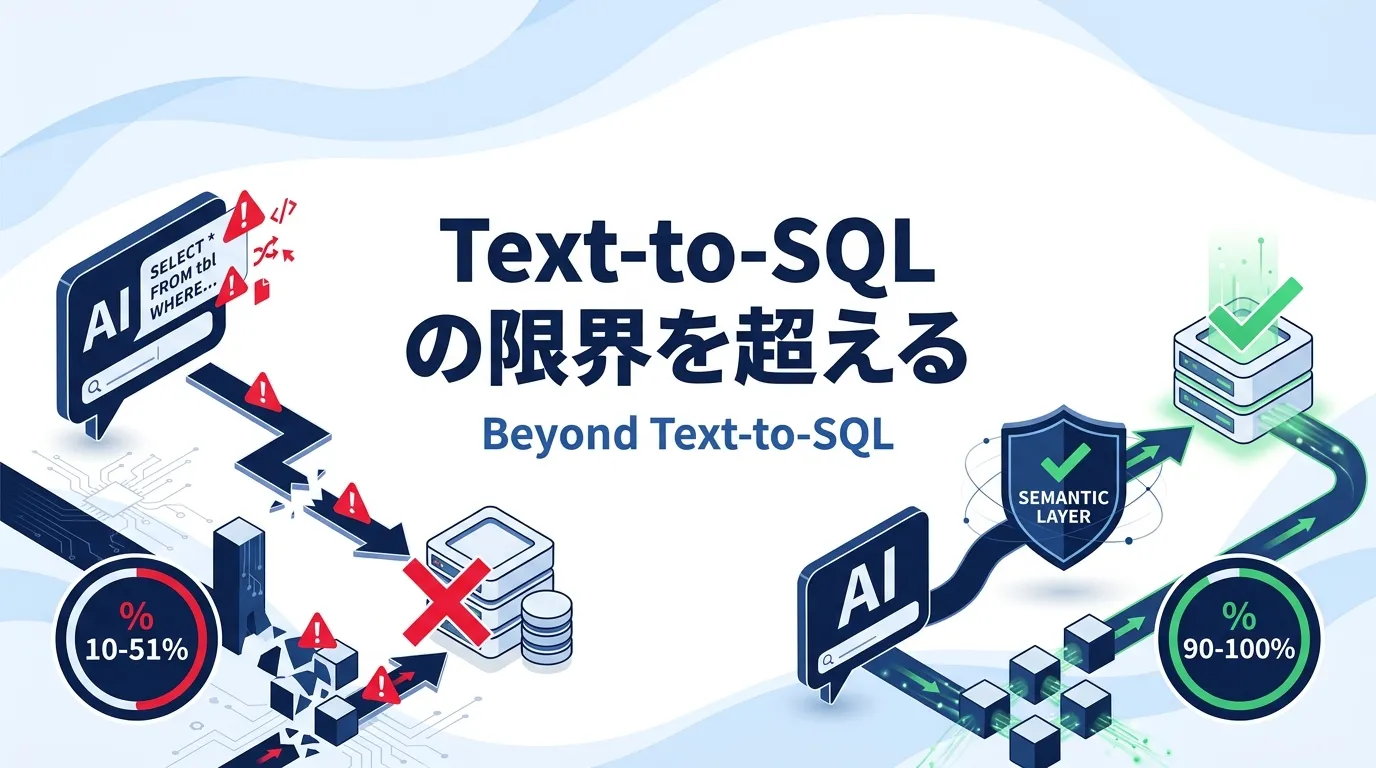
そこで露呈したのが、AIが生成するSQLの品質問題です。dbt Labsが2026年に公開したベンチマークでは、生のText-to-SQL(自然言語からSQLを直接生成する方式)の正答率は**約10〜51%だったのに対し、セマンティックレイヤー経由では 90〜100%**まで跳ね上がりました。差の要因の大半は、指標定義や結合条件をAIが推測してしまうことにあります。
4,602件のText-to-SQLエラーを分析した2025年の学術研究「NL2SQL-Bugs」でも、実行失敗のうち80%以上が「スキーマ関連のハルシネーション」 、つまり存在しない列名や誤った結合を生成した結果でした。
ガートナーの数値も強い 調査会社ガートナーは、2026年のデータ&アナリティクス予測(2026年3月)で、次のように示しています。
セマンティックレイヤーを導入した組織では、生成AIの回答精度が 80%改善 し、コストは 60%削減 される見込み MCP(Model Context Protocol、AIエージェントがツールに接続する仕様)だけに頼るAgentic Analyticsのプロジェクトは、2028年までに 60%が失敗 する 2030年までに、ユニバーサル・セマンティックレイヤーはデータ基盤・セキュリティと並ぶ必須インフラになる 「AIエージェントをDWHに繋いで自然言語で答えさせる」だけでは早晩壁にぶつかる、その手前に共通の意味定義を置け、というのがガートナーの主張です。
標準化フェーズにも入った 2025年後半から2026年にかけて、Snowflake・dbt Labs・Databricksが中心となって **Open Semantic Interchange(OSI)**という標準化イニシアチブが立ち上がり、CubeやAtScaleもYAMLの定義形式を寄せる動きを見せています。特定ベンダーに閉じた仕様ではなく、ツールをまたいで持ち運びできる状態が近づいています。
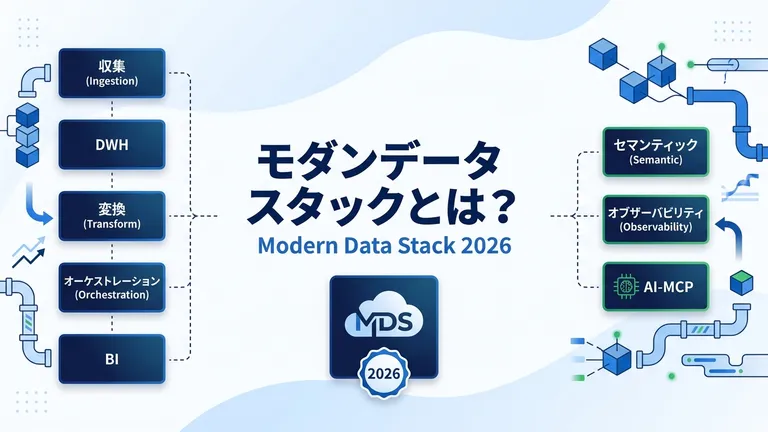
流行りものではなく、業界全体が「共通の意味定義がないとAIの時代は前に進まない」という認識で足並みを揃え始めた、と読むのが正確です。この2025〜2026年にかけての変化は、モダンデータスタック(MDS)の中に「セマンティックレイヤー」「オブザーバビリティ」「AI/MCP接続」という新しい3層が第一級市民として組み込まれた再編でもあります。全体像はモダンデータスタックとは?2026年の構成例と費用 で整理しています。
セマンティックレイヤーとは何か
用語だけ聞くと抽象的なので、位置と役割から押さえます。
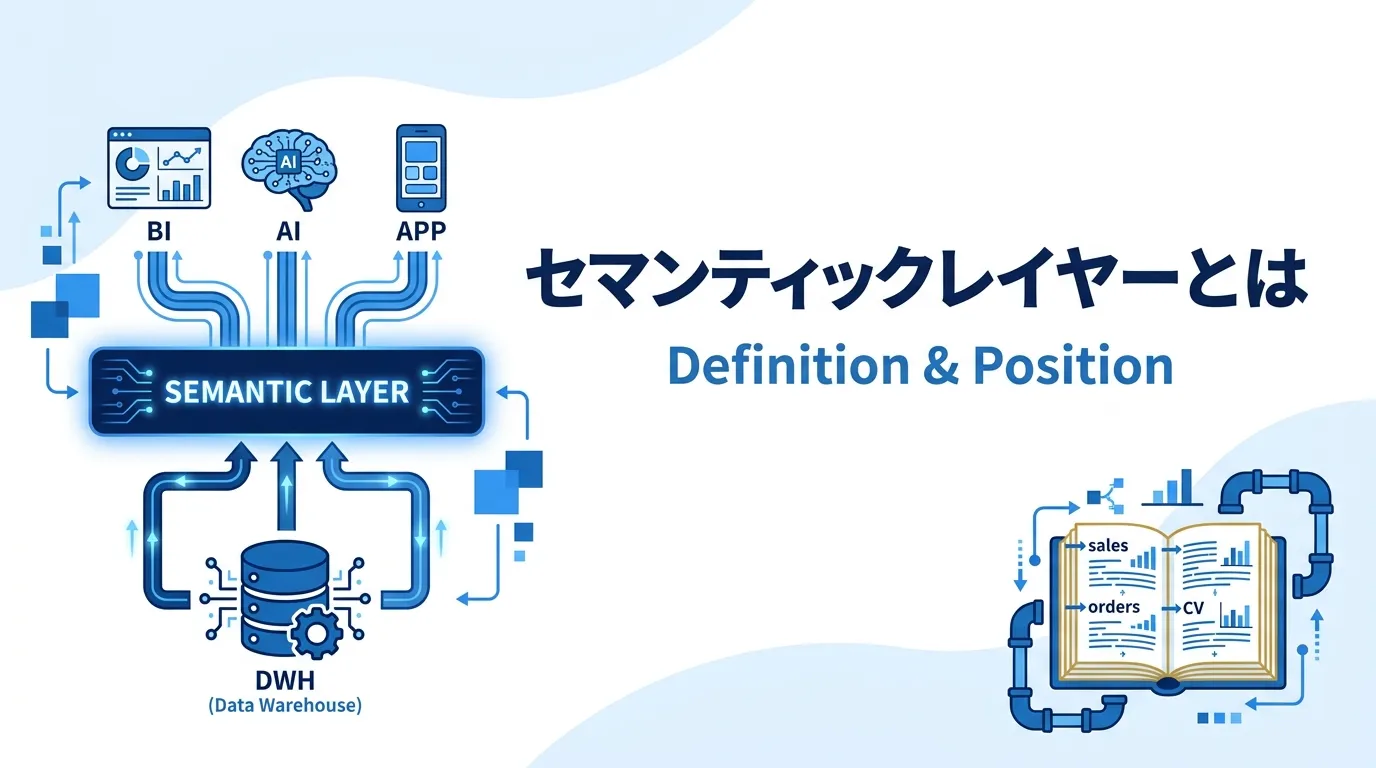
位置:DWH と 利用側の「間」 セマンティックレイヤーは、BigQuery や Snowflake といったDWHと、それを利用するBI・AI・社内アプリの間に挟む**「用語の公式辞書」**です。「売上」「受注件数」「粗利率」といった指標の計算式や、それを切る次元(日付・部署・商品カテゴリ)を、YAMLなどのコードで1度だけ定義します。
SEMANTIC LAYER
意味の公式辞書
売上・受注・CV…1度定義 → どこでも同じ数字
USE
BIツール
AIエージェント
社内アプリ
Notebook
セマンティックレイヤーは、DWH と利用側(BI・AI・アプリ)の間に置く「用語の公式辞書」 利用側(BIツール、AIエージェント、社内アプリ、Jupyter Notebook)は、生SQLを書く代わりに「売上を月別に、部署ごとに」といった指標名と次元の組み合わせで問い合わせます。裏でセマンティックレイヤーが決定的なSQLに翻訳し、DWHに投げ、結果を返します。
上の図のように、DWHには手を入れずに、その上に薄い「意味の層」を置いてすべての利用側に配信する、というイメージが近いです。
役割:3つある 役割は大きく3つに整理できます。
単一の定義 :「売上とは何か」を組織で1つに揃え、どのツールから問い合わせても同じ数字が返る確定的なSQL生成 :AIやユーザーが指標名を選ぶだけで、正しいJOINとGROUP BYを含むSQLをレイヤーが機械的に生成する横串の権限適用 :「営業担当は自部門のデータのみ閲覧可」といった行レベル権限を、問い合わせの瞬間に強制できるダッシュボードの中でも、AIチャットでも、社内アプリのAPIでも、同じ定義と同じ権限で数字が返る状態を作る。これが、セマンティックレイヤーが引き受ける仕事です。
AI活用の前提となるデータ整備の全体像は、なぜAI時代にこそデータ基盤が必要か|生成AIが失敗する理由 で整理しています。あわせて読むと、この層がなぜ「AI-readyなデータ」の要になるかが把握できます。
BI閉じの定義と Headless セマンティックレイヤーの違い
「うちのBIには計算メジャーの機能がある。それとは何が違うのか」という問いは、実際によくいただきます。ここは押さえておきたい点です。
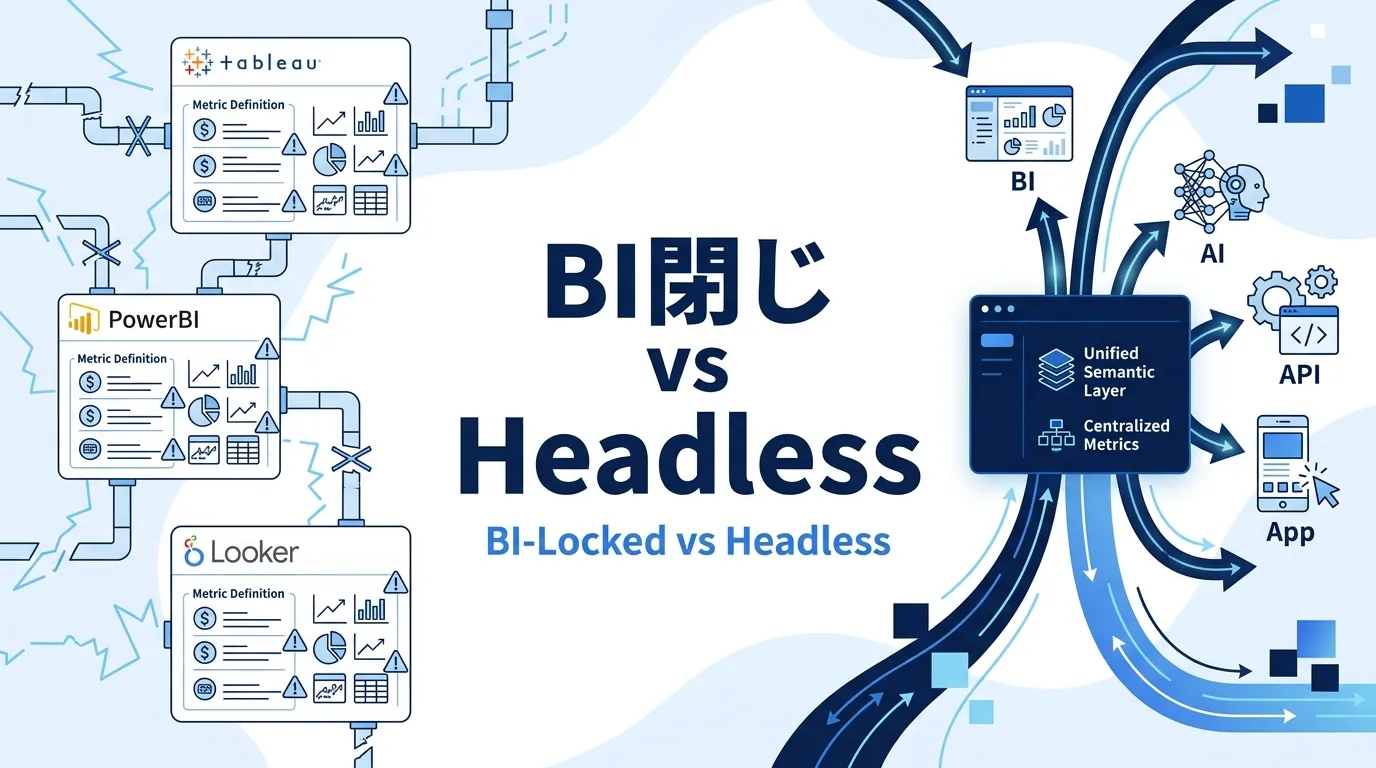
従来型:BIツール閉じ TableauやPower BI、Lookerには、指標や次元を定義する機能が古くからあります。Lookerの「LookML」は、この分野の元祖にあたる仕組みです。ただし、そこで定義した指標は各BIツールの中に閉じます。
Tableauで「受注ベースの売上」を定義しても、Power BIから同じ定義は参照できません。AIエージェントや社内アプリからも直接呼べません。結果として、複数BIを併用している組織では、同じ指標を各BIで再定義することになります。定義がツール間でズレて、**「BIをまたぐと数字が違う」**問題が生じる典型例です。
Headless:BI・AI・アプリ横断 対して2020年代に伸びてきたのが、UIを持たないHeadless型のセマンティックレイヤー です。dbt Semantic Layer、Cube、AtScaleがこの系統です。
従来型:BIツール閉じ
各BIの中に指標定義が閉じている 別のツールに移すと再定義が必要 AIエージェントは参照できない 「同じ売上でも数字が違う」が起きる Headless セマンティックレイヤー
1度定義した指標を全ツールが同じ数字で参照 Git で定義をコード管理・PRレビュー可能 LLM が API 経由で確定的な数値を取得 BI ツールを乗り換えても定義は再利用 BIツール閉じの定義 vs Headless(BI・AI・アプリ横断で使える)セマンティックレイヤー 上の図のように、Headless型は「1つの定義を、SQL/GraphQL/REST/MCPといった複数のAPIで配信する」ことに特化しています。BIツールを乗り換えても定義は再利用でき、AIエージェントも同じ定義に基づいて数値を取得できます。定義はYAMLなどのテキストで書き、Gitで管理してPRレビューを回せます。
2025年以降の潮流は、明確にHeadless側にあります。BI閉じの定義を否定するというより、「AIやアプリも呼び出す時代には、BIの外に定義を出す必要が増えた」という位置づけです。従来のBIツールとの比較や選び方は、Power BI・Tableau・Lookerを徹底比較|3大BIツールの選び方 でも整理しています。
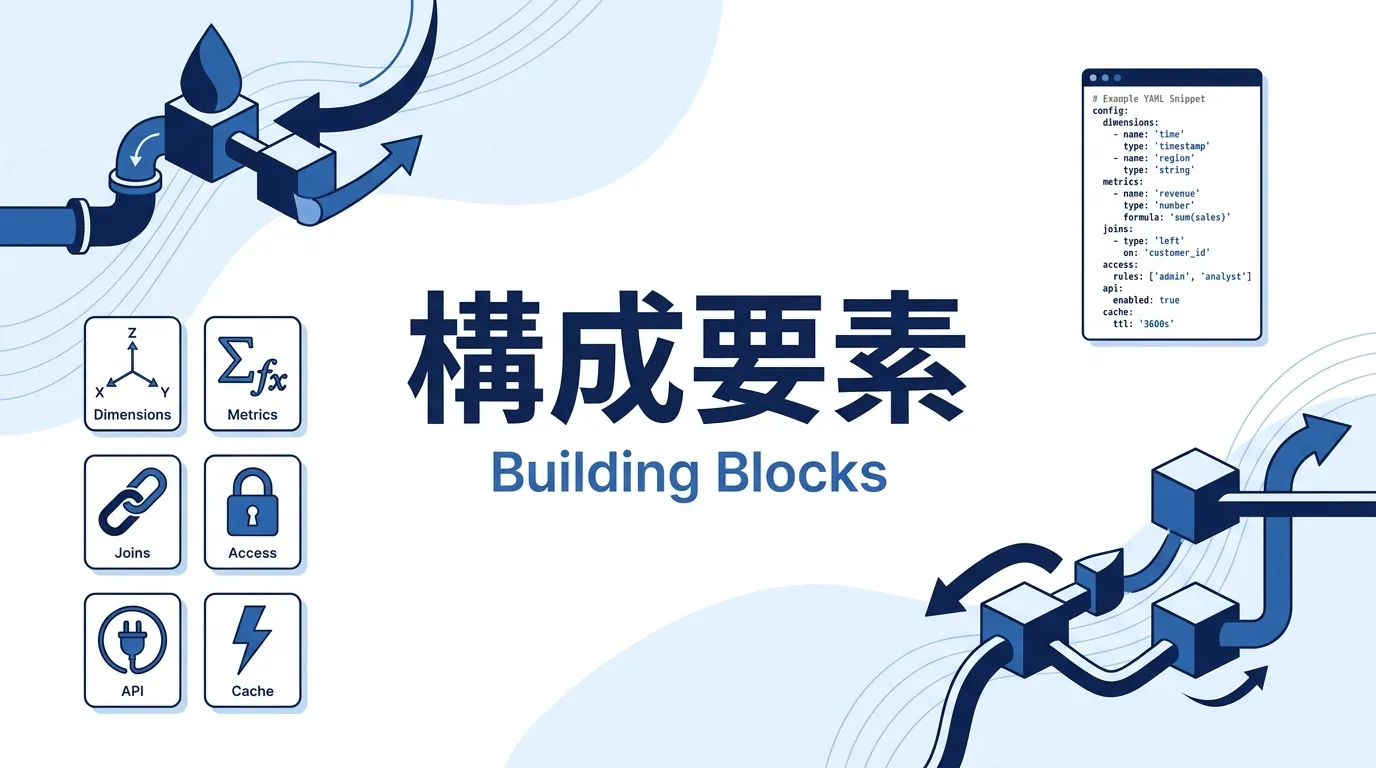
セマンティックレイヤーの構成要素
具体的にYAMLで何を書くのかを、代表的な要素で押さえます。
Dimensions(次元)
「日付・部署・商品カテゴリ」など、指標を切る軸
Measures / Metrics(指標)
「売上・受注件数・粗利率」などの計算式を1度だけ定義
Joins(結合)
テーブル同士のつなぎ方を明示(受注 × 顧客 × 商品)
Access Control(権限)
「営業は自部門のみ」等、行レベルの権限を問い合わせ時に適用
API(配信)
SQL / GraphQL / REST / MCP 経由で BI・AI・アプリに配信
Cache(高速化)
同じ問い合わせは事前集計を返し、DWH コストを抑える
セマンティックレイヤーの主な構成要素(YAML などのコードで定義する) 上の図で示した6つが、dbt Semantic LayerでもCubeでも共通する骨格です。個別に見ます。
Dimensions(次元) :指標を切る軸。日付・部署・商品カテゴリ・チャネル・地域など。時間軸には「月次」「四半期」「YTD」「YoY」といった標準的な集計方法を型として持たせますMeasures / Metrics(指標) :計算式。「受注件数の合計」「税抜き売上の合計」「粗利率=(売上−売上原価)÷売上」など。1度定義したら、次元をどう組み合わせても同じ計算が使われますJoins(結合) :受注と顧客、受注と商品、受注と広告費といったテーブル同士のつなぎ方。ここを定義しておくと、AIやユーザーが結合条件を推測する余地がなくなりますAccess Control(権限) :「営業担当は自部門のみ、管理職は全社」といった行レベル権限を、問い合わせ時に強制します。BIごとに権限を作り込む必要がなくなりますAPI(配信) :SQLインターフェース(BigQueryのように普通のSQLで叩ける)、GraphQL、REST、そして2025年後半から普及したMCP。呼び出し側の技術に応じて選べますCache(高速化) :同じ問い合わせは事前集計を返し、DWHのクエリ回数と課金を抑える仕組み。特に社内アプリからの高頻度アクセスで効きますなおDimensionsの「商品カテゴリ」「チャネル」といった項目名は、社内で用語がぶれやすい部分でもあります。データカタログ で全社共通の用語集を先に整えておくと、複数チームでYAMLを書いても定義がずれにくくなります。
書き方の雰囲気を示すと、dbt Semantic Layerでは次のようなYAMLで指標を定義します。
semantic_models : - name : orders model : ref('fct_orders') entities : - name : order_id type : primary - name : customer_id type : foreign dimensions : - name : order_date type : time - name : sales_channel type : categorical metrics : - name : net_revenue label : 税抜き売上 type : simple type_params : measure : order_amount_ex_tax このYAMLを1度書けば、BIからも、AIエージェントからも、社内アプリからも、net_revenue という同じ指標を同じ計算で呼び出せます。dbtのモデル管理そのものについては、dbtとは?データ変換をコード管理するツールの仕組みを解説 で解説しています。
AI連携:Text-to-SQLの限界を超える
セマンティックレイヤーが特に効くのが、生成AIとの連携です。ここは冒頭の数値(AIの回答精度80%改善)に直結する話です。
直接 Text-to-SQL の弱点 自然言語でDWHに問いかける最も素朴な方式は、AIに生SQLを組み立てさせる直接Text-to-SQLです。GeminiやClaudeがDWHのスキーマを見て「たぶんこう書けばよい」とSQLを生成します。
直接 Text-to-SQL
JOIN・列名・指標定義を推測 → 実行エラーや数値の誤り
セマンティックレイヤー経由
ユーザー質問
→
LLM が指標名・次元を選ぶ
→
セマンティック層
→
DWH
SQL は決定的に生成 → 定義が揺れず、数値が安定
AIが直接 SQL を書く経路と、セマンティックレイヤー経由の経路の違い 上の図のように、この経路ではLLMが「売上とは何か」「どの列を使うか」「どこでJOINするか」をすべて推測します。列名を微妙に間違えたり、返品を除外し忘れたり、部署でズレる定義のうち一方を採用してしまったり。実行に失敗すれば気付けますが、実行に成功して「それらしい違う数字」を返すのが一番厄介 です。
セマンティックレイヤー経由に切り替える 同じ質問を、セマンティックレイヤー経由に切り替えるとどうなるか。LLMは「どの指標を、どの次元で切るか」を選ぶだけになり、SQLはセマンティックレイヤーが決定的に生成します。指標と次元は事前にYAMLで定義済みなので、推測が入る余地がありません。
先ほど触れたdbtの2026年ベンチマーク(正答率10〜51% → 90〜100%)は、この経路の切り替えで得られる差です。
実装パターンは2種類あります。
API直叩き :LangChainやLlamaIndexといったフレームワークで、セマンティックレイヤーのAPI(GraphQLやJDBC)をToolとして登録し、LLMが必要に応じて呼ぶMCP経由 :2025年後半以降に普及したMCP対応のセマンティックレイヤーサーバー(dbt MCP Server、Cube MCP、Looker MCP Serverなど)を立て、ClaudeやGeminiのCLIから直接接続するGoogle Cloudは、Looker MCP Server経由でGeminiに問い合わせると、LLM単独時と比べて自然言語誤解の頻度が約2/3に減った と報告しています(Google Cloud Blog、2025年)。
RAGとの棲み分け 「RAG(検索拡張生成)とセマンティックレイヤーはどう使い分けるのか」もよく聞かれます。
答えは補完関係 です。RAGは非構造データ(社内ドキュメント、契約書、議事録)から関連情報を検索して渡す仕組みです。セマンティックレイヤーは構造化された数値・KPIに対する問い合わせを担います。「うちの就業規則で在宅勤務は何日まで?」はRAG、「先週の関東エリアの粗利率は?」はセマンティックレイヤー、という切り分けが素直です。
RAGの仕組みと実装で必要なデータ基盤要件は、RAGとは?企業の社内データをAIに使わせる仕組みと作り方 で詳しく整理しています。
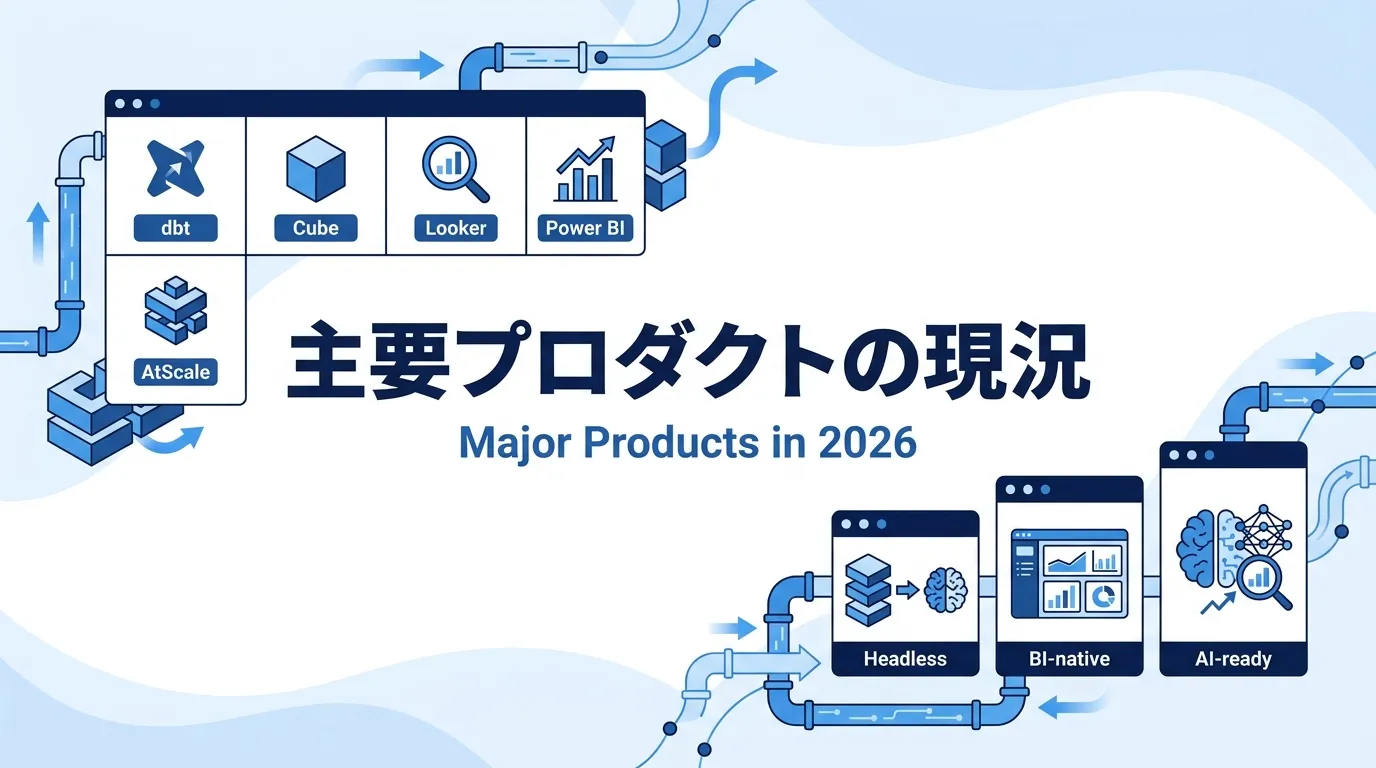
主要プロダクトの現況(2026年時点)
代表的な選択肢を、ざっくりの位置づけで整理します。
プロダクト 提供元 位置づけ 強み dbt Semantic Layer dbt Labs Headless、Git/YAML中心 dbt Coreとの一体運用、コード管理、2025年末にMetricFlowがOSS化 Cube Cube.dev Headless、API/アプリ中心 OSS版あり、AI API(Cube AI API)でRAG組込機能を内包、キャッシュが強い Looker(LookML) Google Cloud BI付き 元祖の設計思想、Gemini in Lookerでの自然言語対応、Looker MCP Server Power BI Semantic Model Microsoft BI付き(旧Dataset) Fabric F2 SKU(月額約$262)で利用可、Copilot連携 AtScale AtScale Headless、DWH非依存 2025年GigaOm Radarでリーダー評価、大規模組織で採用多め MicroStrategy ONE MicroStrategy BI付き、Semantic Graph AtScaleと統合可能、既存MicroStrategy顧客向け
選定の考え方は、「既存の資産に寄せる」が現実的です。
既にdbtでデータ変換を管理しているなら、dbt Semantic Layer が地続きで導入コストが低い 社内アプリやAIエージェントに数値APIを提供したい、AI API機能をすぐ欲しいなら Cube (OSS版から試せる点も強い) Google CloudでBigQuery + Looker中心なら、LookML をヘッドレス化して外部からも呼べるようにする経路が現実的 Microsoft Fabric + Power BI中心なら Power BI Semantic Model を軸にする 日本国内での採用状況の定量データは公開ソースが乏しく、体感ではPower BI SemanticとLookMLが多数、dbt Semantic LayerとCubeが技術志向の組織で急速に採用が伸びている、という肌感です。TVer社のアドテク基盤ではdbt Platformが本番採用されており(TVer Tech Blog、2025年)、genda社ではCubeを社内プロダクトに組み込んだ事例が公開されています(Zenn、2025年)。
DWH側の選定はSnowflakeとBigQueryの違いを徹底比較|選定基準3つ で、Snowflakeの位置づけはSnowflakeとは?特徴・料金体系・BigQueryとの違いを解説 で整理しています。
導入の進め方と失敗パターン
最後に、実際に入れるときの流れと、現場で見かける失敗を整理します。
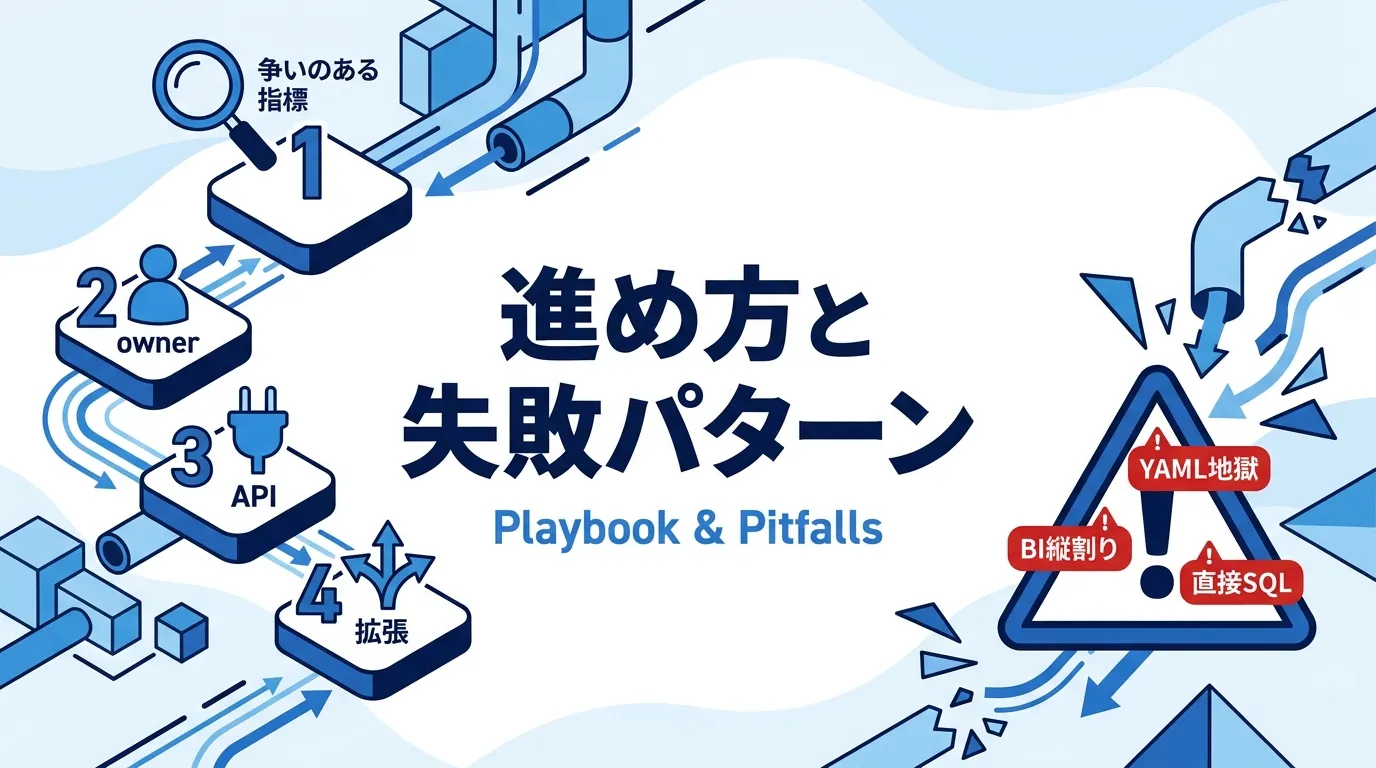
進め方:小さく始めて広げる コアKPI 10〜20指標に絞ってYAML定義から始める のが、失敗しにくい進め方です。
争いのある指標を1つ選ぶ :「部署でズレる売上」「営業と経理で違うCV数」のように、定義の齟齬が可視化されているものが最適です。ここで揃うと、投資対効果が最も見えやすいオーナーを1名決める :指標定義のPRレビュー担当者を明確にする。Ownership不明のまま増やすと、後述するYAML地獄に直行しますAPI経由でBIとAIから叩く :dbt Semantic Layer + Tableau、Cube + 社内アプリなど、2つ以上の利用側から同じ指標を呼び出して数字が一致することを確認月ごとに10指標追加 :無理せず、レビュー体制の範囲で拡張。全社の指標を一気に入れようとしない実装期間は、コアKPIに絞れば1〜3か月 が現実的な目安です。100指標を超える規模だと、6〜12か月 の中期プロジェクトになります。
失敗パターン:3つ 現場でよく見る失敗は、大きく3つに集約されます。
YAML地獄 :オーナー不明のまま指標定義を100件超まで増やしたら、PRレビューが渋滞し、「新規追加が2週間止まっている」状態に。命名規則とオーナーをYAMLコメントに明記し、指標カタログを別途Notion等で持つ運用が必要BIチームとの縦割り :セマンティックレイヤーはデータエンジニアが作り、BI開発者はTableauの計算メジャーを従来どおり書き続ける。結果、定義がまた分散する。「BIツール側の計算メジャーは新規作成禁止、既存を段階的にセマンティック層に寄せる」というルールを最初に敷くのが安全DWHに直接 Text-to-SQL する構成の並存 :AIエージェントの導入担当が別チームで、セマンティックレイヤーを経由せずDWHに直接繋いでいる。数値の食い違いを放置すると、「AIが嘘をつく」との評価が定着して信頼を失う。AIからの数値問い合わせは全てセマンティック層経由にする、と組織で決めておくEvastの現場では :セマンティックレイヤーの導入相談を受けるとき、最初にお聞きするのは「今、部署で数字が割れて困っている指標はありますか」です。ここに具体名が挙がる組織は導入がスムーズで、「特に困っていない」組織は現時点では時期尚早のことも多い。困りごとを起点にすると、レビュー体制も自然と回り始めます。
導入前の準備として、社内で使われている指標定義の棚卸しと、DWHへのデータ集約が済んでいることが前提です。まだ集約段階なら、データ基盤とは?企業が導入すべき3つの理由と構成要素を解説 やデータ基盤構築の費用相場|内訳・見積もりの取り方・コスト削減のポイント を先に参照してください。
まとめ セマンティックレイヤーは、DWHと利用側の間に置く「用語の公式辞書」です。「売上とは何か」を1度だけ定義し、BIからもAIからもアプリからも同じ数字が返る状態を作ります。
生成AIが自然言語でDWHに問い合わせる時代になり、「指標定義が揺れると、AIが自信満々で違う数字を返す」問題が一気に顕在化しました。ガートナーは2030年までにこの層が必須インフラになると予測し、Snowflake・dbt Labs・Databricksを中心に定義形式の標準化も進んでいます。
導入は、争いのある指標10〜20個からコード(YAML)で定義し、BI・AI・アプリ横断で同じ数字を返す状態を作るのが最短ルートです。DWHがまだ整っていない段階では、まず集約と加工(dbtなど)を進めるほうが優先されます。
Evastでは、BigQuery・Snowflake・dbtを軸としたデータ基盤の構築から、セマンティックレイヤーの設計・導入、AI活用の連携までを一貫して支援しています。「AIとダッシュボードで数字が違う」「社内チャットボットが変な数値を返す」といった具体の困りごとから、データ基盤構築サービス やお問い合わせ でご相談ください。