なぜ今、データカタログが必要になったのか
「AIに社内データを使わせる」という要件が、この2年で企業側の温度感を変えました。背景には次の3つの流れがあります。
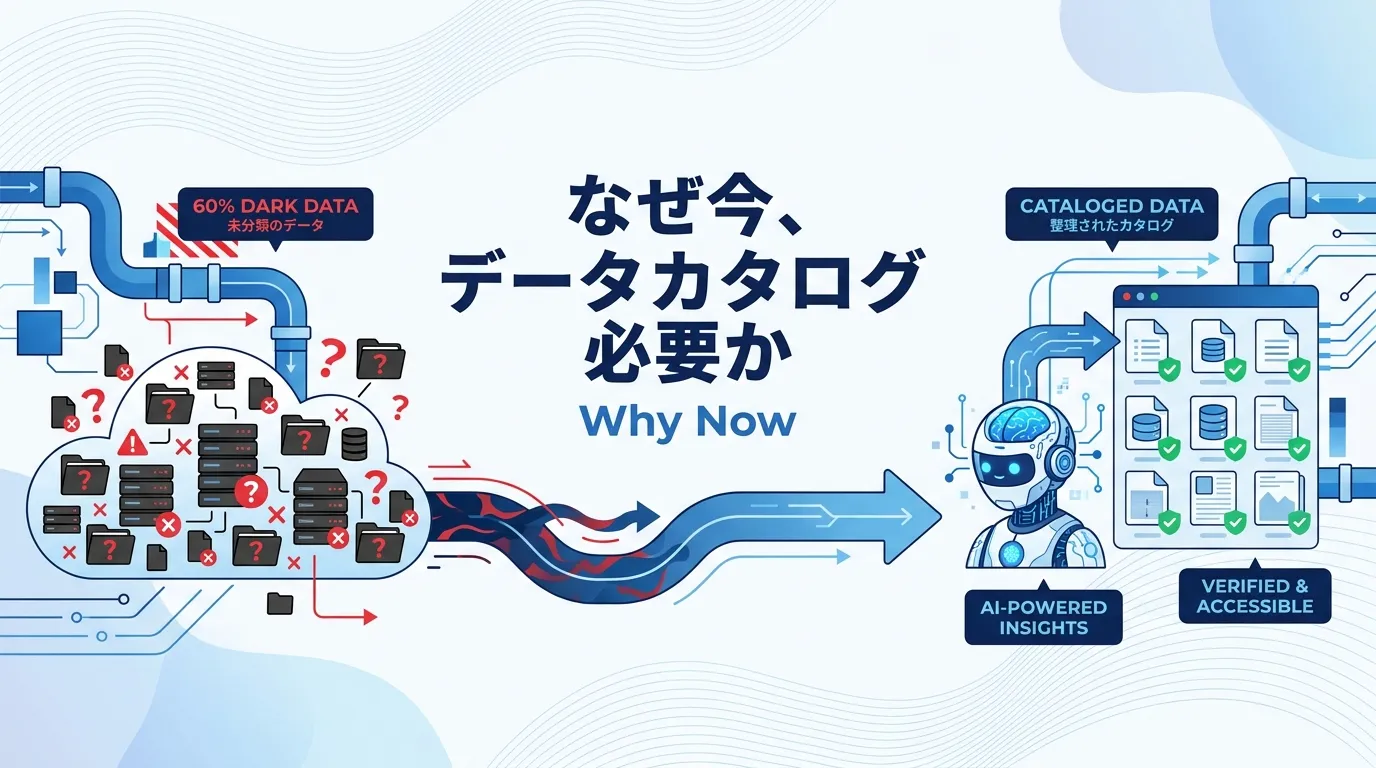
ダークデータが企業データの半分以上を占めている Splunkの2024年更新の「State of Dark Data」調査では、**回答者の60%が「自社データの半分以上はダーク(所在不明・使われていない状態)」**と答え、うち3分の1は「75%以上」と回答しています。IDCの予測でも、非構造化データは全ストレージの約78%を占め、2024年の5.5ZBから2028年に10.5ZBへ倍増 する見込みです。
つまり、多くの企業では社内データの半分以上が「あるはずだが誰も使い方を知らない」状態 で放置されています。この状態のままAIエージェントに「先月の売上を分析して」と頼めば、AIはたまたま最初に見つけたテーブルを使い、それが古いスナップショットや廃止予定のマートだったとしても気づきません。
生成AIが「意味の推測」を加速させた 自然言語からSQLを組み立てて数値を返す仕組みは、この2年で急速に一般化しました。BigQueryのGemini in BigQuery、Snowflake Cortex、Databricks Genie、Microsoft Fabric Copilotなど、主要DWHはすべてチャット窓口を備えています。
そこで露呈したのが、テーブル定義やビジネス用語の意味が整理されていないと、AIが存在しない列名や誤った結合を平気で生成する 問題です。学術研究でもText-to-SQLの実行失敗の多くが「スキーマ関連のハルシネーション」に分類されており、対策として指標定義と目録の両方を整える必要があることが明らかになっています。
姉妹記事のセマンティックレイヤーとは?AI時代のデータ活用の要 では「指標定義の食い違い」を中心に扱いましたが、その手前にある「そもそもどのテーブルが正か」を答えられる基盤 がデータカタログです。
ガートナーの評価軸が「アクティブメタデータ」に寄った ガートナーは2025年1月、データ&アナリティクス・ガバナンス・プラットフォームのMagic Quadrantを新設し、2026年1月に第2版を発行しました。旧来のメタデータ管理製品カテゴリを再編したもので、アクティブメタデータ (メタデータを継続的に解析し、品質監視・ポリシー適用・データセット推薦を自動で行う方式)とAIレディネス 、マルチクラウド/ハイブリッド対応 が評価軸の中心に置かれています。第2版では評価範囲が非構造化データ・分析モデル・データプロダクトまで広がり、AIエージェント対応やML活用の自動化が明確な評価項目に加わりました。
かつて評価対象だった「静的な目録機能」の比重は下がり、データカタログは「一覧を出すためのツール」から、AIエージェントに正しいメタデータを継続的に供給する基盤へと再定義されつつあります。
データカタログとは何か
概念だけ聞くと抽象的なので、位置と役割から入ります。
「データの図書館目録」というイメージ データカタログは、社内に散らばるデータ資産(テーブル・ビュー・ファイル・ダッシュボード・MLモデルなど)を検索できる形でまとめた目録 です。各データについて「名前・所有者・説明・タグ・データ品質・リネージ(系譜)」まで含めて管理します。
DATA SOURCES
BigQuery
Snowflake
S3 / データレイク
BI(Looker / Tableau)
DATA CATALOG
メタデータ層
目録・検索・リネージ名前・所有者・品質・PII分類
USERS
アナリスト
業務ユーザー
AIエージェント
データエンジニア
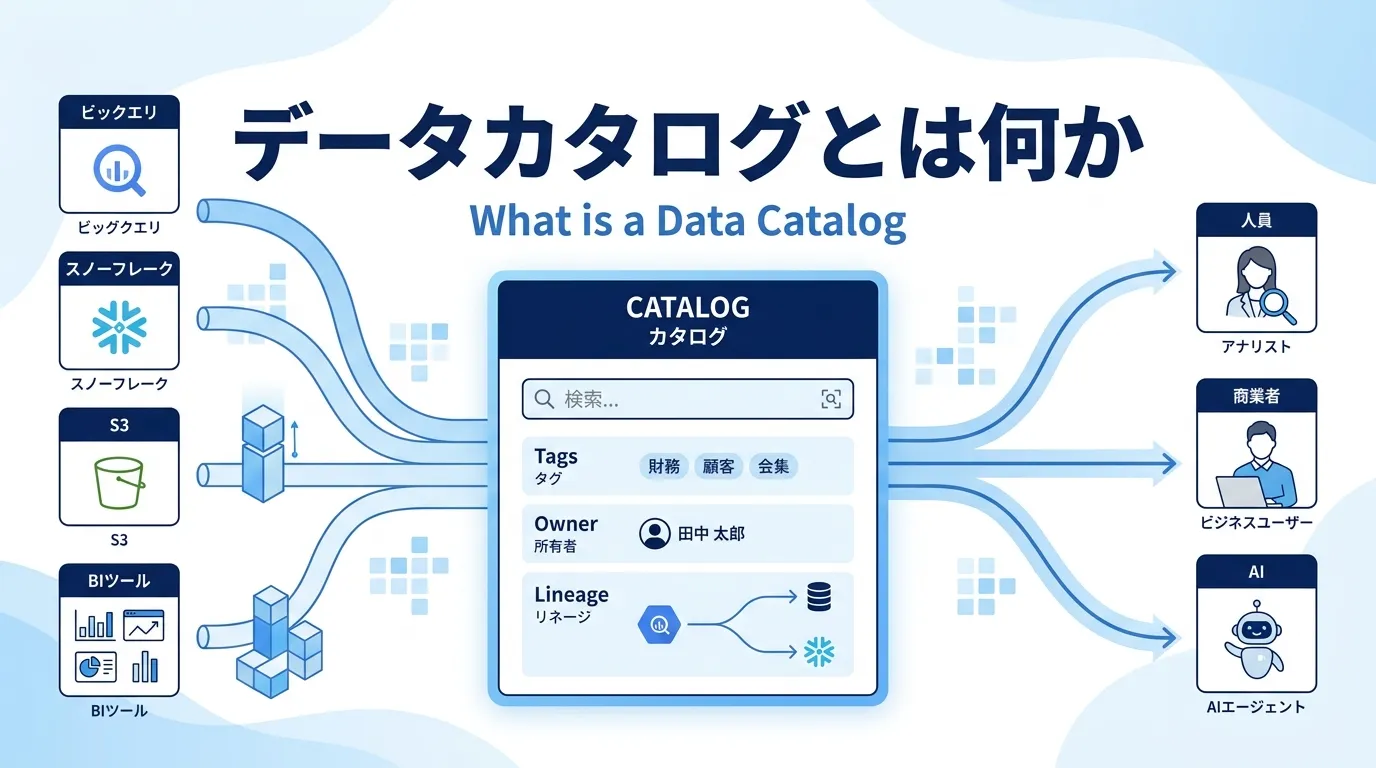
データカタログの位置:データ源からメタデータだけを集め、利用者に横断検索を提供する目録層 図のように、データカタログ自体はデータを保管する場所ではありません。BigQueryやSnowflakeといったDWH、S3などのデータレイク、Tableau・Looker StudioといったBIツール、社内アプリのRDBなどからメタデータだけを収集し、利用者が横断的に検索できる状態を作ります。
利用者は「先月の売上を集計しているテーブルはどれ?」「顧客IDというカラムを含む表を全部見せて」といった問いを、ツールを跨いで1箇所から投げられるようになります。
データディクショナリ・メタデータ管理との違い 似た用語との違いを整理しておきます。
用語 スコープ 主な形式 例 データディクショナリ 1つのデータベースに閉じたテーブル・カラム定義書 Excel、Wiki、DBMS付属機能 Oracle DataDictionary、社内Wiki メタデータ管理 メタデータを収集・標準化・活用する裏側のプロセス全体 ETLやスクリプト、ルール定義 データオーナー命名規則、PII分類 データカタログ 複数DWH/BIを横断した検索・発見のUI層 Web UI、API、AI検索 OpenMetadata、Alation、Dataplex
メタデータ管理はバックエンド、データカタログはそのフロントエンド 、と整理すると分かりやすいです。データディクショナリはさらに古い、1DBに閉じた資料の集まりで、今はデータカタログに取り込まれる形が主流です。
AI時代の3層モデル 2025〜2026年に定着しつつある企業データ基盤のAI対応モデルは、おおまかに次の3層で捉えられます。
データカタログ :どこに何があるかを見つける(メタデータ層)セマンティックレイヤー MCP 3層は独立しつつ補完し合います。カタログで「使ってよいテーブル」を絞り、セマンティックレイヤーで「用語の定義」を固め、MCPでAIエージェントに配信する。3層のどれかが欠けると、AIは古いテーブルか誤った定義のどちらかを平気で使います 。
データカタログの主要機能
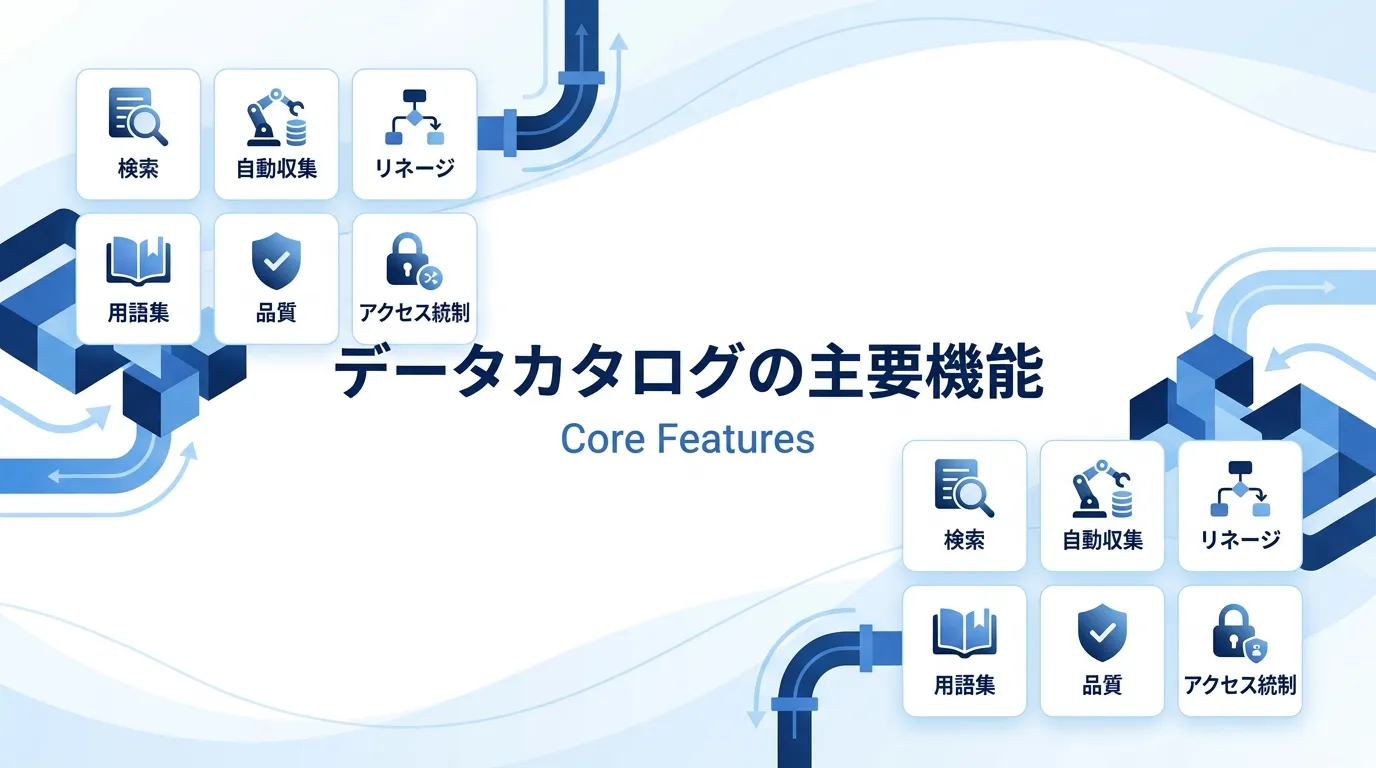
具体的にデータカタログが何をしてくれるのか、代表的な6つの機能で見ていきます。
検索・ディスカバリ
キーワード+AI検索で、テーブル・カラム・ダッシュボードを横断検索
メタデータ自動収集
DWH・BIから定期スキャン。スキーマ・利用頻度を人手なしで最新化
データリネージ
「どの生データが、どのETLを通ってこの数字になったか」を追跡
ビジネスグロッサリ
「MAU・LTV」など業務用語を1つの定義に統一し、カラムに紐付け
データ品質シグナル
Null率・更新頻度・重複件数を自動計測し、しきい値超過でアラート
アクセス統制・PII管理
個人情報カラムを自動タグ付け、マスキング・閲覧権限を一元管理
データカタログの主要機能(どのツールにも共通する6つの観点) 図の6機能はどのツールにも共通し、ツール選定時の比較観点にもなります。
検索・ディスカバリ 「顧客ID」「先月の売上」といった自然言語や部分一致で、テーブル・カラム・ダッシュボードを横断検索できます。Google検索のようなキーワード検索に加え、2025年以降は各ツールともAI検索(意味検索)を搭載し、「解約率を計算しているダッシュボードは?」といった曖昧な問いにも答えられるようになりました。
メタデータの自動収集 BigQueryやSnowflakeといったDWH、Tableau・Looker Studioなどに定期的に接続し、テーブル一覧・スキーマ・クエリ実行履歴・使われている頻度などを自動で集めます。人手でExcelを更新する運用と比べ、実態と乖離しにくいのが強みです。
データリネージ(系譜) 「このダッシュボードの数字は、どのETLジョブが、どの生データを加工して作ったのか」を辿れる機能です。障害時の影響範囲調査や、カラムの廃止判断で威力を発揮します。dbtやAirflowから吐き出されるメタデータを取り込むと、テーブル間だけでなくカラム単位の系譜まで表示されるツールが増えています。
ビジネスグロッサリ(用語集) 「MAU」「LTV」「アクティブユーザー」といった業務用語を、社内で1つの定義に統一します。定義した用語はテーブルのカラムやダッシュボードに紐づけられ、「このMAUはこの定義に沿っている」と一目で分かる状態を作れます。セマンティックレイヤーが「機械的に強制する定義」なのに対し、こちらは「人間向けの合意された定義」を扱います。
データ品質・オブザーバビリティ 各テーブルのNull率・重複件数・更新頻度といった品質指標を自動計測し、しきい値を超えたらアラートを出す機能です。Great Expectations や dbt tests と連携し、「壊れているテーブルは検索結果に出ない/注意マークが付く」といった使い方ができます。
アクセス統制・PII管理 個人情報(PII)を含むカラムを自動検出してタグ付けし、「マスキングした列だけを見せる」「特定ロールしか閲覧できない」といったポリシーを一元管理できます。個人情報保護法・GDPR対応で必須の機能です。
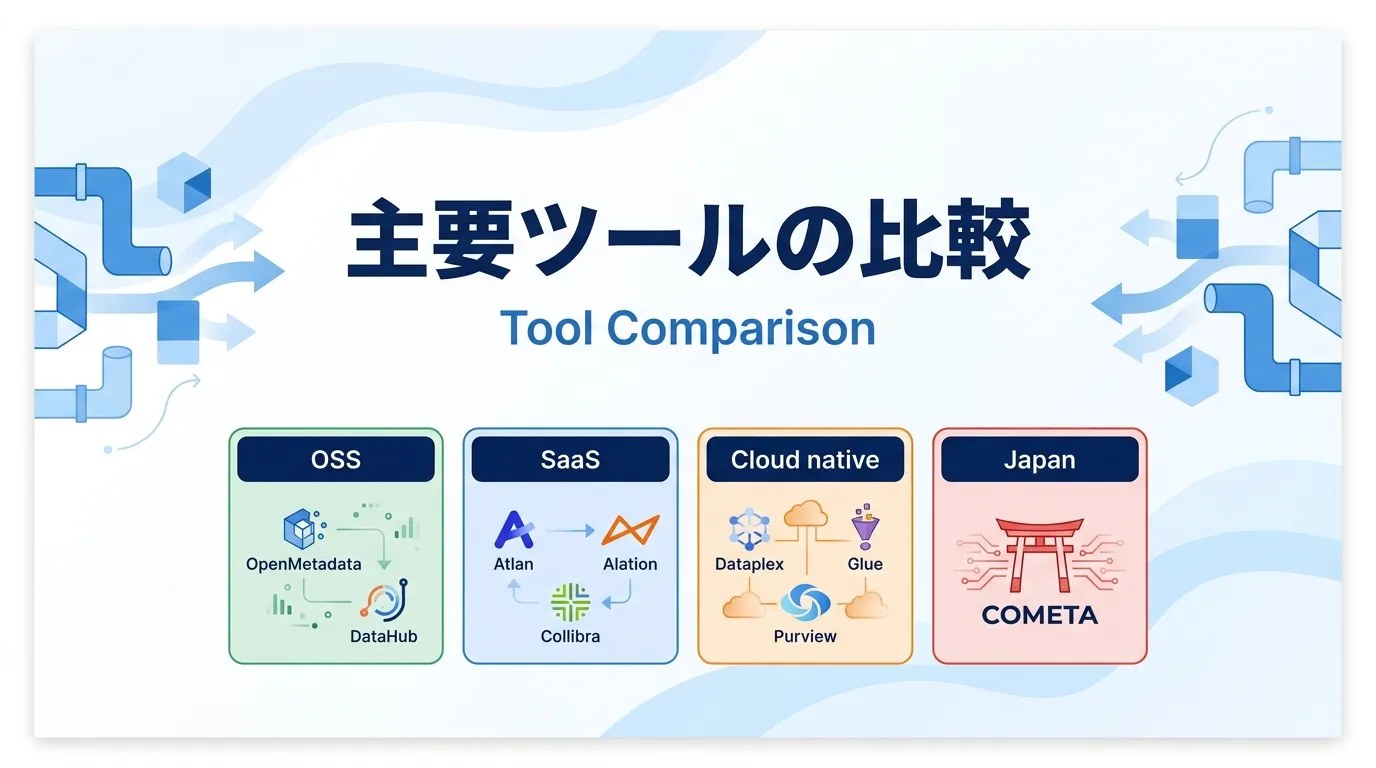
主要ツールの比較
2026年時点で選択肢に上がる主要ツールを、提供形態別に整理します。料金は各社の公表情報や業界の実勢を基にした目安で、規模・ユーザー数・追加コネクタで変動します。
OSS:まず自社で試したい場合 ツール 提供形態 料金 主な特徴 OpenMetadata セルフホスト/マネージド 無料+運用工数 統一メタデータモデル、データ品質・リネージを標準搭載 DataHub セルフホスト/マネージド 無料+運用工数 Kafka前提のストリーミング設計、GraphQL API Amundsen セルフホスト 無料+運用工数 検索・発見に特化した軽量構成、Lyftが2019年に公開したOSS
OSSを選ぶ最大の理由はライセンス費用ではなく、メタデータを自社の資産として持てる 点です。ただし年間0.25〜1人分のプラットフォームエンジニアの工数 が必要で、専任リソースを割けない企業には運用負荷が重くなります。
商用SaaS:部門横断で本格運用する場合 ツール 料金レンジ(年間・目安) 主な特徴 Atlan 中堅で数百万〜数千万円規模 モダンなUI、アクティブメタデータ設計、Slack/Teams連携が標準 Alation 数千万円規模 ガバナンスと用語集の機能が厚く、Snowflakeとの統合実績が長い Collibra 数千万円規模 ガバナンス・コンプライアンス機能が網羅的、金融・公共での導入が多い Select Star 見積(中堅向け価格帯) 自動リネージと利用状況分析が標準搭載、導入工数が軽い
商用SaaSはメタデータ管理を専任チームに任せず、業務側に定着させる仕掛け (ワークフロー、承認フロー、Slack連携など)が揃っています。本体ライセンスとは別に、実装SI費用が本体と同等かそれ以上になるケース も見込んでおく必要があります。
クラウド組込:既に単一クラウドで動いている場合 ツール 料金 主な特徴 Google Cloud Dataplex Universal Catalog (旧Data Catalog)従量課金 GCS・BigQuery・Looker横断のメタデータ統合 AWS Glue Data Catalog 100万オブジェクト/月まで無料、超過分は少額の従量課金 AWSネイティブ、Athena・EMR・Redshiftと直結 Microsoft Purview 2025年1月から従量課金モデルに移行(資産数と処理量に応じた課金) M365・Azure・ハイブリッド対応、コンプラ機能が厚い
マルチクラウドの企業がクラウド組込型を選ぶと、結局それぞれのカタログが分断されて何も解決しない 、という失敗が最も多いパターンです。単一クラウドに寄せている企業以外は、OSSか商用SaaSを検討したほうが安全です。
国内:日本語UI・伴走型で入れたい場合 COMETA(primeNumber) :日本語UIとメタデータ管理を軸にしたSaaS。2025年6月に「AIデータプラットフォーム」へ刷新し、ベータ提供していた対話型AIアシストを正式版化。メタデータ一括生成・個人情報検出も提供しています。NTTコミュニケーションズとの販売連携も発表されています。英語UIに抵抗のある業務ユーザーが多い、あるいは実装支援まで含めて日本語で対応してほしい、といった場合は国内SaaSが現実的な選択肢になります。
選定フロー Q1. データ基盤は単一クラウドか?
YES(単一)
Q2. どのクラウドを使っているか?
AWS → AWS Glue Data Catalog
GCP → Google Cloud Dataplex
Azure / M365 → Microsoft Purview
NO(マルチクラウド/複数DWH)
Q3. 専任のプラットフォームエンジニアがいるか?
YES → OpenMetadata / DataHub (OSS自社運用)
NO → Atlan / Alation / Collibra (商用SaaS)
日本語UI・伴走型が必須 → COMETA
ツール選定の分岐(自社に合う3〜4問で選択肢が絞れる) 図の分岐は「単一クラウドか」「専任エンジニアがいるか」「日本語UI必須か」の3問で選択肢を絞る、Evastの支援現場での意思決定パターンをまとめたものです。次の章のスモールスタートの考え方と併せて判断してください。
データカタログ導入のスモールスタート
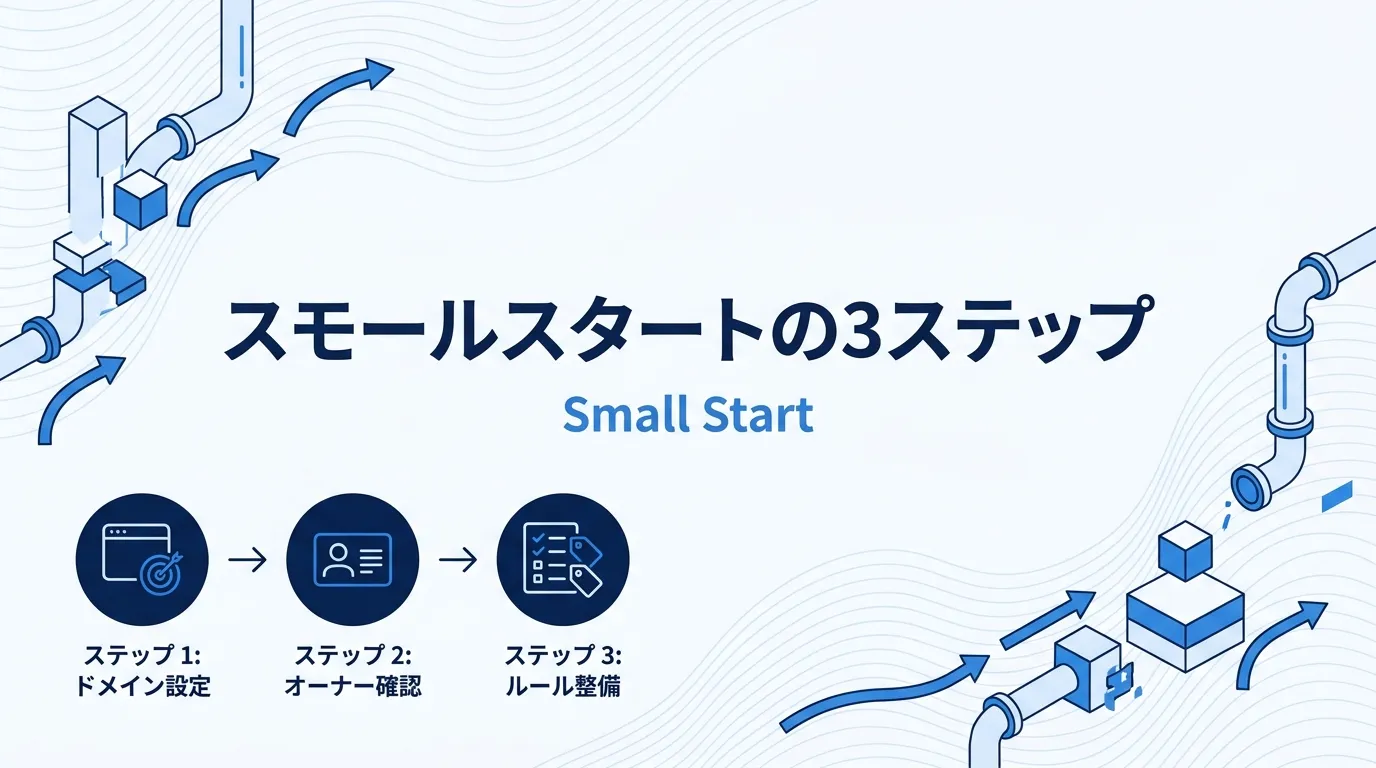
データカタログの失敗事例で最も多いのは「全社一斉展開」です。成功している企業は、次の3ステップを踏んでいます。
ステップ1:1ドメイン・1ユースケースに絞る 最初から全社データを対象にすると、オーナー不在・命名規則の合意形成に3か月 かかり、経営が興味を失って頓挫します。まずは具体的なペインを1つ 選びます。
「営業KPIダッシュボードの元データ整備」 「マーケの広告レポートで参照しているテーブルの棚卸し」 「解約分析に使うテーブルを1箇所にまとめる」 1ドメイン30〜100テーブル、期間1〜2か月 が現実的な範囲です。
ステップ2:オーナーシップを先に定義する 導入プロジェクトが止まる最大の要因は、Go-Live前にデータオーナー が決まっていないことです。テーブル/ドメイン単位で「誰が定義を維持するか」を書面化してから、収集を始めます。
オーナーは兼任で構いませんが、「回答責任者は誰か」だけは明確にしておきます。オーナーが決まっていないデータは、カタログに載せても誰も更新せず、すぐに実態と乖離します。
ステップ3:メタデータ標準と最小限のグロッサリを固める 技術的な導入の前に、次の3点を合意します。
命名規則 :テーブル名・カラム名の付け方(fact_sales_dailyなど)必須タグ :ドメイン・オーナー・機密度の3つは全テーブルに必須PII分類 :個人情報を含むカラムの識別ルールここまで固まった段階で、はじめてツール選定に入ります。ツールを先に決めてから運用ルールを後付けすると、ツール依存の運用になり、乗り換え時に一からやり直しになります。
「AIエージェント/社内ChatGPTに渡すデータの整備順序」については、社内AI・社内ChatGPTを業務で使うためのデータ準備 で導入前提の全体像を扱っています。データカタログは、その全体像の一部を占める「見つけられる状態を作る」パートに相当します。
導入でつまずくポイント
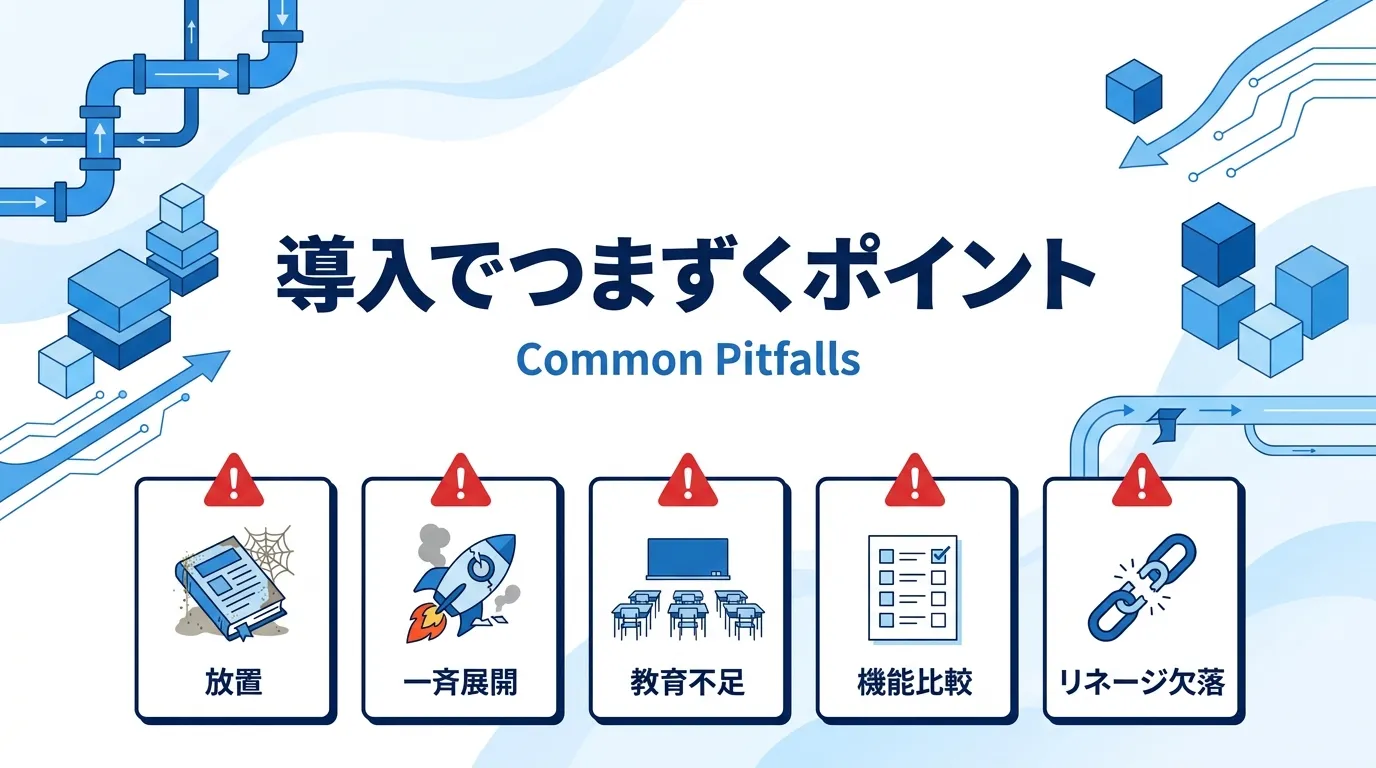
現場でよく見る失敗パターンを5つ挙げておきます。ツール選定と同じくらい、避け方の理解が大事です。
1. 「導入して終わり」で棚卸しが止まる カタログは継続的に育てる仕組み です。半年に1度の棚卸し・スチュワードシップ会議(データオーナーが集まり定義や責任範囲を見直す会)・オーナー変更フローを最初から設計しないと、Go-Live後3か月で情報が古くなり、誰も見なくなります 。
2. スコープを絞らず全社一斉展開する 前章でも触れましたが、これが失敗の筆頭です。まず1ドメインで成功事例を作り、その事例を持って次のドメインに広げる 方が、結果として全社浸透までの時間が短くなります。
3. ユーザー教育を後回しにする 高機能なカタログを入れても、業務ユーザーが検索の使い方や用語集の意味を知らなければ、採用率は10%に届きません 。データチームが部門ごとに30分ハンズオンを回すという地道な取り組みが、結局は定着の速さを決めます。
4. ツール選定を「機能比較表」だけで決める 比較表上の機能差は、実務での定着率をあまり左右しません。むしろ業務ユーザーが自分で更新できるUIか、既存のSlack/Teamsに通知を流せるか といった「使い続けられるか」の観点で判断が分かれます。PoCの段階で、必ず業務ユーザー自身に触ってもらってから決めるほうが安全です。
5. データ品質・リネージなしで「検索だけ」入れる 検索できるだけのカタログは、Excelの一覧より少し便利な程度で終わります。リネージとデータ品質のシグナル (「このテーブルは3日更新されていない」「上流のETLが失敗している」など)が出て初めて、業務ユーザーが「安心して使える/使ってはいけない」を判断できます。導入時からリネージ収集を組み込んでおくことをおすすめします。
まとめ:データカタログはAI時代の「下地」 データカタログは10年前から存在する概念ですが、生成AI・RAG・MCPが普及した2025〜2026年に、その意味合いが「あると便利な検索ツール」から「AIに社内データを使わせるための必須基盤」へと格上げされました。
大事な観点を最後に整理します。
企業データの半分以上はダーク(所在不明)で、そのままAIに渡すと誤答が量産される データカタログは「どこに何があるか」の目録層。セマンティックレイヤー(意味定義層)、MCP(配信層)と3層で補完する ツールはOSS(OpenMetadata・DataHub)/商用SaaS(Atlan・Alation・Collibra)/クラウド組込(Dataplex・Glue・Purview)/国内(COMETA)から、単一クラウドかマルチクラウドか、専任チームの有無で選ぶ 導入は1ドメイン1〜2か月のスモールスタート で、オーナーシップと命名規則を先に固める Evastでは、データマネジメント・データガバナンスの設計から、データカタログの選定・PoC・伴走運用までを支援しています。「AIに社内データを使わせたいが、まず何から手を付けるべきか分からない」という段階からのご相談も歓迎です。
詳しくはデータマネジメント支援サービス のページをご覧ください。
参考文献 Gartner, “Magic Quadrant for Data and Analytics Governance Platforms” (初版2025年1月/第2版2026年1月) Splunk, “The State of Dark Data” (2024年更新版) IDC, “Global DataSphere and StorageSphere Forecast” (2024) Atlan, “Data Catalog for AI: Capabilities, Uses & Tooling in 2026” (2026) Atlan, “Active Metadata: The Complete 2026 Guide” (2026) Microsoft Learn, “Microsoft Purview Data Governance Pricing Announcement” (2025年1月) AWS, “AWS Glue Pricing” (2025) primeNumber, “COMETAをAIデータプラットフォームへ刷新” (2025年6月) Secoda, “Mistakes To Avoid When Creating a Data Catalog” (2024年更新版)