保険業界のデータ活用が難しい構造的な理由 保険業でデータ活用が特に大変なのは、他業種と比べても「契約の時系列の長さ」と「チャネル・部門のばらけ方」の両方が極端だからです。まず、この構造から見ていきます。
1社ぶんのデータ源
契約管理 被保険者・契約・保険料査定・引受 申込・診査・格付支払・請求 給付金・保険金・事故代理店 専属/乗合/銀行窓販コールセンター 問合せ・解約申出Web/アプリ マイページ・見積×
=
経営の負荷
損害率・継続率
FISC安全対策基準
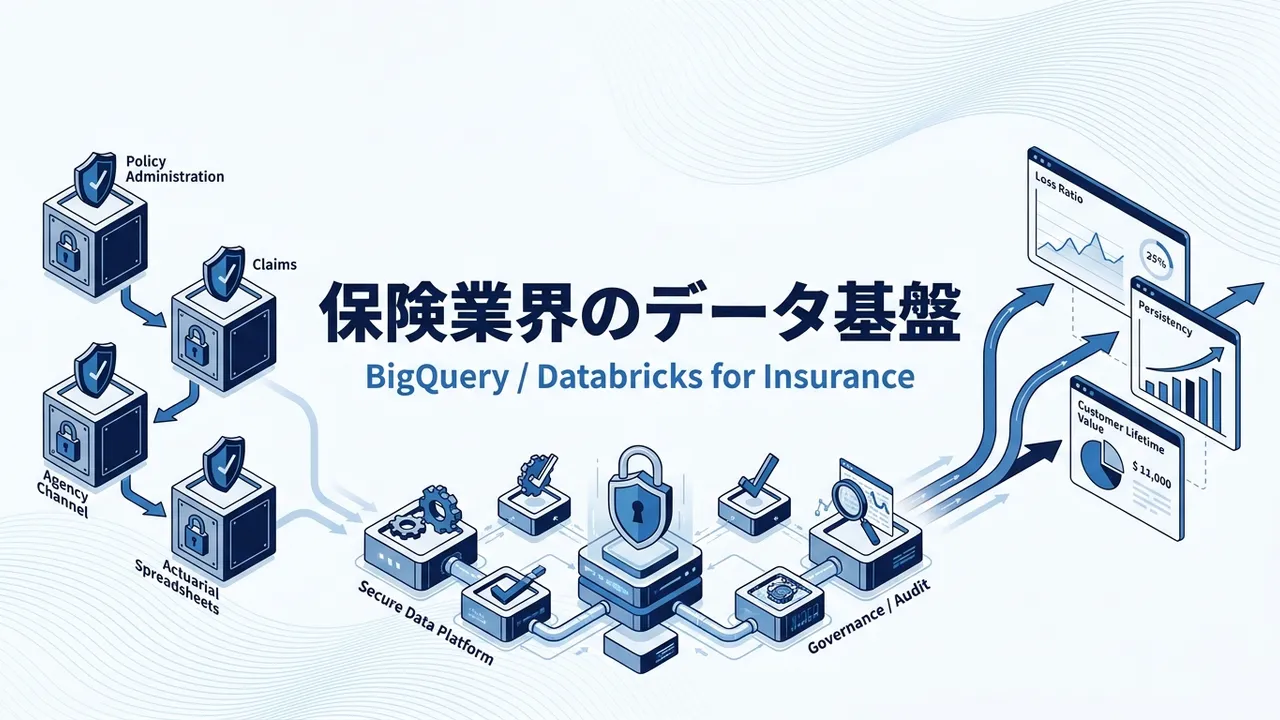
1社ぶんの保険データは契約・査定・支払・代理店・コールセンター等に分散し、要配慮個人情報(既往症・診断書)として扱いも厳しい。生保は数十年の時系列、損保はチャネル×商品×事故種別の掛け算で経営指標が追いきれない 図のように、1社が扱うデータは複数のシステムに閉じ込められています。
契約管理システム :被保険者・契約者・保険料・特約構成。生保は数十年ぶんの履歴を持つ査定・引受システム :申込書・診査結果・格付・保険料算出支払・請求システム :給付金・保険金・事故受付(損保は事故処理システムが別)代理店システム :専属/乗合/銀行窓販/来店型ショップの成績・手数料コールセンター・CRM :問合せ履歴・解約申出・苦情・満期案内Web/アプリ :マイページ・見積シミュレーション・オンライン申込これが1社ぶんです。損保では自動車・火災・傷害・新種の種目ごとにさらに事故処理システムが分かれ、生保では終身・医療・がん・変額といった商品カテゴリごとに契約管理の内部構造が異なるケースもあります。ここが保険業特有の「掛け算のつらさ」です。
さらに厄介なのが、次の3点です。
契約が数十年にわたって残る のが生保の特徴です。1980年代に契約された終身保険がいまも現役で、当時のシステム設計・データ項目のまま現行システムに引き継がれています。過去の契約変更・特約追加・料率改定の履歴を正しく再現しないと、真の継続率も、真の利益率も出せません。データ基盤に取り込む段階で、時点管理の設計(バイテンポラルデータや履歴テーブル)を初手で入れないと後で高くつきます 。
要配慮個人情報を大量に扱う のは生損保共通の前提です。既往症・診断書・健康診断結果・傷害の状況などは、個人情報保護法における要配慮個人情報にあたり、取得・利用・第三者提供のすべてに厳しいルールがかかります。基盤に持ち込む段階から、契約管理・査定・支払の各業務目的の範囲内で使うのか、分析・モデル学習にも回すのかを明確に分けておかないと、後で利用目的の追加同意で立ち止まります。
FISC安全対策基準と金融庁監督指針 という金融業特有の統制が上乗せされます。FISCの安全対策基準は2026年3月に第14版が公表され、クラウド利用時の統制項目やゼロトラストの考え方に加えて、AI・生成AIの安全対策や耐量子計算機暗号(PQC)への移行までが視野に入りました。金融庁の保険会社向け総合的な監督指針も毎年改定されており、システム統合リスク管理や外部委託先管理の要件は年々細かくなっています。ITとしての技術要件の前に、「誰が承認したか」「監査で立証できるか」の証跡設計が必要です。
私見ですが、こうした構造を踏まえずに「AIで解約予兆検知」「BIで代理店ダッシュボード」といったツール導入から入ると、ほぼ確実にPoCで止まります 。順序を間違えないことが、この領域では特に効いてきます。
2026年に押さえるべき法規制・監督指針 保険業のデータ基盤を設計するときの拠り所は、大きく3つあります。いずれも2026年に入ってから改定・成立したばかりで、数年前の常識のまま設計を進めると内部監査・金融庁検査で引っかかります。
FISC 安全対策基準・解説書 第14版(2026年3月公表) 金融情報システムセンター(FISC)が公表する、金融機関のシステム安全対策の実務基準です。クラウドサービス利用時の統制項目やゼロトラストの考え方は第10版(2022年12月改訂)の時点で整理されており、2026年3月に公表された第14版では、AI・生成AIの安全対策、耐量子計算機暗号(PQC)への移行、システム障害対応の高度化などが加わりました。基準そのものは法令ではありませんが、金融庁の監督指針や検査マニュアルが実質的に参照するため、生損保はほぼ全社が準拠を前提に設計しています。
AWSは金融機関向けリファレンス、Google Cloudは日本の金融機関向けの利用リファレンス、Microsoft Azureは金融機関向けアーキテクチャガイドを、いずれも公表・更新しています。対応済みクラウドの選択肢は広がっており、クラウドを外して考える理由はほぼありません。
金融庁「保険会社向けの総合的な監督指針」 保険会社の業務運営全般に関する監督指針で、システム統合リスク管理・外部委託先管理・情報セキュリティ管理の各章がデータ基盤設計に効いてきます。直近では2026年7月17日に一部改正が公表され、金融分野のサイバーセキュリティに関するガイドライン(2024年10月公表)との整合を前提に、インターネット取引を含むサイバーリスク対応の要件が大きく強化されました。クラウド活用時のリスク評価と経営陣関与に求められる水準も、数年前とは別物になっています。
「情シスに任せてある」で通らなくなった、というのが現場感覚に近いです。
改正個人情報保護法(2022年施行・2026年7月に再改正が成立) 被保険者から取得する既往症・健康診断結果は要配慮個人情報として扱う必要があります。加えて、2022年施行の改正で漏えい報告・本人通知の義務化、越境移転時の情報提供、仮名加工情報の枠組み整備などが入りました。
さらに、3年ごとの見直しを経た改正法が2026年7月10日に成立し、同月17日に公布されています。統計作成目的での同意例外の緩和といったデータ利活用側の緩和と、顔特徴データなど生体情報の規律新設・課徴金制度の導入といった規律強化が同時に入った改正で、罰則関係は公布から6か月後、その他は公布から2年以内(遅くとも2028年7月)の施行 です。分析利用を見据えるなら、この施行までに利用目的と同意文言の棚卸しを終えておくのが現実的なスケジュールになります。
押さえどころは「業務利用」と「分析利用」の分離 FISC・監督指針・個情法を通読すると細かい要件は多岐にわたりますが、実務で最初に決めるべきは1点だけです。基盤上のデータを、契約管理・査定・支払といった業務そのものに使うのか、それとも解約予兆モデルや損害率分析といった分析目的まで含めるのか 、この線をはっきり引くことです。
業務利用に閉じる範囲は、既存の業務規程・契約約款・利用目的の範囲内で概ね進められます。分析・モデル学習まで踏み込むなら、契約時の同意文言の見直しと、要配慮個人情報を含まない加工データでの分離運用を、基盤設計の初手で組み込む必要があります。
データ基盤構築の3つのアプローチ 保険業でデータ活用を進めるときの選択肢は、大きく3つに整理できます。それぞれ費用と柔軟性のトレードオフがあります。
① 契約管理SaaS付属のBI保険基幹・代理店システム標準機能
単一システム内で即導入 保険料・解約数など標準指標のみ 複数チャネル横断や事故連携は不可 初期 0〜100万円+月5〜20万円/導入1〜4週間
→
② 既存BIとCSV/API連携Looker Studio・Tableau
契約・支払・代理店CSVを日次連携 始めやすいが属人化しがち 時系列の突合はスキーマ設計に依存 初期 300〜800万円+月数万〜十数万円/4〜8週間
→
③ FISC対応クラウドDWHBigQuery / Snowflake / Databricks
契約×査定×支払×代理店を横断 フロード検知・継続率MLまで拡張 金融庁監督指針に沿った統制と整合 初期 800〜2,500万円+クラウド利用料/4〜8週間で最初の運用
保険業界のデータ活用3アプローチ。中堅保険会社や大手代理店で損害率・継続率・引受・不正検知まで一気通貫で扱うなら、FISC安全対策基準に沿ったクラウドDWH(③)が総額を抑えやすい ① 契約管理システム・代理店システム付属のBIオプション 保険基幹システムや代理店管理システムのベンダーが提供する追加モジュールを使う方式です。同一システム内なら追加設定で導入でき、契約件数・保険料収入・解約件数・代理店成績といった業界標準のレポートは最初から揃っています。
初期0〜100万円、月5〜20万円、導入1〜4週間 が相場です。ただし、複数の保険会社の契約を扱う乗合代理店や、生保と損保を併営するグループ会社では、単一システムの提供範囲を超えられません。単一チャネル・単一商品カテゴリで見たいだけならこの選択が最短ですが、あとから拡張しようとすると別方式との二重構築になりがちです。
② 既存BIツールとのCSV/API連携 Looker Studio、Tableau、Power BIといった汎用BIツールに、契約管理・代理店・支払システムのCSVエクスポートやAPI出力を流し込む方式です。日次バッチで前日の実績を集計する用途に向きます。
初期300万〜800万円、月数万〜十数万円、4〜8週間 が目安です。始めやすい反面、契約変更や特約追加の履歴を正しく突合する設計が甘いと、月末に数字が合わないという事象が頻発します。属人化しやすいのもこの方式の弱点で、担当者の異動で保守が止まる例は珍しくありません。
③ FISC対応クラウドDWHで専用データ基盤を構築 Google Cloud(BigQuery)、AWS(Redshift)、Snowflake、DatabricksといったFISC対応のクラウドDWH・レイクハウス上に、専用データ基盤を作る方式です。契約・査定・支払・代理店・コールセンターを横断でき、将来のフロード検知モデル、継続率予測、ヘルスケア連動保険まで拡張できます。
初期800万〜2,500万円、クラウド利用料が月数十万円〜、4〜8週間で最初の運用に入る のが中堅保険会社の標準です。大手生損保がグループ全体で基幹連携まで含めて統合する場合は初期3,000万〜1億円規模 となりますが、この場合はDatabricks Lakehouseで基幹の未加工データも含めて集約する構成が増えています。データ基盤の費用感と積算の考え方はデータ基盤構築の費用相場は?見積もりの内訳と判断基準を解説 で詳しく解説しています。
保険業界で効くデータ活用の5パターン 導入したあと「何を最初に可視化するか」で成否が分かれます。中堅保険会社と大手代理店で実際に効きが良かった順に紹介します。
1. 損害率(Loss Ratio)とコンバインドレシオの日次可視化 (損保)
種目別・チャネル別の損害率を、事故受付から支払までのステータス込みで日次で見せます。従来は月次締めのあとに経理から出てくる数字を待っていた損害率が、翌朝には見えるようになります。異常値が出た種目・エリアだけを引受・料率検討に即つなげられるようになるのが最大の変化点です。
2. 継続率(Persistency Rate)と解約予兆モデル (生保)
契約継続率を月次・年次で追いつつ、コールセンターの問合せ内容・マイページの操作履歴・営業担当からの接触履歴を組み合わせて、解約リスクの高い契約を早期に抽出します。1〜2ポイントの継続率改善が年数億円の収入インパクト になる領域で、投資回収の説明がしやすいテーマです。
3. アンダーライティング(引受)の意思決定支援
過去の引受判断と実際の支払実績を突き合わせて、料率設定や引受基準の妥当性を検証します。既往症・診査結果・年齢・地域といった変数と、支払発生率・支払金額の関係をモデル化する下地になります。ヘルスケア連動保険(バイタル連携)を持つ会社では、保険期間中のヘルスデータも変数に加わります。
4. フロード検知(不正請求検知) (損保が中心、生保でも医療保険で)
過去の請求データから不正パターンを学習し、新規請求のスコアリングに使います。事故直後の請求集中、修理工場・整形外科など特定チェーンでの多発、複数保険会社への同時請求といった特徴量が典型です。DatabricksのようなML統合基盤で本領を発揮するユースケースで、単体で年数千万円〜数億円の削減効果 を狙えることもあります。
5. 代理店ポートフォリオ分析
専属・乗合・銀行窓販・Webそれぞれのチャネルで、契約後の継続率・支払発生率・平均保険料を並べます。手数料水準の設計、優良代理店の見極め、乗合先の見直しといった経営判断の材料になります。乗合代理店の側から見ても、扱っている保険会社ごとの手数料集計と実質利益の見える化が可能になります。
このあたりのデータ品質を継続的に監視する仕組みとしては、データオブザーバビリティとは?データ品質監視の5つの柱と始め方 で扱っている監視項目の考え方が、保険業でも同じく効いてきます。
4〜8週間で始めるスモールスタート いきなり要配慮個人情報を含む本格基盤から始める必要はありません。保険業の場合、以下の順序で段階的に立ち上げるのが安全かつ現実的です。
1週目:スコープ確定と社内合意
対象システム(契約管理・支払・代理店のうちどれか)、対象商品(主力の1〜2商品)、対象データ(要配慮個人情報を含む/含まない)を最初に絞ります。個人情報保護管理者・情報セキュリティ管理責任者への説明と、システムリスク管理委員会への付議もこの週で終わらせます。
2〜3週目:接続と初期構成
契約管理システムのCSV日次エクスポートと、支払システムのAPI、代理店システムの月次ファイルを、FISC対応クラウドのストレージに連携します。この段階では被保険者ID・契約IDをハッシュ化して基盤に入れる設計にしておくと、後から分析利用の議論が出たときの選択肢が広がります。
4〜6週目:ダッシュボード実装と運用リハーサル
損害率、種目別新契約、代理店別成績、事故処理リードタイムといった経営指標のダッシュボードをLooker StudioやTableauで実装します。取締役・部門長・支社長・代理店マネージャーといった利用者ごとに閲覧範囲を分け、監査ログが機能することを確認します。
7〜8週目:本番運用切替と体制引き継ぎ
Excel運用・既存レポートと並行運用したうえで、月次締めのタイミングで切り替えます。この段階で、解約予兆モデルやフロード検知など、追加のユースケースが現場から出てきたら、次のフェーズとして計画します。
集計値レベルまでで完成させると、要配慮個人情報を扱わない範囲でデータ活用の土台ができます。ここから被保険者・契約単位の分析、ヘルスケア連携、外部データ活用に進むかは、成果と体制を見ながら判断します。
よくある失敗パターン 保険業のデータ基盤構築で頻出する失敗を3つだけ紹介します。
基幹刷新のついでに基盤も、で頓挫する 契約管理システムのリプレースは5〜10年に一度の大型プロジェクトで、ベンダー主導・社内負荷が最大化するタイミングです。同時にデータ基盤の話を進めると、基幹選定が優先されて基盤の要件が後回しになり、結局ベンダー付属BIの範囲で妥協することになります。データ基盤は基幹のリプレースとは切り離し、既存基幹からの抽出を前提に別トラックで進める ほうが結果的に速いです。
時点管理を後から入れようとする 保険は契約変更・特約追加・料率改定が頻繁で、いつ時点の契約情報かを常に意識しないと数字が合いません。基盤設計の最初に時点管理(バイテンポラルデータや履歴テーブル)を組み込まないと、あとから遡って再構築することになり、費用と工期が2倍3倍に膨らみます 。とくに生保では、20年後の照会にも耐える設計を初手で入れておく必要があります。
分析利用の同意設計を後回しにする 基盤の設計と実装が終わってから「実は解約予兆モデルにも使いたい」となると、既に取得した情報の利用目的追加が困難で、契約者への再説明と再同意取得が発生します。基盤設計の最初の週に、業務利用に限るか分析利用まで想定するかを経営会議レベルで決めておく必要があります。
このあたりの構造は業種を問わずに共通する部分もあり、データ基盤構築でよくある失敗パターン やExcelから脱却してデータ基盤に移行する進め方 も併せて参考にしてください。
まとめ:段階設計と時点管理が総額を決める 保険業のデータ活用は、他業種の「ツールを買って集計を自動化する」発想とは前提が違います。契約が数十年続く時系列を正しく扱うこと、要配慮個人情報を大量に扱うこと、FISC安全対策基準と金融庁監督指針への準拠が必須であることの3つが、設計と契約と体制のすべてに影響します。
ただし、慎重に段階を踏めば決して手が届かない領域ではありません。まず経営会議向けダッシュボードから始めて、要配慮個人情報を扱わない範囲でデータ活用の型を作る。次に解約予兆・フロード検知・代理店分析といった被保険者・契約単位のユースケースに進む。最後に、必要があればヘルスケア連携や外部データ活用に踏み出す。この順序を守るだけで、頓挫リスクが大きく下がります。
データ基盤を組織で根付かせるための土台については、なぜ今データマネジメントが必要か?2026年DX成果を分ける4つの要点 で詳しく整理しています。
Evastでは中堅保険会社・大手保険代理店向けに、FISC対応クラウド上でのスモールスタート型データ基盤構築と、要配慮個人情報の同意設計・時点管理の設計支援を行っています。既存の契約管理・代理店システムを活かしたまま、経営会議向けダッシュボードから段階的に立ち上げるご相談は、下記からお気軽にお問い合わせください。
→ データ基盤構築サービスを見る
→ データマネジメント支援を見る