
 データマネジメント
約13分
データカタログとは?AI時代に必須な理由と主要ツール比較【2026年版】
データカタログとは、社内に散らばるテーブルやダッシュボードを検索できる目録です。生成AI時代に必須となった理由、OpenMetadata・Atlan・Dataplexなど主要ツールの費用(年無料〜7,000万円)、PoC1〜2か月で始めるスモールスタートの手順を整理します。
データマネジメントデータカタログとは、社内に散らばるテーブルやダッシュボードを検索できる目録です。生成AI時代に必須となった理由、OpenMetadata・Atlan・Dataplexなど主要ツールの費用(年無料〜7,000万円)、PoC1〜2か月で始めるスモールスタートの手順を整理します。
 データ基盤
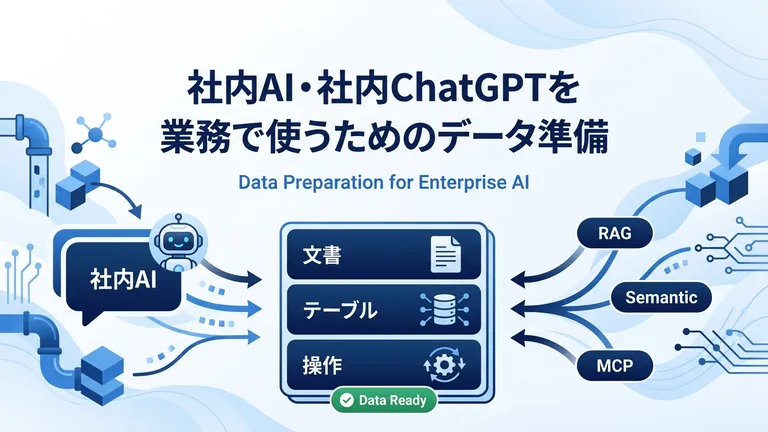
社内ChatGPTを入れたのに現場で使われない、というのはほぼ確実にモデル選定ではなくデータ準備の問題です。この記事では、社内AIが業務で定着しない3つの症状、AIに食わせる3種類のデータと整え方、対象を絞る4ステップの進め方、費用と期間の目安、実装現場で必ず出る失敗パターン、Evastが推奨するスモールスタートまで、情報システム部・データ基盤担当・DX推進責任者向けに、発注や社内推進で使える形で整理します。
 データ基盤
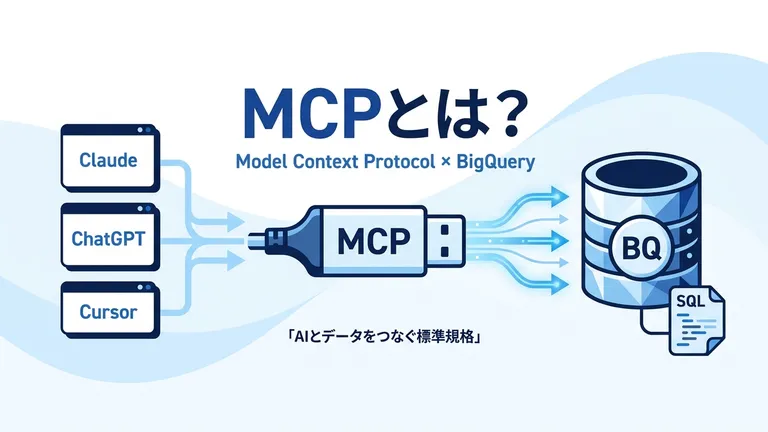
「AIに社内DBを触らせたいが、接続先ごとにAPI開発は非現実的」――MCPはこの詰まりを解く標準規格です。Google公式BigQuery MCPサーバー(2026年Preview)の機能、権限設計・SQL精度・監査ログの落とし穴、3〜5か月・100〜500万円の導入相場を実装目線で示します。
 データ基盤
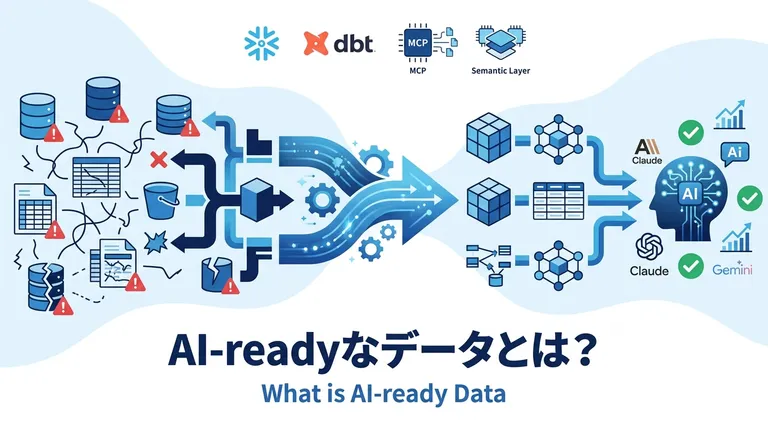
生成AIで成果が出ない原因はモデルではなくデータです。ガートナー調査では63%が「AI向けデータ整備の手法なし」と回答。AI-readyデータの5条件、BI用整備との違い、MCP時代の接続口、3〜6か月で最初の成果を出す段階的な進め方を、発注・社内推進に使える形で整理します。
 データ基盤
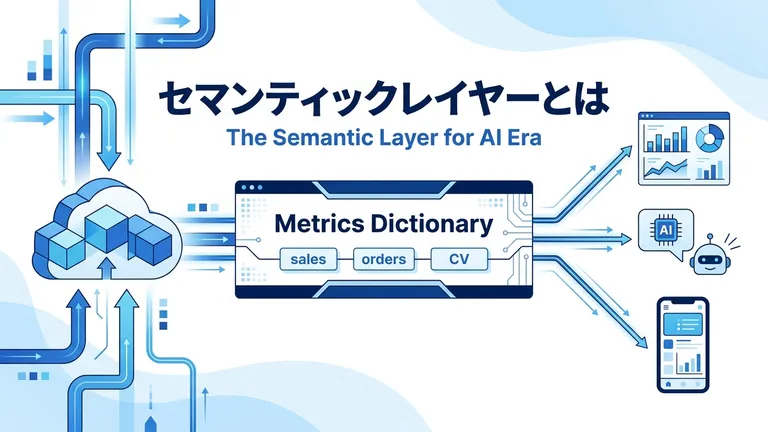
AIに聞いた売上とダッシュボードの数字が合わない——原因はモデルではなく指標定義の分散です。セマンティックレイヤーはdbt・Cube・Lookerで実装され、ガートナーは生成AIの回答精度80%改善・コスト60%削減と予測。BI閉じ型とHeadless型の違い、指標選定と導入の勘所を整理。
 データ基盤
社内AIやRAGを検討すると、構成図に必ず「ベクトルデータベース」という箱が登場します。埋め込み(エンベディング)で意味を数値化して検索する仕組み、キーワード検索との違い、RAGでの役割、Pinecone・pgvector・BigQueryなど主要製品の特徴、専用DBと既存DB拡張の選び方、導入時の落とし穴までを、非エンジニアのマネージャー向けに整理します。
 データ基盤
社内ChatGPTを入れたのに「うちの規程では」を返せない、という悩みは多くの企業で起きています。この記事では、RAG(検索拡張生成)の仕組みと構成要素、なぜ社内AIに必須なのか、実装に必要なデータ基盤・ベクトルDB・チャンク設計の要件、現場で起きる典型的な落とし穴、そして4〜8週間のスモールスタート手順まで、情報システム部・データ基盤担当のマネージャー向けに整理します。
 データ基盤
生成AIを導入しても成果が出ない、PoCで止まる。その原因の多くはモデルではなくデータにあります。日本企業がつまずく理由、AIが整ったデータを必要とする仕組み、BI向けとは違う「AIに使えるデータ」の条件、独自データが差別化を生む理由、AIの土台になるデータ基盤の全体像と始め方までを、海外の最新調査と現場目線で整理します。生成AI活用を成果につなげたいDX担当・情シス向けの実務記事です。