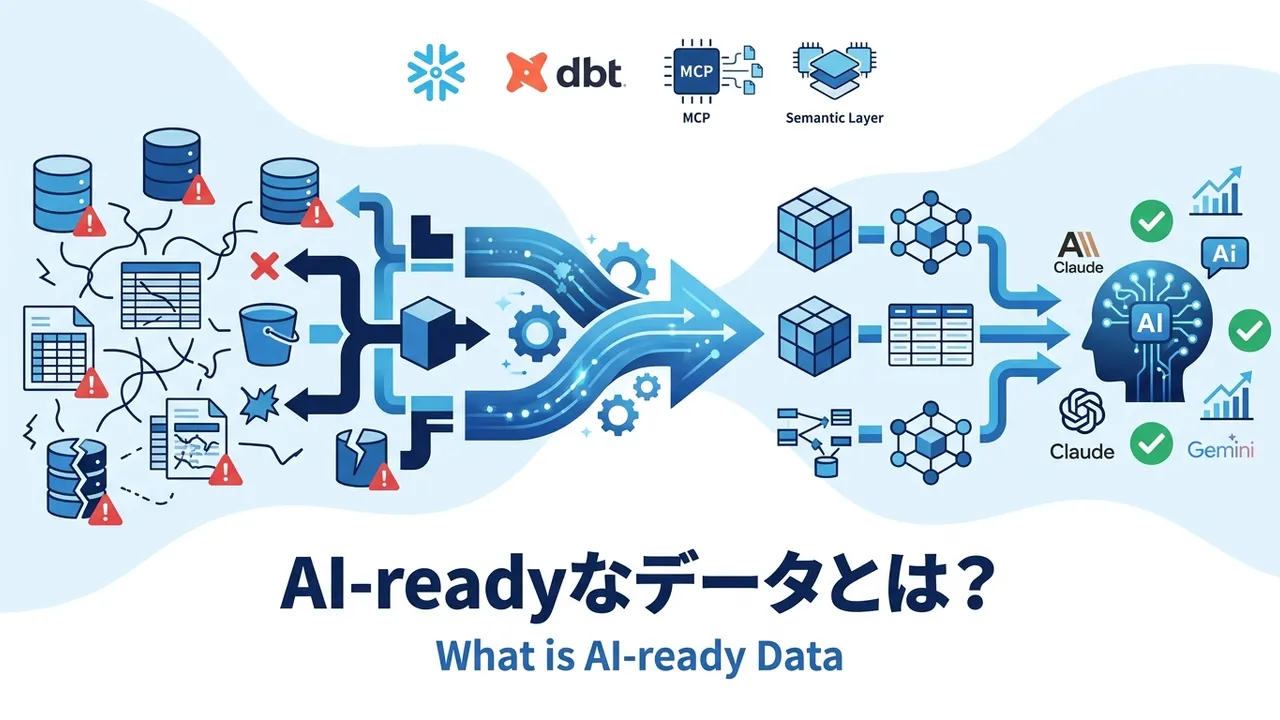
AI-readyなデータとは?「AIが直接使える状態に整えたデータ」
AI-readyなデータ(AI-ready data)とは、生成AIやAIエージェントが人手による補正なしで直接使えるように、定義・品質・鮮度・権限・接続口まで整えられたデータのことです。従来のBI(人間向けの可視化)用データ整備を土台にしつつ、AIが独りで解釈できる水準まで機械可読性を上げた状態と言い換えられます。
用語自体は2024年ごろから海外の主要ベンダーが一斉に打ち出し始めました。Snowflakeは2025年7月の公式ブログで、AI-readyデータの条件をQuality(品質)、Diversity(多様性)、Freshness(鮮度)、Governance(統制)、Discovery(発見しやすさ)の5つに整理しています。dbt Labs(Fivetranと2025年10月に合併合意、2026年6月に統合完了)は「AI-readyな構造化データの標準」を自社の位置づけとして公表し、Fusion engineとSemantic Layerで「信頼できる、統制された、ドキュメント化されたデータセット」を提供するとしています。Databricksも2025年のData + AI Summitで、自社プラットフォームを「エージェントに使わせる前提のインフラ」と再定義しました。
世界の企業でも「持てている」のは1割前後
これだけベンダーが押しているにもかかわらず、達成度はまだ極端に低い、というのが現状です。
- ガートナーが2025年2月に公表した248人のデータマネジメントリーダー調査では、63% が「AIに適したデータマネジメント手法を持っていない、または持っているかどうか分からない」と回答しました。同社は同時に、「AI-readyなデータに支えられていないAIプロジェクトの60%は2026年までに放棄されるだろう」と予測しています
- 別のガートナー調査(2025年)では、自社データが十分な品質とアクセス性を備えていると答えた組織は 12%
- クラウデラとハーバード・ビジネス・レビューの共同調査(2025年実施・2026年公表、回答230社)では、自社データが「AI導入に完全に対応できている」と答えた企業は 7%
日本市場の定量データは限られますが、DXを担う人材が「不足している」と答えた日本企業は 85.5%(IPA「DX動向2026」)で、整備の担い手そのものが枯渇しています。裏を返せば、いまAI-readyデータの整備に手を付ければ、競合と差がつきやすい局面ということでもあります。
なぜここまでAI活用の成否がデータで決まるのか、全体像はなぜAI時代にこそデータ基盤が必要か|生成AIが失敗する理由で解説しています。本記事はその中で触れた「AIに使えるデータの条件」を、実装レベルまで踏み込んで整理する位置づけです。
AI-readyなデータの5つの条件
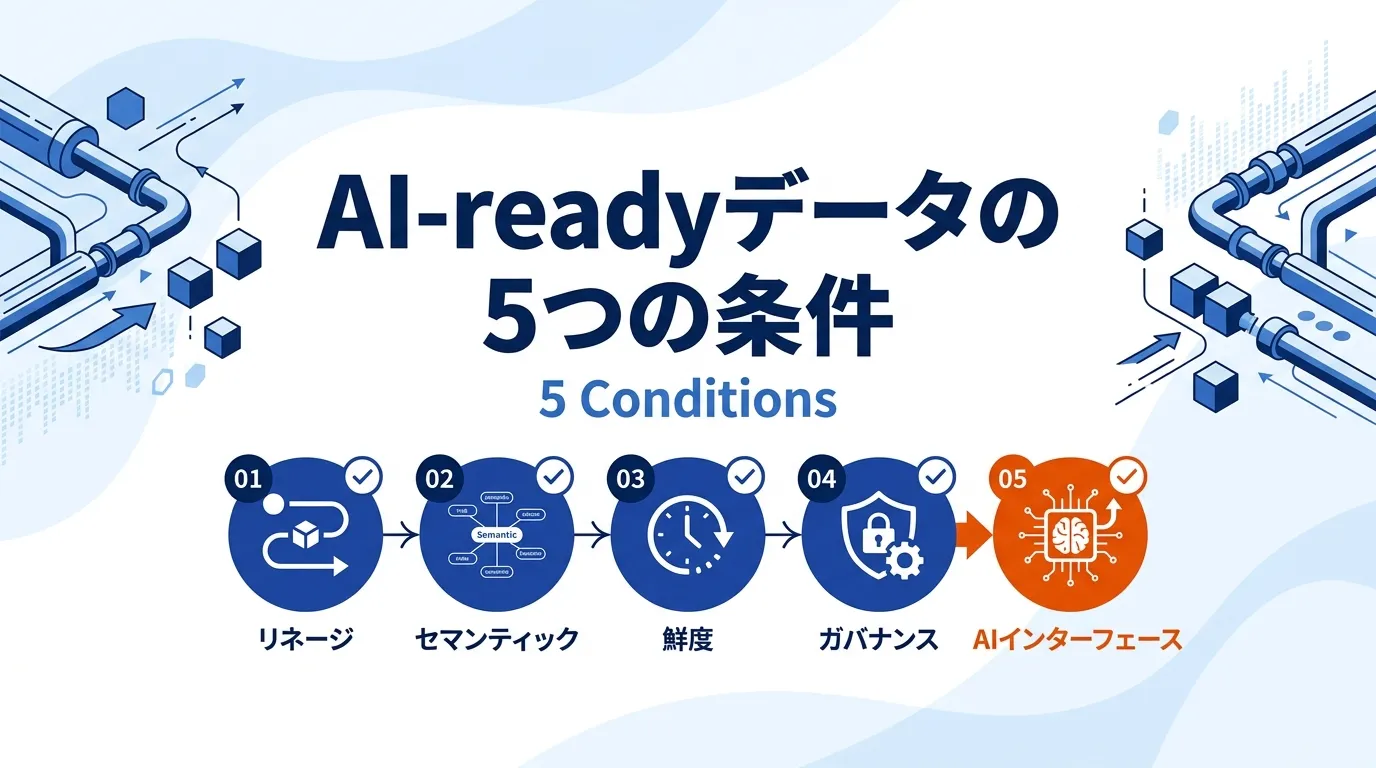
AI-readyデータの条件は、ベンダーごとに5〜6項目を挙げますが、本質はほぼ同じです。Evastの現場で発注前チェックに使っている枠として、次の5つに整理します。土台の4つと、AIから使わせるための1つ、という組み合わせです。
01
来歴
Lineage
このデータはどこから来て、どう加工されたか
ETL/dbt/リネージツールで自動記録
02
意味
Semantic
「売上」の定義は社内で1つに揃っているか
セマンティックレイヤー / データカタログ
03
鮮度と品質
Freshness & Quality
いつ時点のデータか、壊れていないか
データ可観測性 / dbt tests
04
アクセス制御
Governance
誰が何を見てよいかがAI問い合わせ時に効くか
行列レベルセキュリティ / RBAC
05
AI用インターフェース
AI Interface
AIエージェントが直接叩ける口があるか
MCPサーバー / Cortex Analyst
土台となるデータ整備の観点 AIから使わせるための接続の観点
図の各条件を、実務で見るポイントに落として補足します。
条件1: 来歴が分かる(Lineage)
このデータはどこから来て、途中でどう加工されたかが、コードとメタデータで追える状態です。AIが「たぶんこの数字」で答えるとき、根拠になる元データがどこにあるかを人間が遡れないと、間違いに気づけません。
技術的にはETL/ELTジョブ、dbtのモデル依存、リネージツール(OpenLineage、DataHub、Collibra、troccoなど)で自動収集します。国内ではprimeNumberのtroccoが2025年にView定義SQLを解析してカラム単位のリネージを自動生成する機能を追加するなど、ノーコード寄りの選択肢も増えました。データを運ぶ処理そのものの設計はデータパイプラインとは?設計の3軸と運用の要点を図解で解説で、DWHへの集約の考え方はDWH(データウェアハウス)とは?データレイクとの違いと選び方で扱っています。
条件2: 意味が1つに統一されている(Semantic)
「売上」「稼働率」「有効顧客」といった指標が、社内で1つの計算式・粒度に揃い、AIが問い合わせるたびに参照できる状態です。ここが崩れると、部署ごとの定義違いがAIの回答にそのまま混ざります。
実装では、dbtのメトリクス定義、Cube、LookMLなどのセマンティックレイヤー、あるいはSnowflakeが2025年4月にプレビュー公開したSemantic Viewsのようなプロダクトを使います。dbt LabsがFivetranと2026年に統合してAIエージェント向け基盤を掲げたのも、この「意味の統一」を扱う層の重要性が背景にあります。ダッシュボードごとに定義がズレている企業では、まずここを揃えるのが第一歩です。
条件3: 鮮度と品質が継続監視されている(Freshness & Quality)
「このデータはいつ時点のものか」が保証されていて、件数・欠損・分布などが常時監視され、異常があれば人より先に気づける状態です。人間が見るBIでは「なんとなく数字が変」と気づけますが、AIは気づかず答えてしまいます。
具体策としては、dbt testやdbt source freshnessに加え、Great Expectations、Elementary、Monte Carlo、Anomalo、Metaplaneといったデータ可観測性ツールの導入が主流になりました。Great Expectationsは2025年2月に「ExpectAI」をGX Cloudへ追加し、AIが期待値そのものを自動生成できるようになっています。詳しい選び方や5つの監視観点はデータオブザーバビリティとは?データ品質監視の5つの柱と始め方で整理しています。
条件4: 問い合わせ時にアクセス制御が効く(Governance)
誰がどのデータを見てよいかが、AIエージェントの問い合わせの瞬間に、行や列のレベルで強制される状態です。ここが甘いと、営業からの問い合わせに対して人事評価データが混ざる、といった事故が起きます。
技術的にはDWHの行列レベルセキュリティ、ロールベースアクセス制御(RBAC)、動的マスキングを、認証情報を持ったユーザー単位でAIエージェントの呼び出しに引き継ぐ設計が必要になります。共通のサービスアカウント1つでAIに叩かせる、という古い設計は、AI時代には破綻します。この論点は日本市場ではまだ議論が浅く、Chad Sandersonらが提唱するデータ契約(Data Contracts)の考え方や、Snowflake OpenflowのようなBYOC対応のプロダクトが2025年以降注目され始めた段階です。
条件5: AIから使える口が用意されている(AI Interface)
これは従来のデータ整備にはなかった、AI時代ならではの新しい条件です。整えたデータをAIエージェントから安全に叩ける、標準化されたインターフェースが用意されているか、という観点です。
具体的には、Snowflakeが2025年11月にマネージド版を一般提供したMCPサーバー、2026年1月にGoogle Cloudが発表したBigQueryフルマネージドMCP、SnowflakeのCortex Analyst、SemanticビューをそのままAIに公開できる仕組みなどが該当します。次のセクションで詳しく扱いますが、この層を持てるかどうかで、同じAI-readyデータでも活用の広がり方が大きく変わります。
AI-readyデータとBI向け整備の違い
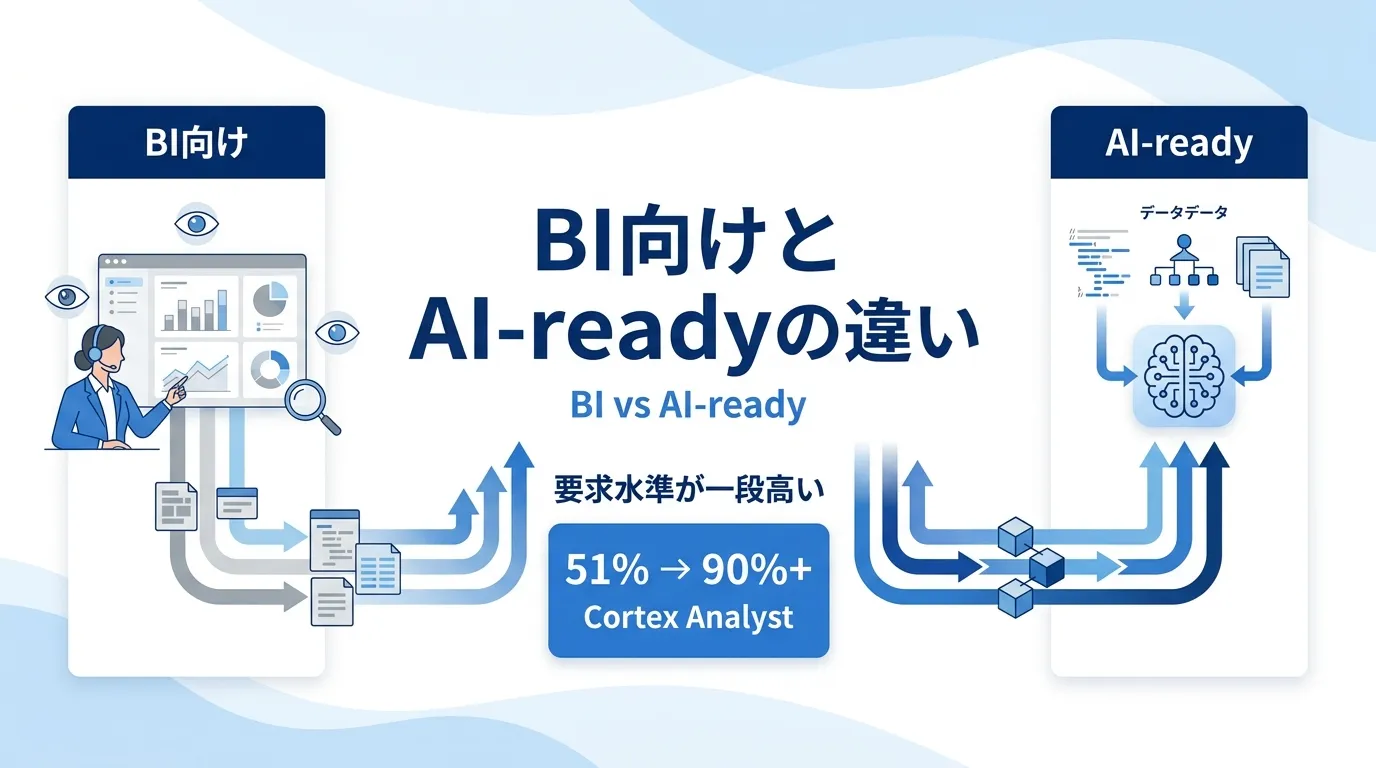
「うちはダッシュボードが揃っているから、AIもすぐ動くはず」という前提でPoCに入ると、まず高確率でつまずきます。BI向けとAI向けは、要求水準がひと段階違うからです。
違いを具体的な数字で見ると分かりやすいです。Snowflakeが2024年8月に公表したCortex Analystの検証では、社内で用意した150問のベンチマークで、単一プロンプトのGPT-4o直叩きが51%、セマンティックモデルを介したCortex Analystが90%超という結果でした。同社は別の内部評価(BIRD-SQLベンチ)で、同じLLMにセマンティックモデルを追加するだけで、Text-to-SQL精度が57%から78% へ改善したことも報告しています。
この差は、モデルの賢さではなく、AIに渡す前段の整備が生んでいます。BIツールの内部にだけ書かれていた「顧客が了承した遅延は除外する」といった暗黙のルールを、機械可読な形でAIから見える場所に置き直す。これがBIとAIレディの間にある壁の正体です。
現場でよく起きる違いを整理します。
- 用語定義: BIは人間が「これは税抜きだよね」と補える。AIは補わず自信満々に間違える
- 権限: BIはユーザー単位でダッシュボードを出し分ければ済む。AIは問い合わせのたびに動的に効かせる必要がある
- 鮮度: BIは「毎朝の更新で問題なし」で許容される場面が多い。AIは「いつのデータか」を回答に付けさせないと業務判断に使えない
- 履歴と根拠: BIは数字が出ればよい。AIは「なぜその数字か」を出典まで含めて返せないと現場に信用されない
BIが不要になるという話ではありません。BIの延長線上に、もう一段階の整備が要ります。BIそのものの選定基準はPower BI・Tableau・Lookerの違いと選び方で扱っています。
AI-readyデータをAIエージェントに使わせる仕組み
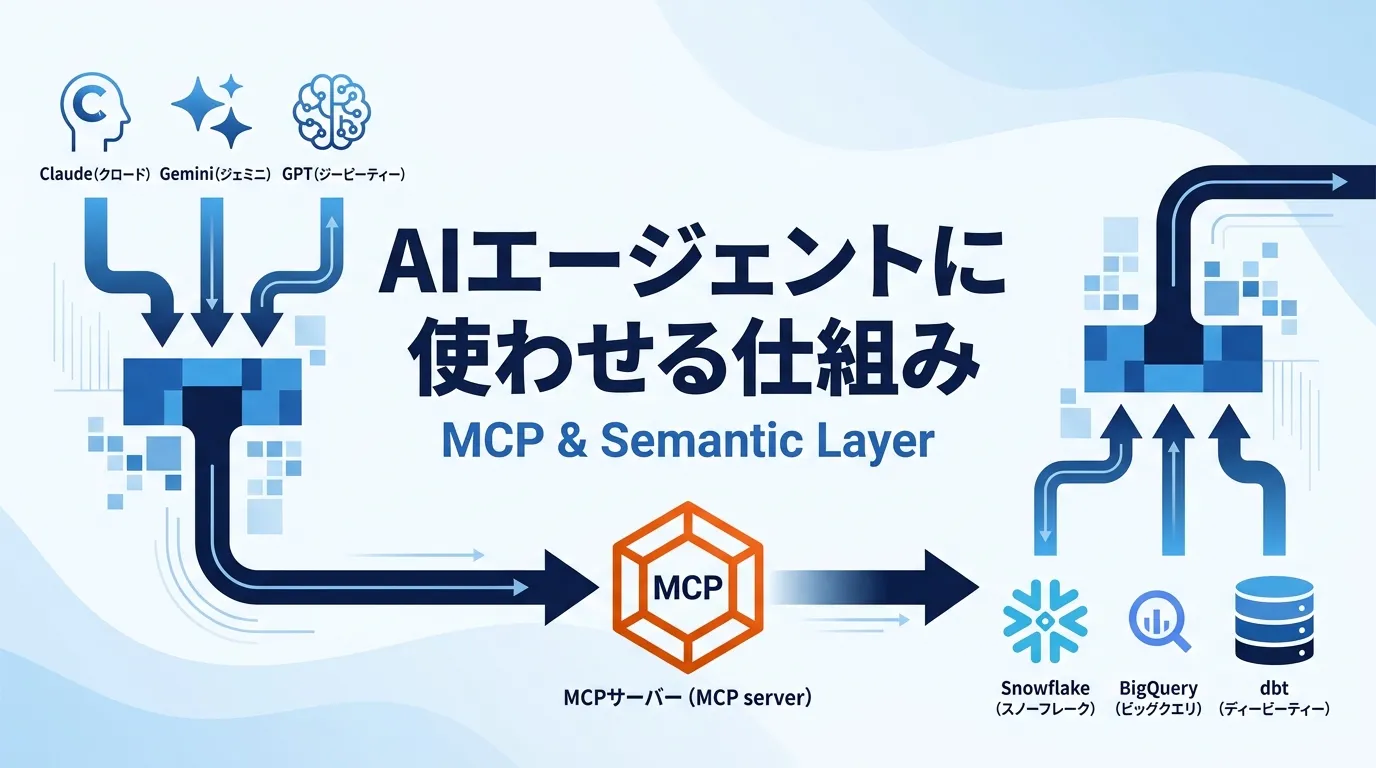
AI-readyデータをAIエージェントから叩ける口として、MCP(Model Context Protocol)が2025年後半から事実上の標準になりました。従来はエージェントごとに個別接続を実装していた作業が、共通プロトコルに集約されつつあります。
AIエージェント層
Claude / Gemini / GPT 社内AIアプリ BI 自然言語検索
「先週CPAが悪化した媒体は?」
AI向けインターフェース層(NEW)
MCPサーバー(Snowflake / BigQuery) Cortex Analyst セマンティックビュー
用語辞書と権限をセットで公開。生SQLの代わりにこの口を叩かせる
認定済みの指標定義で呼び出し
土台のデータ基盤
DWH(Snowflake / BigQuery) dbt / データカタログ リネージ / 可観測性
図のように、AIエージェントとデータ基盤の間に、AI向けインターフェース層を挟むのが2026年時点の推奨形です。この層で、指標定義と権限を1つの口に束ねて公開します。AIには生SQLを直接叩かせず、「先週CPAが悪化した媒体は?」といった自然言語のリクエストを、この口を通して受け付けさせます。
MCP(Model Context Protocol)が標準化の軸に
MCPは、AnthropicなどがAIエージェントと外部システムの接続用に定めた標準プロトコルです。2025年後半から主要DWHが対応を進めました。
- Snowflakeマネージド版MCPサーバー:2025年11月に一般提供開始。Cortex Agentsから直接呼び出せる
- BigQueryフルマネージド リモートMCPサーバー:2026年1月にGoogle Cloudが発表。Google ADK、Gemini CLI、LangGraph、Claude Code、Cursorなどのエージェントから接続できる
この標準化により、「AIエージェントごとに個別接続を実装する」というこれまでの重い作業が、共通の口に集約されつつあります。社内AIをスクラッチで作る場合でも、まずMCPサーバーに繋ぎ、その先の指標定義や権限は基盤側に寄せる、という設計が現実解になってきました。
生SQLで叩かせないという原則
ここで大事な原則があります。AIに生のテーブルへ直接SQLを打たせない、という設計です。
AIに生テーブルへの直叩きを許すと、指標定義が呼び出しごとにズレ、権限が抜け、履歴も残らなくなります。代わりに、Cortex AnalystやSemantic Viewsのように「認定済みの指標」だけをAIに公開し、その口を叩かせる形にします。この整理は、広告データを例にSQLで集計してからAIに渡す発想(なぜAI時代にこそデータ基盤が必要かで扱っています)と同じで、AI時代に一段標準化された形と考えていただければと思います。
RAG(社内文書をAIに参照させる仕組み)を組む場合も、この層の考え方は変わりません。ベクトル検索と構造化データを組み合わせる設計になりますが、構造化データ側は必ずAI-ready条件を満たしている前提です。詳しくはRAGとは?企業の社内データをAIに使わせる仕組みと作り方やベクトルデータベースとは?AI活用に必要な理由と選び方を参照してください。
AI-readyデータへ段階的に整える3ステップ
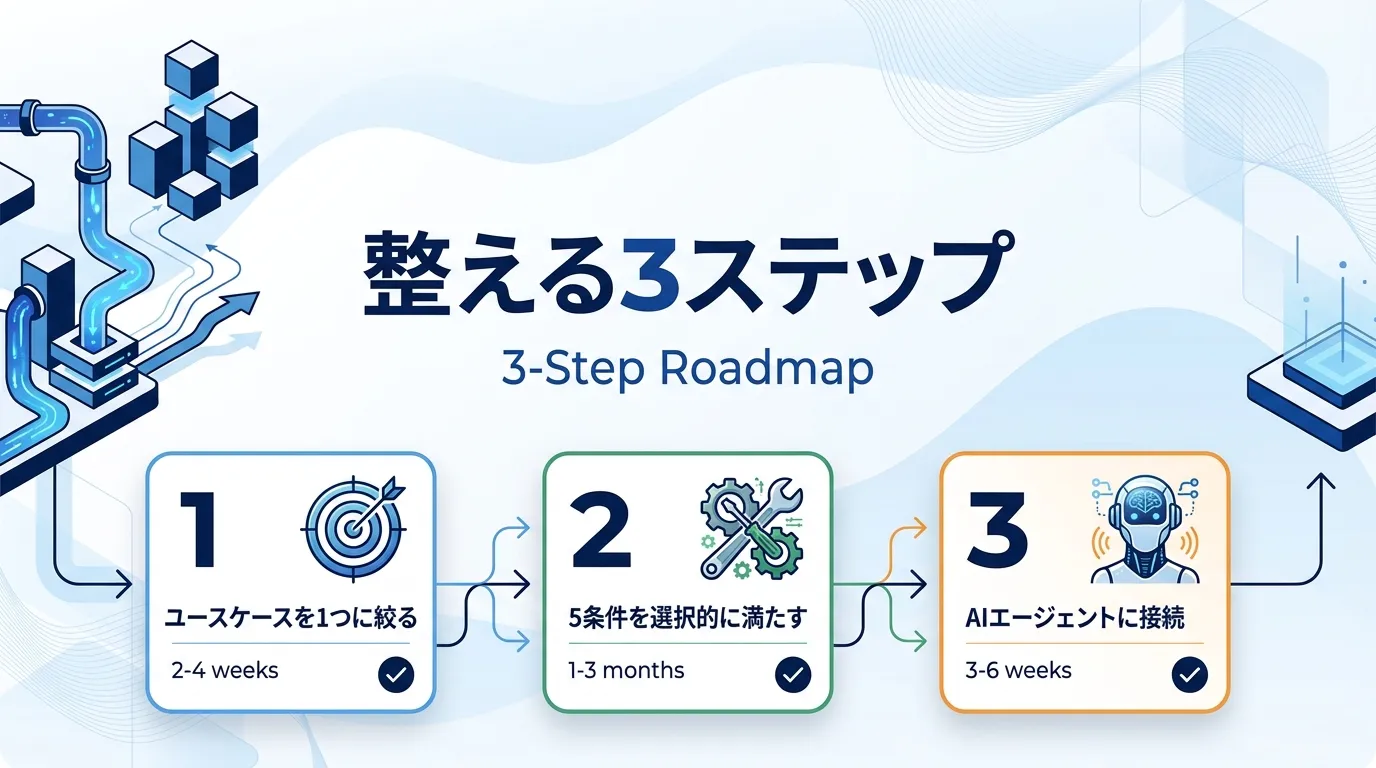
5条件を全社データで一斉に満たそうとすると、要件が膨らんでPoCすら始まりません。実装が定着している企業は、次の3ステップを1つのユースケース単位で回しています。
STEP 1 2〜4週間
ユースケースを1つに絞る
- 「営業の問い合わせ対応」など、価値が見えやすい1つを選ぶ
- その用途に必要なデータだけを対象範囲にする
- 期待効果と成功基準(KPI)を先に決める
STEP 2 1〜3か月
5条件を選択的に満たす
- 対象データの来歴(リネージ)を可視化する
- 主要指標に定義と用語辞書を付ける
- 鮮度・件数の監視と最低限の権限制御を入れる
STEP 3 3〜6週間
AIエージェントに接続する
- MCPサーバーやセマンティックビュー経由で公開
- 生SQLではなく認定済みの指標経由で呼び出させる
- 回答精度と業務工数を測定し、対象を広げる
Step 1: ユースケースを1つに絞る(2〜4週間)
「全社データをAIで活用する」から入らず、「営業の問い合わせ対応をAIで支援する」「過去の広告実績をAIに要約させる」など、価値が見えやすい1つの用途を選びます。その用途に必要なデータだけを対象範囲にする、という切り分けが後の3〜6か月の負荷を大きく変えます。
このステップで押さえておくことは、期待効果とKPI(月あたり削減工数、回答精度など)を先に決めておくことです。「AI活用の効果はどう測るのか」を決めずに走ると、6か月後に評価できず、投資判断が止まります。ユースケース候補の見つけ方や検証の進め方はデータ基盤のPoCの進め方|5ステップと成功基準・費用の目安で解説しています。
Step 2: 5条件を選択的に満たす(1〜3か月)
対象範囲のデータについて、5条件のうち効きやすい順に着手します。多くの現場では、来歴と意味の統一→鮮度・品質→アクセス制御の順で入るのが安定します。
- 対象データのリネージをdbtやリネージツールで可視化する
- 主要指標(今回の用途で答えさせたい数字)に定義と用語辞書を付ける
- 鮮度と件数の監視を入れ、業務に関わる担当者へアラート先を決めておく
- 最低限のロールベース権限をDWH側で整理する
「全部を100点にしよう」とすると終わらないため、用途に必要な水準までで線を引きます。全社の完全整備は目的ではなく、対象ユースケースが業務に耐える水準に達することが目的です。この整備自体の外注/内製の判断はデータ基盤は内製と外注どっち?判断基準とハイブリッドの進め方、費用感はデータ基盤構築の費用相場は?見積もりの内訳と判断基準を解説で整理しています。
Step 3: AIエージェントに接続する(3〜6週間)
整った土台の上に、AI向けインターフェース層を載せます。MCPサーバー、Cortex Analyst、Semantic Viewsなど、DWHが提供する接続方式のうち、自社のAIエージェント(社内ChatGPT、Claude、Geminiなど)に合うものを選びます。
このタイミングで回答精度と業務工数を必ず測ります。「回答精度70%→90%」「見積書検索の平均時間15分→2分」のような数字を取れる状態にしておくと、次のユースケースへ広げるための予算稟議が通ります。回答精度が上がらないときは、モデルを変える前に条件2(意味の統一)と条件3(鮮度・品質)に戻って原因を切り分けるのが定石です。
Evastの現場では:「うちの数字がAIで合わない」と相談を受けたときに、モデルを変える前に必ず聞くのが「AIには何経由で叩かせていますか」という点です。生テーブルへの直叩きだった場合、まず条件2の意味の統一とMCPやCortex経由への切り替えを先にやると、モデルを触らないまま精度が跳ね上がることがあります。
AI-readyデータ整備でよくある失敗パターン
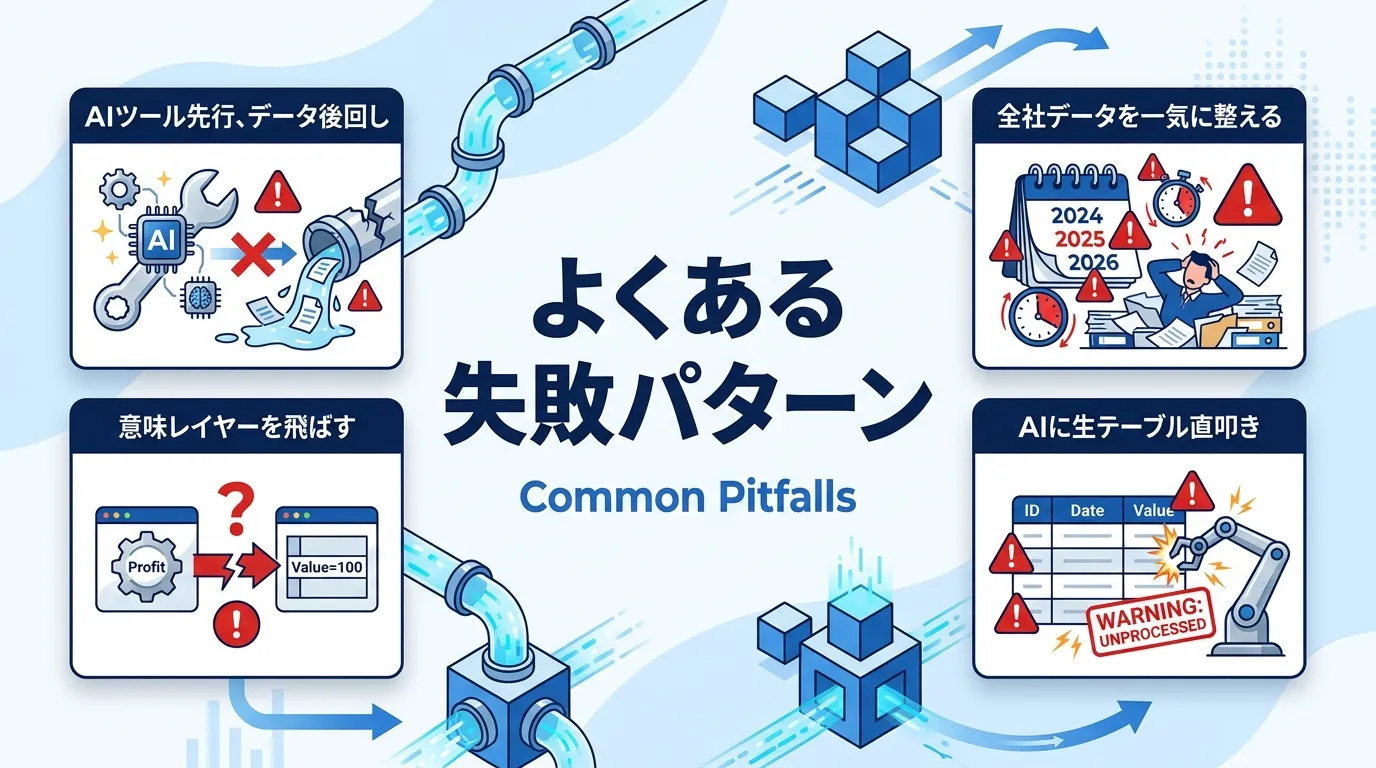
支援の中で繰り返し見てきた、典型的な失敗を4つ整理します。順序を間違えるだけで数か月の遠回りになるため、着手前に押さえておくことをおすすめします。
失敗1: AIツール先行、データ整備後回し
「まず社内ChatGPTを入れよう」と契約から入り、渡すデータの棚卸しは後回しにする進め方です。基盤モデル(LLM)は高性能でも、渡すデータが散らかっていれば答えは狂います。ガートナーの予測どおり、AI-readyデータに支えられていないプロジェクトから順にPoCで止まります。
失敗2: 全社データを一気に整える
「AI活用のために全社データを整えます」と3年計画を組む進め方です。3年後にはAI側の仕様が変わっており、途中で予算が止まります。1ユースケース3〜6か月で回し、成果を出しながら対象を広げる方が定着します。
失敗3: 意味レイヤー(条件2)を飛ばす
技術者主導で進むと、リネージと可観測性は入るのに、指標定義を機械可読にする作業が抜けることがよくあります。この状態でAIに繋ぐと、「先週の売上」を聞くたびに違う数字が返る、といった典型的な不信の原因になります。BIとダッシュボードごとに定義がズレている企業ほど、まずここに手を付ける価値があります。
失敗4: AIに生テーブルへの直叩きを許す
「とりあえずAIに全部のテーブルを読ませて、あとで絞る」と始める設計です。最初は動きますが、指標がズレる・権限が抜ける・履歴が残らない、の3拍子で運用に入る前に破綻します。最初からMCPサーバーやCortex経由での接続を設計に含めておくと、後戻りせずに済みます。
まとめ:AI-readyデータの要点と次の一歩
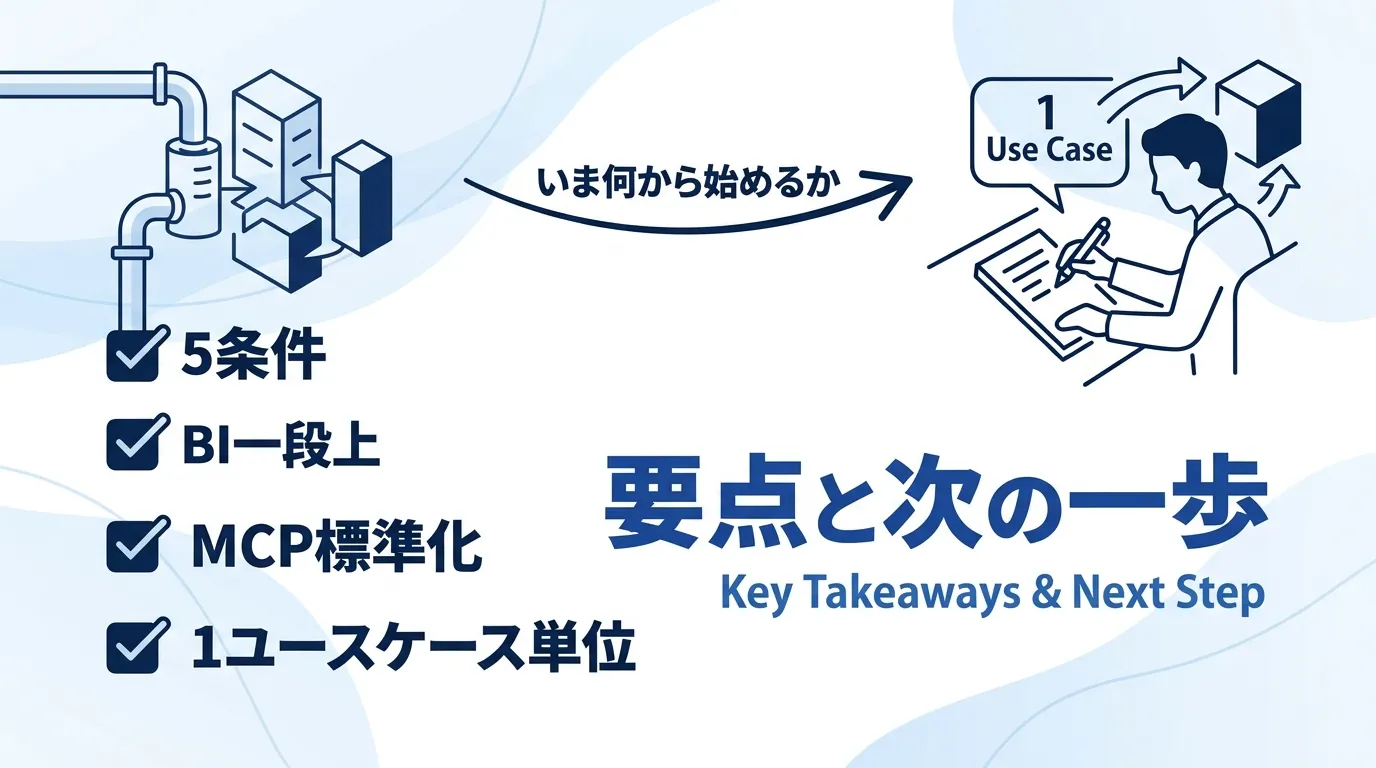
AI-readyなデータの要点を整理します。
- AI-readyは5条件の集合:来歴・意味・鮮度と品質・アクセス制御・AI向けインターフェース。土台の4つとAIとの接続口を、セットで満たして初めて成立する
- BI向け整備からもう一段階の水準が要る:Snowflakeの内部評価では、セマンティックレイヤーを介すだけでText-to-SQL精度が51%→90%超に跳ねた(2024年)。差はモデルではなく前段整備で生まれる
- MCPを軸にAI接続の標準化が進んだ:2025年末〜2026年初にかけて、Snowflake・BigQueryがマネージドMCPを一般提供。AIエージェントの接続方式は共通化に向かっている
- 整備は1ユースケース単位で3〜6か月:全社一斉ではなく、価値が見えやすい用途を1つ選び、対象データだけを段階的に整える
ガートナーの2025年2月の調査では、AIに適したデータマネジメント手法を「持っていない、または不明」と答えた企業が63%にのぼります。裏を返せば、いまAI-readyデータへの投資を始めれば、競合と目に見える差がつきやすい時期でもあります。次にやることは、社内で「どの業務でAIに答えさせたいか」を1つ書き出すこと。用途が決まれば、整えるべきデータの範囲は自然に絞れます。
なぜ「データの扱い方」がDXの成果を分けるのかという背景はなぜ今データマネジメントが必要なのか?DX成功の本質を解説、AI基盤全体の考え方はなぜAI時代にこそデータ基盤が必要かで扱っています。
AI-readyデータの整備はEvastへ
株式会社Evastでは、データ基盤の設計・構築、AI活用を見据えたデータ整備、社内AIアプリの開発支援までを一貫して支援しています。
- 「社内ChatGPTを入れたが精度が上がらない、まず現状のデータ整理から相談したい」
- 「AIに使えるデータの整備を、1つの業務から小さく始めたい」
- 「MCPやセマンティックレイヤーを含めた設計を、自社に合った形で検討したい」
現状診断からロードマップ策定、構築・運用定着まで、AIを見据えたデータ基盤づくりを伴走します。
→ データ基盤構築サービスを見る