モダンデータスタック(MDS)とは何か
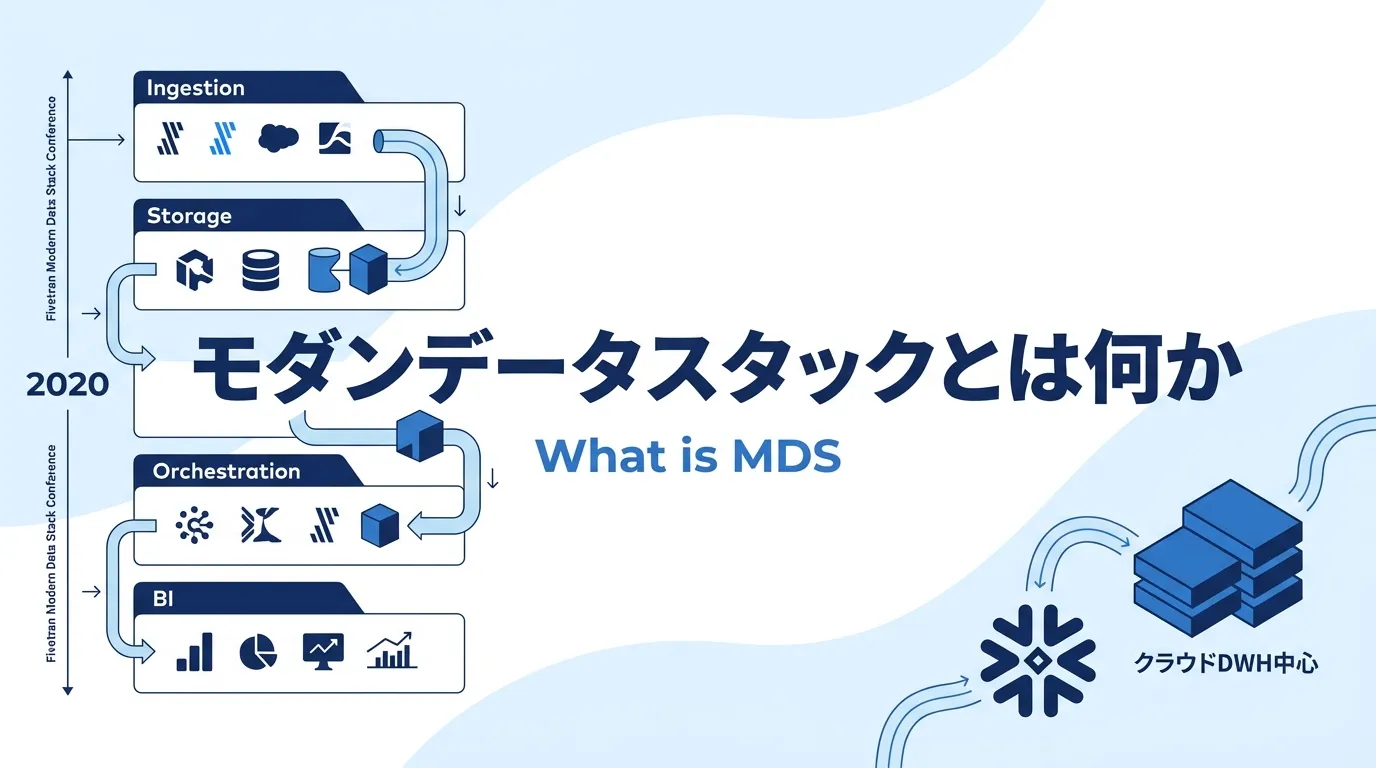
定義:クラウドDWH中心の分業構成 モダンデータスタック(Modern Data Stack、以下MDS)は、クラウドDWH(データウェアハウス、分析用にデータを集約して保管する基盤)を中心に、データ取り込み・変換・可視化などを担う専用ツールを組み合わせたデータ基盤の構成の通称です。
もう少し具体的に書くと、次の5つの層が「1社1製品」ではなく「層ごとに別ベンダー」で構成されるのが原型です。
データ取り込み (Fivetran、Airbyte、TROCCO)DWH/レイクハウス (Snowflake、BigQuery、Databricks、Redshift)SQL変換 (dbt、Coalesce、SQLMesh)オーケストレーション (Airflow、Dagster、Prefect)可視化・活用 (Looker、Tableau、Power BI、Metabase、Hightouch)このアーキテクチャは2020年10月、ベンチャーキャピタルのa16zが発表したレポート「Emerging Architectures for Modern Data Infrastructure」と、同時期のFivetran主催「Modern Data Stack Conference」で一気に業界標準として提示されました。
なぜ従来のETL+オンプレDWHから置き換わったのか 従来型
業務システムオンプレ/自社DC
→
ETLサーバー変換してから書き込む
→
オンプレDWH1社1製品で内製・運用
Informatica / Talend / Oracle Data Integrator
MDS
SaaS・業務DBAPI/CDC
→
Fivetran / TROCCO生データのままLoad
→
Snowflake / BigQueryクラウドDWH
→
dbt でTransformSQL・Git管理
層ごとに別ベンダー(best-of-breed)/SQL・API・オープン規格で接続
従来型(オンプレDWH+ETL)と、モダンデータスタック(クラウドDWH+分業SaaS)の対比 上図のように、従来型は自社データセンターのDWHに、ETLサーバー上で「変換してから」書き込む構成でした。1つの製品で全てを内製・運用するモノリシックな作りで、Informatica、Oracle Data Integrator、Talendなどが代表です。
MDSはここを2つの軸で塗り替えました。
まず、ELT(Extract → Load → Transform、先にDWHへロードしてから変換) への転換です。クラウドDWHの計算リソースが安価かつ弾力的になったため、生データをそのままロードし、SQLで変換する方が速くて安くて再現しやすくなりました。ETLサーバーを別建てで運用する必要が消えます。この転換の詳細はETLとELTの違いとは?5つの比較軸とELTが主流になった理由 で整理しています。
もう1つは、分業とベスト・オブ・ブリード です。1社が全てを提供する代わりに、各層の得意な会社が専門ツールをSaaSで提供し、SQL・API・オープン規格で接続します。取り込みだけが遅ければFivetranを別のツールに差し替える、といった局所最適化がしやすくなりました。
このELTと分業を可能にした前提が、Snowflake(2014年〜)とBigQuery(2011年〜)に代表される「ストレージと計算を分離した」クラウドDWHです。DWHの仕組みそのものはDWH(データウェアハウス)とは?クラウドDWHの比較と選び方 で解説しています。
誤解されやすい点 MDSは「特定のツールセットの商品名」ではなく、「クラウドDWHを中心に、各層をSaaSで組み立てる思想」を指す通称です。Fivetran+Snowflake+dbt+Lookerだけが正解ではなく、BigQuery+Airbyte+dbt Core+Metabaseでも同じ思想が実現できます。国内でTROCCOを使う場合も、思想としては同じ枠に入ります。
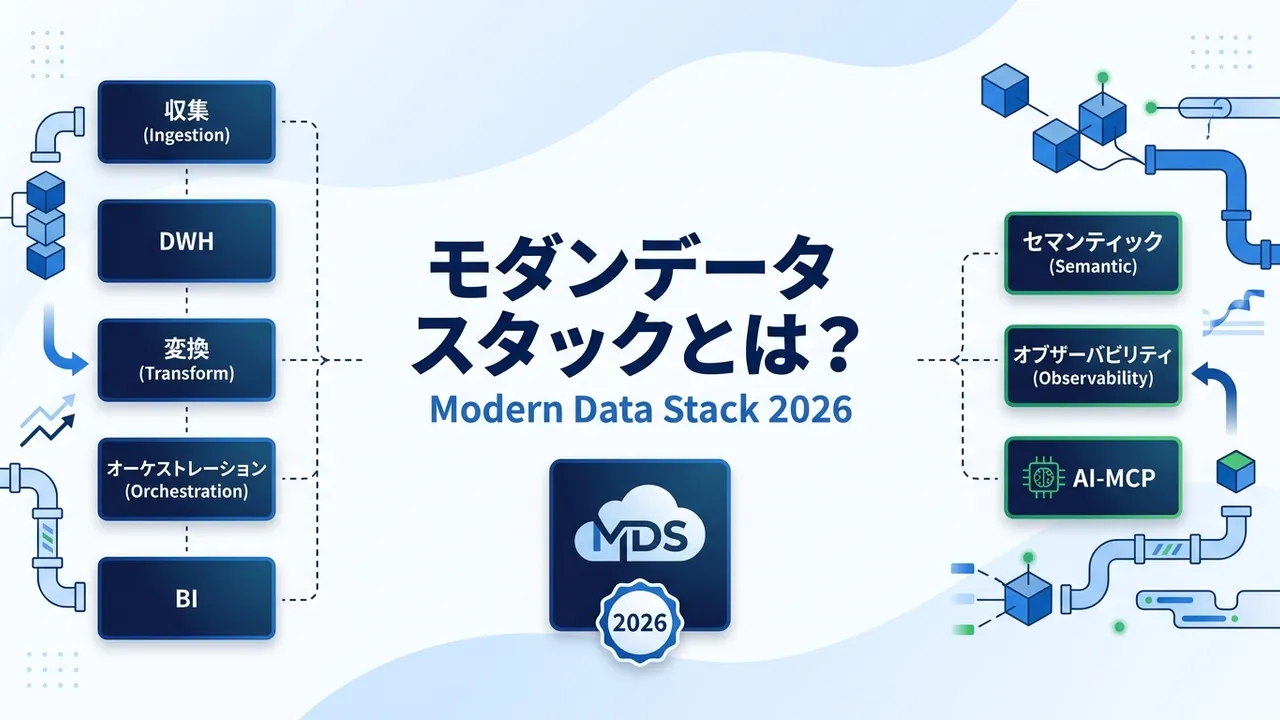
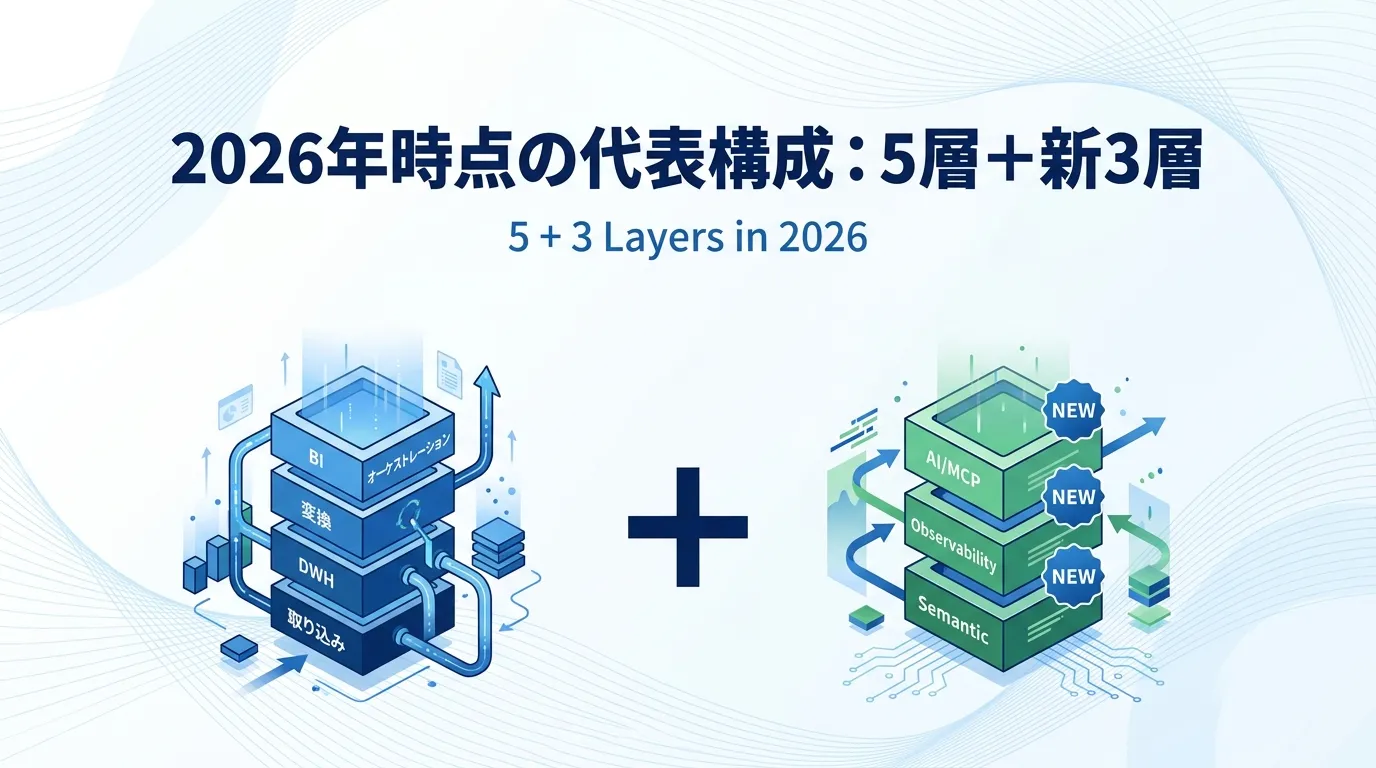
2026年時点の代表構成:5層+新3層
2020年時点の5層に、2025〜2026年で3つの新しい層が加わりました。
従来からの5層
1
データ取り込み(Ingestion)
Fivetran / Airbyte / TROCCO
2
DWH・レイクハウス
Snowflake / BigQuery / Databricks / Redshift
3
SQL変換(Transformation)
dbt / Coalesce / SQLMesh
4
オーケストレーション
Airflow / Dagster / Prefect
5
可視化・活用
Looker / Tableau / Power BI / Metabase / Hightouch
+
2025〜2026年で加わった3層
6
セマンティックレイヤー
dbt Semantic Layer / Cube / AtScale
7
データオブザーバビリティ
Monte Carlo / Bigeye / Sifflet / Elementary
8
AI/MCP接続層
dbt MCP / BigQuery MCP / Snowflake Cortex / Databricks Genie
2026年時点のモダンデータスタック:従来からの5層に、セマンティックレイヤー・オブザーバビリティ・AI/MCP接続層の3層が加わった 従来からの5層:現状と代表ツール 1. データ取り込み(Ingestion)
Fivetran :500超のコネクタを持つ最大手。2026年1月からdelete行・履歴行も課金対象になり、コネクタ毎に最低$5の変更を導入。多くの利用企業で実請求が40〜70%上昇したという報告が出ていますAirbyte :OSS版とCloud版。コネクタが多く、SaaS連携で費用を抑えたい組織に強いTROCCO(primeNumber社) :国内SaaS(kintone、freee、HRMOSなど)連携で事実上の標準。Starter月¥75,000〜、Essential月¥150,000〜Fivetran・Airbyte・TROCCOなどのツール選びはデータ連携ツールの選び方:コスト・サポート・コネクタ数で比較 、料金相場のより詳しい比較はデータ連携ツールの料金相場|費用の抑え方を解説 にまとめています。
2. DWH/レイクハウス
Snowflake :純粋なDWH寄り。マルチクラウドで動き、シェア機能(データマーケットプレイス)が強いBigQuery :Google Cloud純正。オンデマンド課金で「使った分だけ」のスモールスタートに向くDatabricks :Sparkベースのレイクハウス。AI・機械学習を1つの基盤で扱いたい組織に強いRedshift :AWSネイティブ。既存AWSワークロードとの統合が主目的DatabricksとSnowflakeの使い分けはDatabricksとは?レイクハウスの仕組みと料金を解説 、BigQueryとSnowflakeの違いはSnowflakeとBigQuery比較:コスト・性能・機能の違いと選び方 で整理しています。
3. SQL変換(Transformation)
dbt :事実上のデファクト。CoreはOSS、Cloudは商用。dbt Cloud Teamは$100/シート/月Coalesce :GUIベースでdbtと同じ思想を実現SQLMesh :仮想実行やデータ品質チェックをネイティブに持つ後発dbtが担う「SQL変換の設計」の中身はdbtとは?BigQueryのデータ変換を効率化するツールを解説 で解説しています。
4. オーケストレーション
Airflow :デファクトのOSS。運用負荷は高いDagster :後発。データを第一級市民として扱う設計が特徴Prefect :軽量。中小規模に向く比較軸はAirflow / Dagster / Prefect:ワークフローエンジンの違いと選び方 にまとめています。
5. 可視化・活用
Looker :LookMLベース。10ユーザーで月$3,000〜5,000程度Tableau・Power BI :エンタープライズBIの標準。Power BI Proは2025年4月に月$10→$14へ40%値上げMetabase・Hex :軽量。中小規模やアナリスト中心の組織に向くLooker Studio :無料。BigQueryとの相性が良く、国内中堅の主力リバースETL(Hightouch、Census) :DWHのデータをSalesforceやSlackへ書き戻す層。運用系ワークフローと繋げるならほぼ必須2025〜2026年で加わった新3層 古い解説記事にはない、この2年で第一級市民になった層です。
6. セマンティックレイヤー
「売上」「受注」「粗利率」といった指標の定義をYAMLで1度だけ書き、BI・AI・アプリすべてに同じ定義を配信する層です。dbt Semantic Layer(2023年10月にMetricFlow統合版がGA、2025年以降にAI連携で本格普及)、Cube、AtScaleが代表。詳細はセマンティックレイヤーとは?AI時代のデータ活用の要 で扱っています。
ガートナーは2026年の予測で、この層を入れると生成AIの回答精度が80%改善しコストが60%削減されるとしています。逆にセマンティックレイヤーなしでMCPだけに頼るAgentic Analyticsは、2028年までに60%が失敗すると予測しました。
7. データオブザーバビリティ
パイプラインの失敗、鮮度低下、スキーマ変更、異常値を検知する監視層です。Monte Carlo、Bigeye、Sifflet、Great Expectations、Metaplaneなどが代表。5層で組んだ基盤が育つほど、上流の変更が下流のどこを壊したか追跡不能になるため、後付けではなく最初から入れておくのが2026年の標準です。詳しくはデータオブザーバビリティとは?データ品質監視の5つの柱と始め方 で整理しています。
8. AI/MCP接続層
AIエージェントがDWHに問い合わせるための接続層です。dbt MCP Server(2025年4月)、BigQuery MCP、Snowflake Cortex Agents、Databricks Genieなど、主要ベンダーが2025〜2026年にかけて出揃いました。この層は単体では意味を持たず、上のセマンティックレイヤーとセットで初めて業務のクエリに使えます。詳細はMCPとは?AIエージェントとBigQueryをつなぐ標準規格の実装ガイド で解説しています。
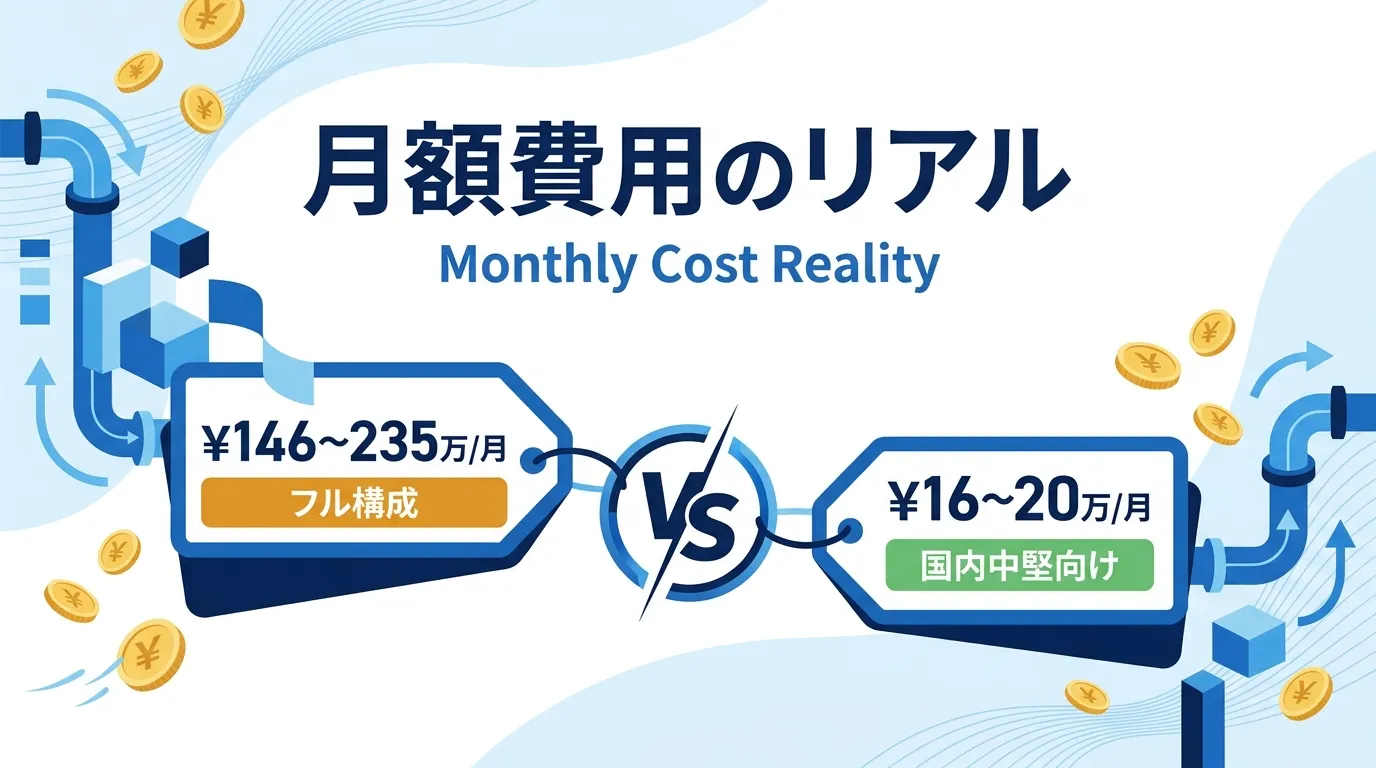
月額費用の目安:フル構成と国内中堅向け構成
前提は「データソース50、DWH規模500GB、アナリスト10名」の中堅企業想定です。1USD=155円で換算しています。
Fivetran ¥31〜78万
Snowflake Enterprise ¥41万
dbt Cloud Team ¥15.5万
Looker ¥46〜78万
Hightouch Pro ¥12〜23万
合計 月 ¥146〜235万
vs
TROCCO Essential ¥15万〜
BigQuery オンデマンド ¥1〜5万
dbt Core(OSS) ¥0
Looker Studio ¥0
合計 月 ¥16〜20万
MDSのフル構成と、国内中堅向けの軽量構成の月額目安(データソース50・DWH500GB・アナリスト10名想定) フル構成(上場企業・シリーズC以降向け) 海外テック企業の標準的な「best-of-breed」構成です。すべて有償のCloud版を採用した場合の月額を、公開価格ベースで積み上げます。
層 ツール 月額(USD) 月額(JPY・155円換算) 取り込み Fivetran(50コネクタ) $2,000〜5,000 ¥31〜78万 DWH Snowflake Enterprise(Medium稼働10h/日) $2,640 ¥41万 変換 dbt Cloud Team($100/シート×10名) $1,000 ¥15.5万 BI Looker(10ユーザー) $3,000〜5,000 ¥46〜78万 リバースETL Hightouch Pro $800〜1,500 ¥12〜23万 合計 $9,440〜15,140 ¥146〜235万
年額に換算すると¥1,750〜2,820万で、これに実装人件費や社内運用が乗ります。上場前準備や海外展開を控えた組織にとっては投資として合理的ですが、売上10〜50億円の中堅で使い切るのは容易ではありません。
国内中堅向け(BigQuery+TROCCO+Looker Studio) 国内でBigQuery中心の構成を取ると、以下の水準に収まります。
層 ツール 月額(JPY) 取り込み TROCCO Essential ¥15万〜 DWH BigQuery オンデマンド(500GBスキャン/月想定) ¥1〜5万 変換 dbt Core(OSS、自社実行) ¥0(人件費のみ) BI Looker Studio ¥0 合計 ¥16〜20万
BigQueryのオンデマンド課金はスキャンしたデータ量1TBあたり約$6.25で、パーティション設計をきちんと入れれば500GB規模のワークロードは月数万円に収まります。設計の要点はBigQueryのコスト最適化の考え方 にまとめています。
この構成で上場企業クラスの分析要件を回している事例も珍しくありません。逆に、国内でMDSを「まず一式そろえないと」と思い込んで100万円超の構成を選んだものの、機能を持て余しているケースも同じくらい見かけます。
DIY最小構成 さらに絞るなら、BigQuery+dbt CoreだけでMDSと同じ思想を実現できます。取り込みは各SaaSのExport機能やCloud Functions+Cloud Scheduler、BIは既存のスプレッドシートで済ませる構成です。エンジニアが1人いれば月数万円で動きます。
代わりに、ノーコードで運用したい非エンジニアや、鮮度・監視を厳しく問う業務には向きません。データ基盤の構築費全体の相場感はデータ基盤の費用相場と見積もりの内訳 で整理しています。
「モダンデータスタックは死んだ」議論の中身
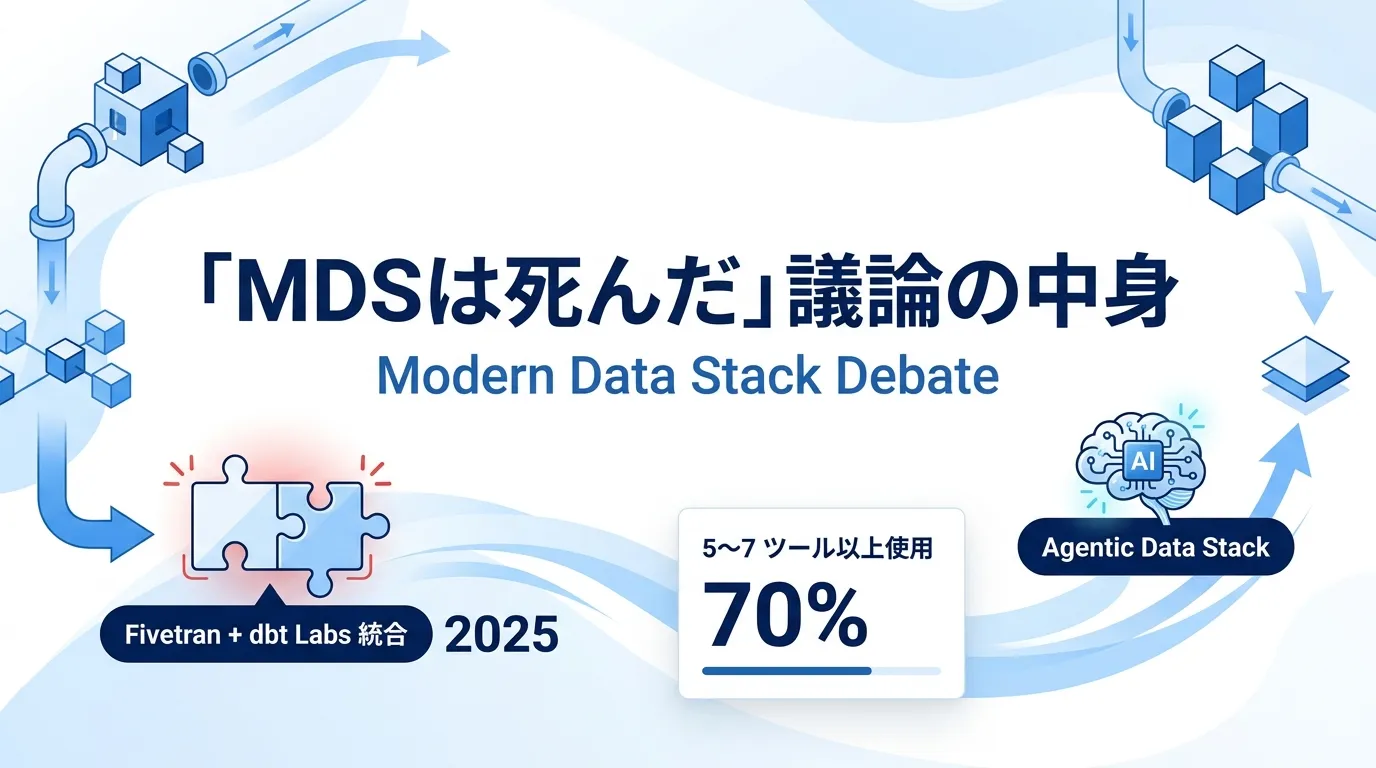
2025年から2026年にかけて業界で語られるようになった「Modern Data Stack is Dead」論の中身を、根拠となっている3つの事実に分けて確認します。
事実1:ツール統合が進んだ 2025年10月、FivetranとdbtLabsは統合を発表しました。両社のユーザーは80〜90%が重複しており、「取り込みと変換の間に会社の境界がある必要はない」という発想です。同じく2025年、Snowflake顧客の52%がDatabricksを併用(2024年は40%)していると報告されました。
各層でベスト製品を選ぶという「best-of-breed」の前提が、統合プラットフォーム側からの圧力で崩れつつあります。
事実2:ツール数の多さそのものが痛みになった Modern Data 101が2025年3月に発表した調査(48カ国・230名超のデータ実務者、15年以上経験者中心)では、次の結果が出ています。
70%超が5〜7個以上のツールを日常的に使用 10%が10個超のツールを使用 40%がツール間の切り替えに1日の30%以上を費やしている 「best-of-breed」で組んだ結果、日々の作業は「ツール間を行き来する時間」に埋め尽くされる、という数字です。
事実3:AIが「切り離されたデータ」に耐えられなくなった 生成AIが自然言語からSQLを組み立てる仕組みが普及した結果、「5つのソースが切り離されたまま、AIに問い合わせて意味のある答えが返る」というシナリオは実務上ほぼ成立しないことがはっきりしました。
このため、Semantic LayerとMCPをセットにした「Agentic Data Stack」が新しい重心になっています。ここは、これまでの分業前提のMDSにとって根本的な追加要件です。詳細はなぜAI時代にこそデータ基盤が必要か|生成AIが失敗する理由 で整理しています。
総合すると MDSは「死んだ」というより、「best-of-breedの徹底」から「統合プラットフォーム+AI連携+オブザーバビリティ」の重心に移った、というのが正確な理解です。5層の骨格は残り、その上下に3層が乗った、と考えるのが実務的です。
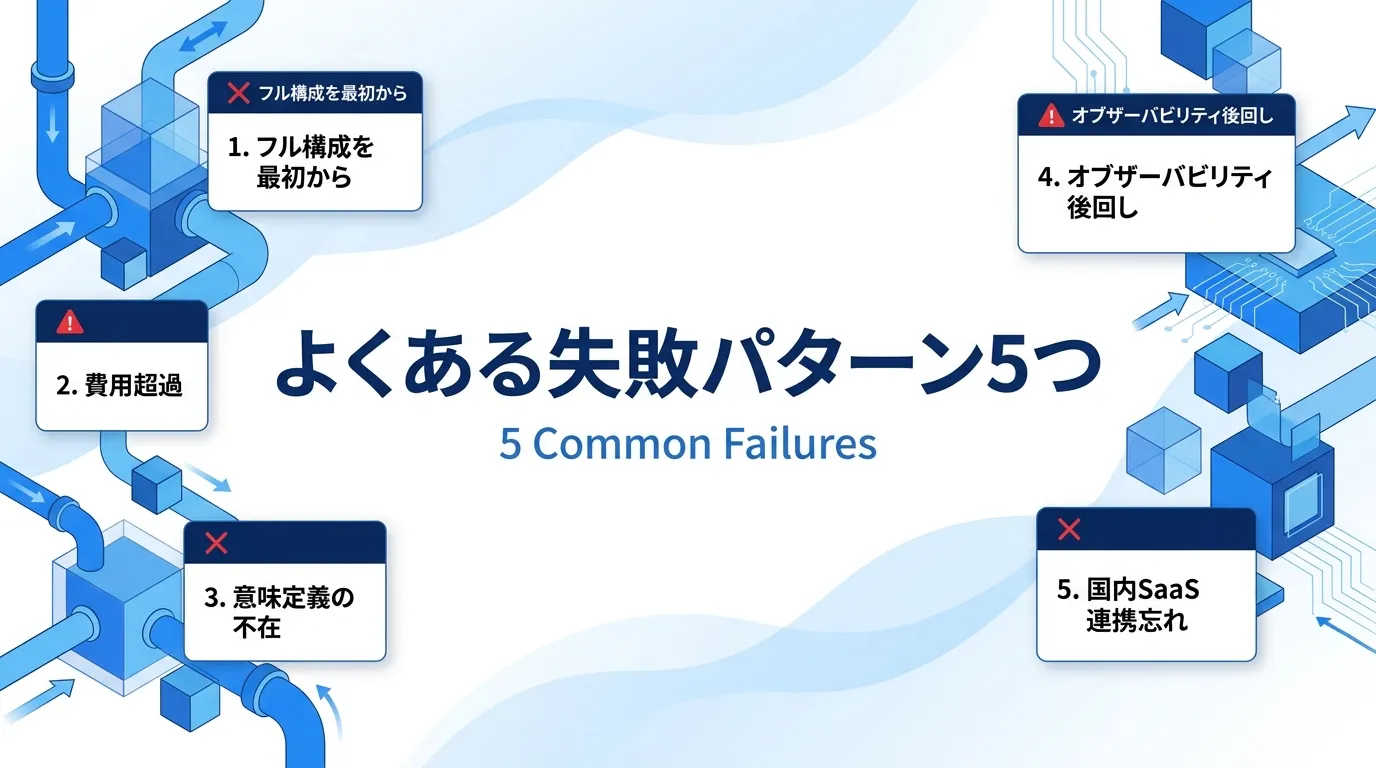
よくある失敗パターン5つ
導入プロジェクトで実際に起きているつまずきを5つに整理します。
失敗1:フル構成を最初から組む 「MDSといえばFivetran+Snowflake+Lookerでしょう」と、最初から月150万円超の構成を組む。数か月で「これ、使っている機能は月10万円ぶんもない」と気づき、コストだけが残ります。
対処は、まず動く最小構成を組み、痛みが出たところだけ差し替える こと。BigQuery+TROCCO+Looker Studio+dbt Coreで始めれば、月20万円以内で「MDS的な体験」の8割は再現できます。
失敗2:Fivetran・Snowflakeの費用が想定を大きく超える Fivetranは月あたりアクティブ行数(MAR)課金で、2026年からdelete行・履歴行も加算されます。Snowflakeはウェアハウスのアイドル時間で40%浪費という報告もあります。
対処は、契約前に3ヶ月分の実データで見積もりを取り直す こと、そしてアイドル時間の自動停止設定を最初から入れることです。
失敗3:意味定義の不在 「売上」「CV」の定義を曖昧なままにしておくと、複数のBIやチャットAIから同じ質問をして違う数字が返ってきます。これはツールの問題ではなく、定義を1つに揃える層が欠けているからです。
対処は、MDSを組む段階でセマンティックレイヤーを最初から入れる こと。dbt Semantic LayerかCubeを使えば、YAMLで書いた指標定義がすべての利用側に配信されます。
失敗4:オブザーバビリティの後回し パイプラインが5〜10本を超えるあたりから、「昨日のダッシュボードの数字が今日変わっている」といった事故が増えます。オブザーバビリティを後付けで導入するのは大工事になりがちです。
対処は、dbt testやElementary、Great Expectationsといった軽量な監視を、パイプライン1本目の段階から入れておくこと。フル構成のMonte Carloは組織が育ってからで十分間に合います。
失敗5:国内SaaS連携を軽く見る FivetranやAirbyteは、kintone、HRMOS、freee、マネーフォワードなど日本語圏のSaaSコネクタが弱いです。「Fivetranで全部繋がる想定」で組み始めた結果、業務系SaaSだけ手動CSVという運用が固定化するケースがあります。
対処は、取り込み層に国内SaaS対応を条件に入れて選ぶ こと。TROCCOは国内SaaSコネクタが厚く、Fivetranと役割分担する構成も現実的です。
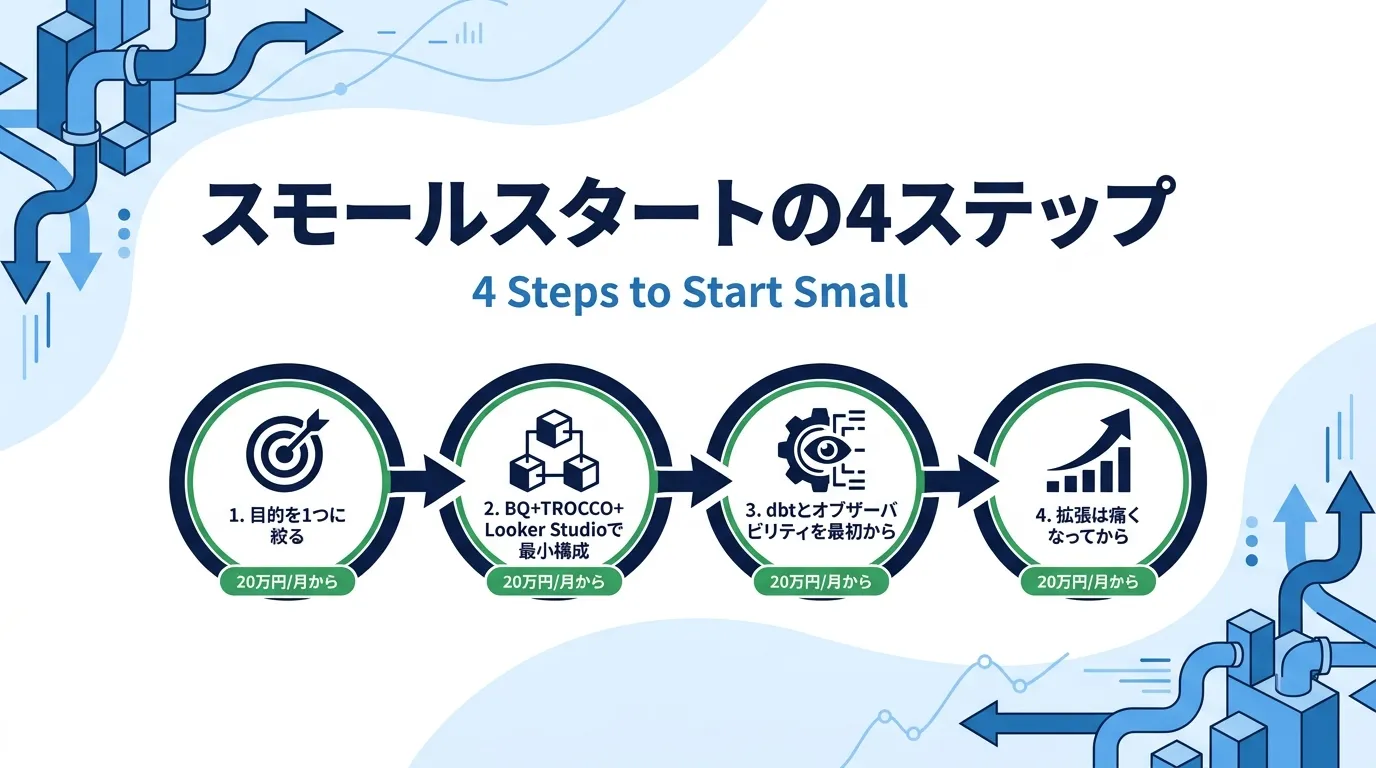
進め方:スモールスタートの4ステップ
導入プロジェクトを失敗させないための最小限の手順を、4ステップで示します。
ステップ1:目的を1つに絞る 「データ基盤を作る」ではなく、「どのKPIを、誰の意思決定のために、どの粒度で速くしたいか」を1つ決めます。月次締めの営業レポートを翌朝に、SaaSのMRR推移をリアルタイムで、広告のROIを媒体横断で。この1文が書けないうちに、ツール選定に入ってはいけません。SaaSプロダクトでチャーンとLTVを軸にKPIを組み直したい場合は、SaaSプロダクトのデータ分析基盤の作り方|チャーン・LTVを可視化する費用と手順 にモダンデータスタックへの寄せ方をまとめています。
ステップ2:BigQuery+TROCCO+Looker Studioで最小構成を組む 上のKPIに必要なソースを3〜5個に絞り、TROCCOで取り込み、BigQueryに保存、Looker Studioで1枚のダッシュボードにします。ここまで月20万円以内・実装2〜4週間 を目安に。目安を大きく超えるなら、要件が広がりすぎていないか戻って確認します。
ステップ3:dbtとオブザーバビリティを”最初から”入れる ダッシュボードが1枚できたら、そのSQLをdbtに移し、テストとリネージ(データの流れの記録)を仕込みます。dbt Coreで十分です。ここまでで、パイプライン変更やデータ品質異常の検知を仕組みで担保できます。
dbt導入の外部委託を検討する場合の範囲と費用はdbt導入・構築支援の費用と進め方 にまとめています。
ステップ4:拡張は”痛くなってから” 利用者が増え、指標が10を超え、AIエージェントから呼ぶ需要が出てきたら、セマンティックレイヤー(dbt Semantic LayerまたはCube)を追加します。Fivetran、Snowflake、Lookerへの移行を検討するのは、TROCCOやBigQueryオンデマンドで明確に痛みが出てからで遅くありません。
導入の全体的な進め方や失敗を防ぐ考え方はデータ基盤とは?導入すべき3つの理由と4つの構成要素|2026年版 にも整理しています。
まとめ モダンデータスタックは、2020年に生まれた「クラウドDWHを中心にSaaSを組み合わせる」構成の通称です。2026年時点では、そこにセマンティックレイヤー・オブザーバビリティ・AI/MCPの3層が加わり、best-of-breedから統合プラットフォームへの重心移動も同時に進んでいます。
Fivetran+Snowflake+Lookerの「フル構成」を最初のゴールに置くと、月100万円超のランニングコストだけが残るケースが多いです。国内中堅企業の実務では、BigQuery+TROCCO+Looker Studio+dbt Coreで月20万円以内から始め、痛みが出たところだけ差し替えていくのが最も失敗しにくいパターンでした。
Evastは、この「小さく組んで痛みが出たところだけ差し替える」進め方でのデータ基盤構築を支援しています。BigQuery中心の構成から始めて、必要なタイミングでSnowflakeやDatabricks、Semantic Layer、AIエージェント接続まで拡張したいというご相談を多数いただいています。
自社の要件に合った構成を一緒に検討したい方は、データ基盤の構築支援サービス からお気軽にお問い合わせください。既にBigQueryやSnowflakeを使っていて、費用が想定を超えている・意味定義が揃わない・AI連携で詰まっているといったご相談も歓迎です。