データパイプラインとは?データを自動で運び、使える形に整える仕組み
データパイプラインとは、データを発生源から利用先まで自動で運び、途中で使える形に加工する処理の連なり です。パイプライン(pipeline)は本来「配管」を意味する言葉で、水道管の中を水が流れるように、データが処理から処理へと自動で流れていく様子を表しています。
対になるイメージは「人手によるバケツリレー」です。担当者が管理画面からCSVをダウンロードし、Excelで整形し、共有フォルダに置く。この手作業の連鎖をソフトウェアによる自動の流れに置き換えたものが、データパイプラインだと考えてください。
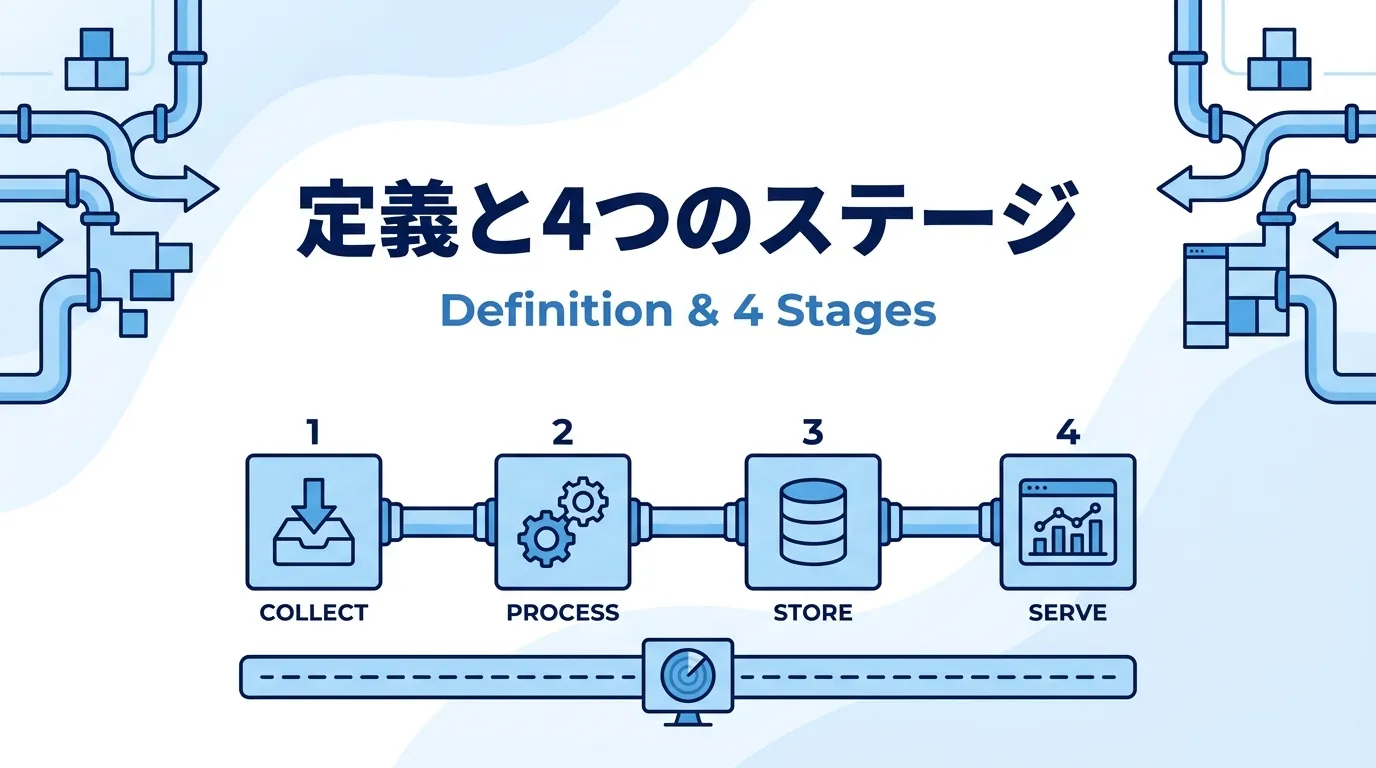
データパイプラインを構成する4つのステージ データパイプラインは、おおむね「収集・処理・蓄積・提供」の4つのステージで構成されます。次の図のように、データは左から右へ流れ、その全体を下段のオーケストレーション・監視が支える構造です。
データソースSaaS / DB / ログ
→
収集抽出・転送
→
処理変換・クレンジング
→
蓄積DWH / データレイク
→
提供BI / ML / 業務システム
オーケストレーション・監視(実行順序の制御/失敗の検知/リトライ)
データパイプラインの4つのステージ。全体をオーケストレーション・監視が下支えする 収集 :SaaS・業務データベース・アプリのログなどから、データを抽出して運び出す処理 :型変換・表記揺れの統一・集計など、分析に使える形への加工を行う蓄積 :DWH(データウェアハウス。分析用にデータを集約するデータベース)やデータレイク(生データを加工せず安価に貯めておく置き場)に格納する提供 :BIツールでの可視化、機械学習モデル、業務システムなど、利用先へデータを届ける図の下段にあるオーケストレーション・監視は、4つのステージそのものではなく「ステージ全体を毎日正しく動かし続けるための土台」です。この土台こそがパイプライン運用の肝になるため、後半の章で詳しく扱います。
データ基盤全体の中でパイプラインが占める位置 データ基盤(データの収集・蓄積・分析を担う社内のインフラ全体)にあてはめると、パイプラインはデータソースとDWHをつなぐ動脈にあたります。
データソース
パイプライン
DWH
データマート
BIツール
SalesforceCRM
GA4広告管理
基幹システムERP
IoT・センサー
BIツールTableau / Looker / Power BI
図のとおり、どれだけ高性能なDWHやBIツールを揃えても、パイプラインが止まればデータは1行も届きません。冒頭の「数字が3日前のまま」という症状は、たいていこの動脈のどこかが詰まっています。
データ基盤そのものの考え方や構成要素は本記事の関連記事欄にまとめています。
データパイプラインとETLパイプラインの違い
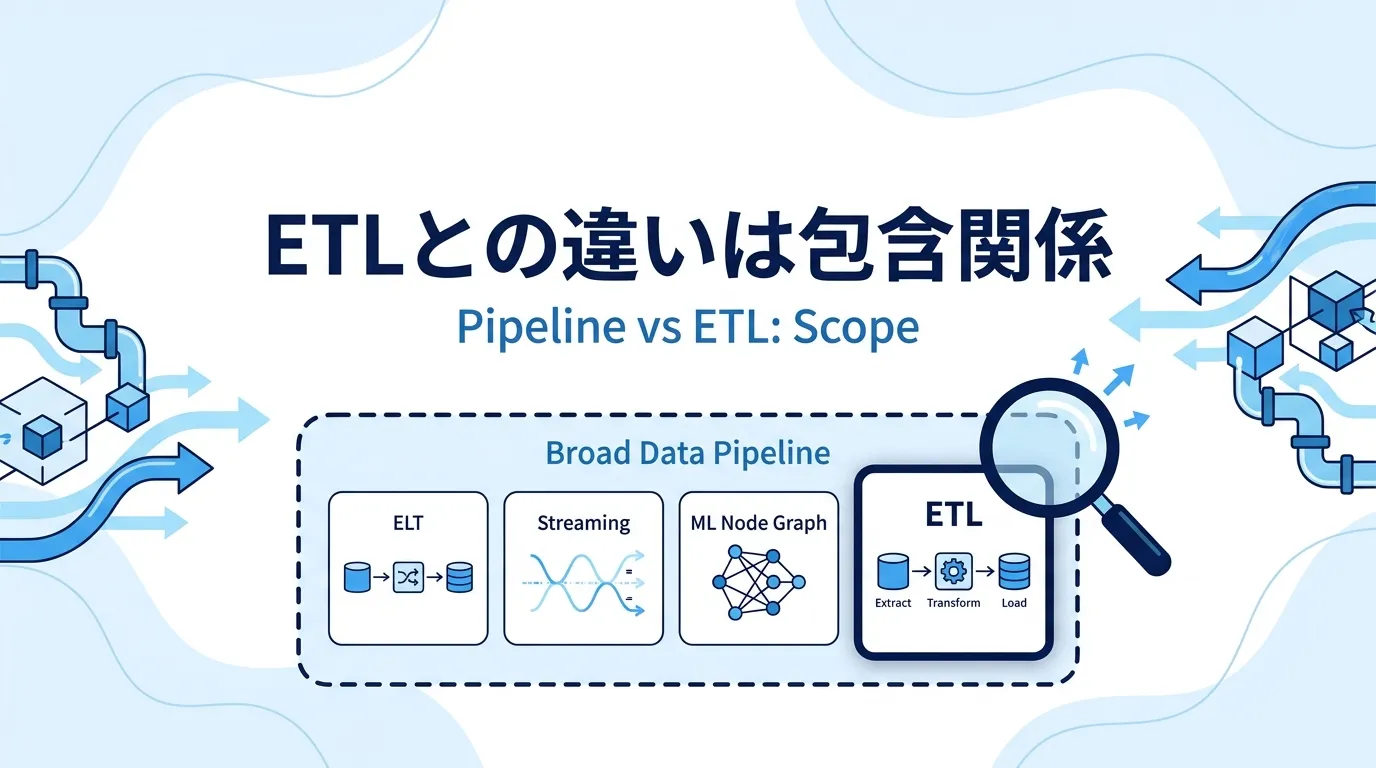
両者の違いは、ひとことで言えば「指している範囲の広さ」です。データパイプラインが「データを自動で運び・加工する処理全般」を指す総称であるのに対し、ETLパイプラインはそのうち「Extract(抽出)→ Transform(変換)→ Load(格納)の順で処理するタイプ 」を指します。
次の図のように、ETLパイプラインはデータパイプラインという大きな枠の中の1区画です。「どちらを使うべきか」という二者択一の関係ではありません。
データパイプライン(データを自動で運び・加工する処理の総称)
ETLパイプライン抽出 → 変換 → 格納の順で処理
ELTパイプラインDWHに入れてから変換
ストリーミング発生の都度リアルタイム処理
ML向け特徴量パイプライン機械学習用の前処理
ETLパイプラインは、データパイプラインという広い概念の中の代表的な一種 観点ごとに整理すると、次のようになります。なお、これは対等な二者の比較ではなく、右の列(ETLパイプライン)は左の列(データパイプライン)に含まれる関係です。
観点 データパイプライン ETLパイプライン 概念の範囲 総称(広義) 一種(狭義) 変換処理 あってもなくてもよい(単純コピーも含む) 必ず含む(Transformが中核) 処理方式 バッチもストリーミングも含む 定期実行のバッチ処理が中心 典型例 ログのリアルタイム集約、ML向け前処理、リバースETL等 基幹システム → DWHの日次バッチ連携
誤解されやすいのは「変換処理」の行です。たとえば業務システムのログをAmazon S3へ毎晩そのままコピーするだけの仕組みは、変換を含まないためETLとは呼べませんが、立派なデータパイプラインです。
ETLの3工程それぞれの仕組みや代表的なツールは、ETLとは?データ統合の基礎と選定ポイントを解説 で図解つきで詳しく扱っています。
なぜ混同されやすいのか:かつては「パイプライン ≒ ETL」だった 2000年代まで、分析目的のデータ連携といえば「夜間のETLバッチ」が中心で、パイプラインといえばETLを指す時代が長く続きました。混同が多いのはこの歴史の名残です。
状況を変えたのが、2010年代のクラウドDWHの普及です。変換をDWH内で行うELT(Extract → Load → Transformの順で処理する方式)が台頭し、IoTやWeb行動ログのリアルタイム処理も一般化しました。
ETLという言葉では捉えきれない多様な形が生まれた結果、それらを総称する言葉として「データパイプライン」が定着した、という経緯です。
データパイプライン導入のメリットと代表的なユースケース 「データパイプラインが必要」と言われても、投資判断をする側には具体に何が起きるのか が見えないと踏み切れません。実務でよく採用される用途を、目的別に整理します。
ユースケース 具体シーン 得られる効果 典型的な処理方式 BIダッシュボード自動更新 全社KPI/部門別売上/営業パイプラインの日次可視化 手作業CSV集計の廃止、意思決定の高速化 バッチ(日次・時間次) 不正検知・異常検知 ECの不正決済、工場センサーの異常、ログイン監視 数秒〜数分での検知、被害額と停止時間の圧縮 ストリーミング 機械学習の特徴量パイプライン 需要予測・LTV予測・レコメンドの入力特徴量生成 モデル精度の維持、学習・推論の再現性確保 バッチ+部分ストリーミング リバースETL DWHの分析結果をSalesforce/広告配信ツールへ書き戻す マーケ・営業現場の即時アクション化 バッチ 顧客360°ビュー統合 CRM/MA/サポート/購買履歴を顧客IDで名寄せして一元化 パーソナライズ、解約予兆の早期発見 バッチ+CDC 業務システム連携(EAI代替) 基幹→在庫→会計、SaaS間のマスタ同期 二重入力の廃止、月次締めの短縮 バッチ/イベント駆動
Evastの現場では、最初の1本目に選ばれやすいのはBIダッシュボード自動更新 と顧客360°ビュー統合 の2つです。効果が経営会議の場で目に見え、投資対効果を説明しやすいため、社内の合意形成が進みやすい傾向があります。逆に不正検知・特徴量パイプラインは、監視・冪等性の土台が整っていない段階で挑むと事故が増えるため、2本目以降に回すのが安全です。
データパイプラインは月いくら?規模別3パターンの相場と最小構成 「結局、うちで作るといくらかかるのか」。ユースケースの次に必ず出てくる質問です。ツール構成の詳細は後ろの章に譲りますが、先に月額の相場感 だけ押さえておくと、稟議や要件定義の初動が組みやすくなります。
Evastが直近12ヶ月で構築・引き継ぎした案件を、規模別に3パターンで並べると次のとおりです。
構成パターン 想定規模 連携 変換 オーケストレーション DWH 月額目安(SaaS+インフラ合計) 最小構成(スタータ) 月間30GB前後、SaaS 3〜5個 trocco Free / Airbyte OSS dbt Core Cloud Composer (small) BigQuery オンデマンド 月額3万〜10万円 標準構成(中堅) 月間300GB前後、SaaS 10〜20個 trocco 有償 / Fivetran dbt Core Cloud Composer / MWAA BigQuery オンデマンド or Snowflake XS 月額15万〜50万円 拡張構成(大規模) 月間3TB超、SaaS 30個以上 Fivetran / trocco Enterprise dbt Cloud MWAA / Astronomer Snowflake M以上 or BigQuery Editions 月額80万〜300万円超
金額はEvastの実案件からのおおまかなレンジで、データ量・利用頻度・ソースの種類によって上下します。特にFivetranは同期対象の月間アクティブ行(MAR)が想定を超えると請求が跳ねやすい ため、初期見積もりでは1.5倍のバッファを積むのが安全側です。
もう一つ、上の月額に含まれていないのが初期構築費 です。Evastの現場では、最小構成でも要件定義から本番投入まで200万〜500万円、標準構成で500万〜1,500万円が別途かかります。運用に入ってからのコスト削減の順序は本記事の後半(「コスト構造と削減の順序」の章)で、料金体系の比較はデータ統合ツールの料金比較|Fivetran・trocco・Airbyteの選び方 にまとめています。
「まずどの構成で始めるか」の判断は、次章で扱う設計3軸のうち変換の場所 と責任分担 にほぼ集約されます。順に見ていきます。
データパイプラインの設計3軸:「処理タイミング」「変換の場所」「責任分担」で分類する
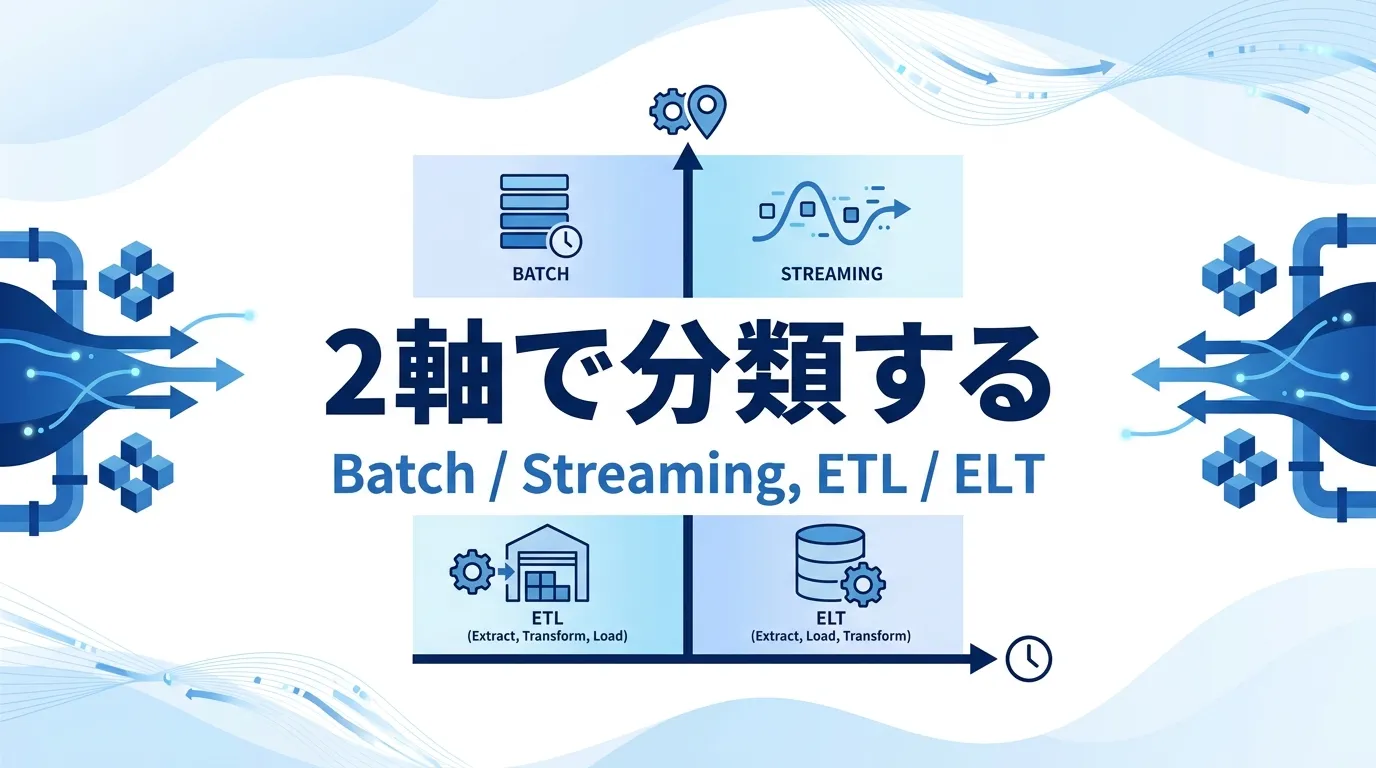
データパイプラインの分類軸はいくつも語られますが、2026年時点で実務の設計判断に直結するのは、処理タイミング ・変換の場所 ・責任分担 の3つに絞れます。順にバッチかストリーミングか、ETLかELTか、マネージド接続に任せるか自作コネクタを書くかという選択です。
3軸は独立しているので、「バッチ × ELT × マネージド」「ストリーミング × ETL × 自作」のように掛け合わせて設計します。
軸1 処理タイミング
バッチ日次・時間次でまとめて処理
or
ストリーミング発生の都度リアルタイム
軸2 変換の場所
ETL型DWH投入前に変換
or
ELT型DWHへ入れてSQLで変換
軸3 責任分担(マネージド or 自作)
マネージドETL/ELTFivetran・troccoなど接続を任せる
or
自作コネクタAirbyte・PythonでSaaS APIを叩く
3軸は独立して掛け合わせられる。「バッチ × ELT × マネージド」が最近の第一候補になりやすい
設計判断は「処理タイミング」「変換の場所」「責任分担」の3軸で整理する Evastが最近立ち上げるデータ基盤の8割は「バッチ × ELT × マネージド接続 」の組み合わせに落ち着きます。ストリーミングも自作コネクタも、要件が本当にそれを必要としているケースは思ったより少ないというのが実感です。順に見ていきましょう。
【分類軸1】処理タイミング:バッチ処理かストリーミング処理か バッチ処理は、1日1回や1時間に1回など、決まった間隔でデータをまとめて処理する方式です。日次の売上レポートやKPI集計のように「翌朝までに昨日分が見えればよい」用途では今も主流で、仕組みがシンプルなぶん開発・運用コストを抑えられます。
一方のストリーミング処理は、データが発生するたびに数秒〜数分以内で処理し続ける方式です。ECサイトの不正検知や工場センサーの異常検知など、データの鮮度がそのまま価値になる用途で使われます。Apache KafkaやGoogle Cloud Pub/Sub、Amazon Kinesisといった基盤が代表的ですが、バッチに比べて設計・運用の難易度は一段上がります。
迷ったら、まずバッチから始めるのが定石です。Evastの現場でも「リアルタイムで見たい」という初期要望を要件まで掘り下げると、実際には1時間ごとのバッチで十分だった、というケースが大半を占めます。
【分類軸2】変換の場所:ETL型かELT型か 変換をDWHに入れる前にETLツール側で行うのがETL型、生データを先にDWHへ入れてからSQLで変換するのがELT型です。BigQueryやSnowflakeといったクラウドDWHを使う構成では、DWHの計算能力を活かせるELT型が主流になっています。
どちらを選ぶかは、データ量・セキュリティ要件・分析要件の変化頻度などで判断が分かれます。5つの比較軸と選び方の判断基準は、ETLとELTの違いとは?5つの比較軸とELTが主流になった理由 にまとめています。
【分類軸3】責任分担:マネージドETL/ELTか、自作コネクタか 3つ目の軸は「接続部分を誰が面倒を見るか」です。SaaSや業務システムからデータを引き抜くコネクタ を、外部サービスに任せるのか、自社で書くのか。Evastの現場では、2026年の設計判断でいちばん見落とされがちなポイントです。
マネージドETL/ELT型 :Fivetran、trocco、Airbyte Cloudなどのサービスに、SaaS/DBからのコネクタ・スキーマ差分検知・再送を任せる。従量課金で高い代わりに、コネクタの追加・保守がほぼゼロコストになる自作コネクタ型 :Airbyte OSS、Embulk、Pythonスクリプト等でコネクタを書き、自社で運用する。ライセンス費は抑えられるが、SaaS側のAPI変更に追従する保守工数が長期でのしかかるEvastがバッチ × ELT × マネージド接続 を第一候補にする理由も、この軸にあります。DWH内部のSQL変換は自社の業務ロジックそのものなので内製すべき一方、SaaSとの接続部分は「壊れて直す」の繰り返しなので、月額を払って外に出したほうが総コストが安くなることが多いです。
一方で、大量のログや自社基幹の特殊フォーマットなど、マネージドサービスが対応していないソースだけは自作にする。マネージドを基本、例外だけ自作 という切り分けが、2026年の落としどころだと感じます。
補足:リバースETLなど用途に特化した派生パターンもある 3軸の組み合わせの上に乗る応用形として、覚えておきたい派生が2つあります。
ML向け特徴量パイプライン :機械学習モデルに入力する変数(特徴量)を生データから作り出す前処理の流れリバースETL :DWHに集めた分析結果を、Salesforceなどの業務システム側へ書き戻す逆方向の流れいずれも「データを自動で運び・加工する」という本質は同じで、データパイプラインの一種です。
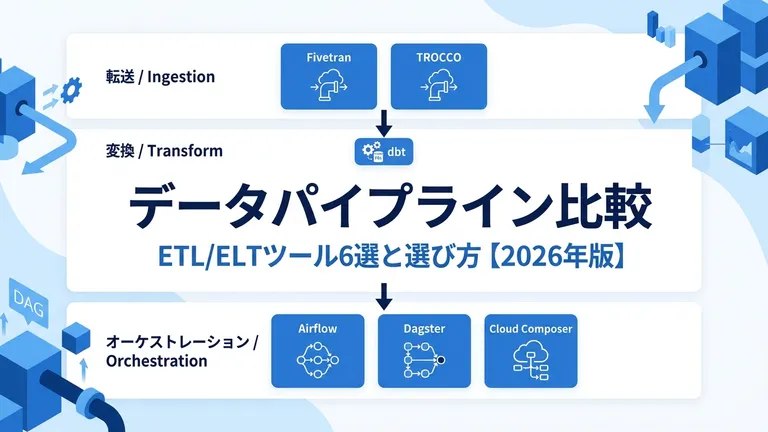
データパイプライン主要ツール比較:Fivetran・trocco・Airbyte・Airflow を用途別に整理 データパイプラインのツール選定は、単一の「最強ツール」を探すよりもレイヤごとに分けて選ぶ のが定石です。Evastの現場でも、レイヤの境界を意識せずに1つのSaaSに全部やらせようとした案件ほど、後で行き詰まりやすい印象があります。
分けるべきレイヤは、①データ連携、②変換、③オーケストレーション、④DWHの4つです。
レイヤ 代表ツール 料金体系の傾向 選定のポイント ①データ連携 Fivetran / trocco / Airbyte(OSS・Cloud) MAR(月間アクティブ行)課金・行数課金・従量課金 対応コネクタ数、SLA、増分連携の賢さ ②変換 dbt Core / dbt Cloud / Dataform 無償OSS or 開発者数課金 チーム開発のしやすさ、テスト機能、CI/CD統合 ③オーケストレーション Apache Airflow / Dagster / Prefect / Cloud Composer / MWAA OSS or マネージド従量課金 DAG設計の書きやすさ、監視UI、既存資産との相性 ④DWH BigQuery / Snowflake / Redshift / Databricks クエリ従量課金 or ウェアハウス稼働時間課金 スキャン量最適化のしやすさ、周辺エコシステム
大づかみに言えば、2026年時点で「無難な組み合わせ」は次のとおりです。
中小〜中堅企業のスタンダード :trocco(連携)× dbt Core(変換)× Cloud Composer or マネージドAirflow(オーケストレーション)× BigQuery(DWH)海外SaaSが多い企業 :Fivetran(連携)× dbt Cloud(変換)× Airflow(オーケストレーション)× Snowflake(DWH)OSS内製寄りの企業 :Airbyte OSS × dbt Core × Dagster × BigQuery/Snowflake各レイヤの深掘りは個別記事に譲ります。連携ツールの料金比較はデータ統合ツールの料金比較|Fivetran・trocco・Airbyteの選び方 にまとめています。ツール選定の判断軸を先に押さえたい方は、データ統合ツールの選び方|6つの評価軸と失敗しない進め方 から入るのが早いです。各ツール個別の深掘り(trocco料金/Fivetran節約術/Airflow・Dagster・Prefect比較/dbt Cloud vs Core など)はページ末尾の関連記事欄に集約しました。
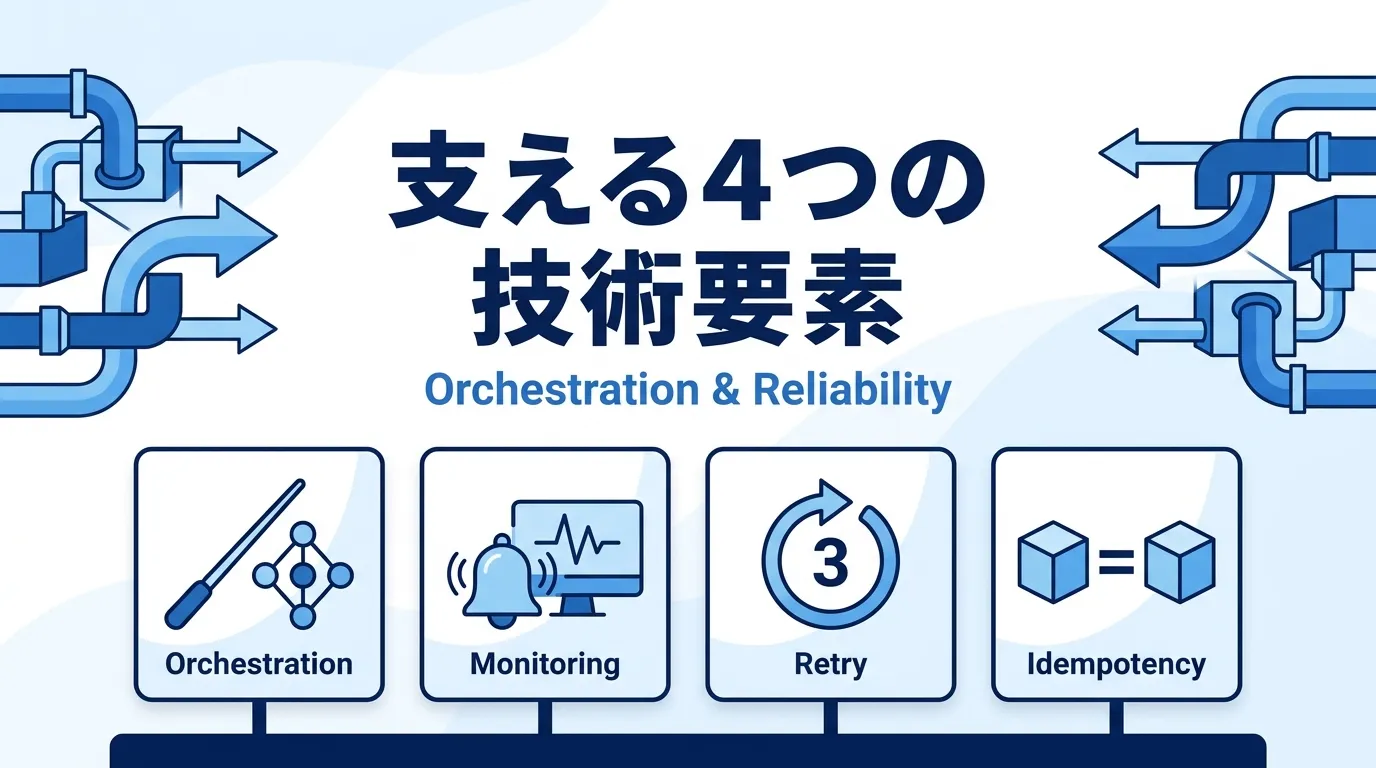
データパイプラインを支える4つの技術要素:オーケストレーション・監視・リトライ・冪等性
パイプラインは「作って終わり」ではなく「毎日動かし続ける」ものです。Evastのプロジェクトでも、工数の感覚としては初期構築が3割、安定運用の仕組みづくりが7割という配分になることが珍しくありません。
動かし続けるために押さえるべき技術要素は、次の4つです。
【技術要素1】オーケストレーション:Airflowなどで実行順序と依存関係を一元管理する オーケストレーション(複数の処理を正しい順序・タイミングで実行するよう指揮する仕組み)は、パイプライン運用の中枢です。「売上データの取り込みが終わってから集計を始める」といった依存関係をDAG(有向非巡回グラフ。処理同士の順序関係を表す図)として定義すると、ツールが実行順序を自動で制御してくれます。
代表的なツールは、2015年にAirbnb社がオープンソース化した Apache Airflow です。事実上の標準として広く使われており、Google CloudのCloud Composer、AWSのAmazon MWAAなど、Airflowをマネージドサービス(運用をクラウド側に任せられる提供形態)として使える選択肢も揃っています。
後発のオープンソースであるDagsterやPrefectは、開発のしやすさやテスト機能を強みに採用が増えています。設計思想の違いと選び方は、ページ末尾の関連記事欄で詳しく整理しています。
OS標準のスケジューラであるcron(決まった時刻にコマンドを実行する仕組み)との違いは、「依存関係を知っているかどうか」です。cronは時刻しか管理できないため、前段の処理が失敗していても後段が平然と動いてしまいます。
【技術要素2】監視:「止まったこと」「データが古いこと」に即座に気づく 監視は、独立した章として後ろで詳しく扱います(「データパイプラインの監視」の章)。ここでは技術要素の位置づけだけ押さえておいてください。
基本は「ジョブの死活監視」と「データの鮮度チェック」の2点セットです。パイプラインが止まってもダッシュボード自体は古いデータで表示され続けるため、ジョブ通知だけでは「画面は出ているのに中身が止まっている」状態に気づけません。データの状態そのものを検査する仕組みまで含めて、はじめて監視が成立します。
【技術要素3】エラー処理とリトライ:一時的な失敗は自動で再実行する リトライ(失敗した処理の自動再実行)は、運用負荷を下げる基本装備です。連携先APIのタイムアウトやネットワークの瞬断といった一時的なエラーは、「5分間隔で最大3回」のように間隔をあけて再実行するだけで成功することが多いためです。
Airflowなどのオーケストレーションツールでは、タスク単位でリトライ回数と間隔を設定できます。一方、連携元のレイアウト変更のような恒久的なエラーはリトライでは直らないため、規定回数で打ち切って人に通知する設計が必要です。
【技術要素4】冪等性:同じ処理を2回実行しても結果が変わらないように作る 冪等性(べきとうせい。同じ処理を何度実行しても結果が同じになる性質)は、リトライや手動再実行を安全にするための前提条件です。
たとえば追記(INSERT)だけで作られたパイプラインを再実行すると、同じデータが二重に取り込まれます。対象日のデータをいったん削除してから入れ直す「洗い替え」や、キーが一致すれば更新・なければ挿入するMERGE(Upsert)処理を使えば、何度実行しても結果は同じに保てます。
リトライ(技術要素3)を安心して使えるのは、冪等性が確保されているからこそです。4つの要素は独立した部品ではなく、互いに支え合う関係にあります。
データパイプライン監視の3階層 データパイプラインの監視は、次の3階層に分けて整理すると設計と運用の見通しが一気に良くなります。ジョブは動いているのに数字が古い、という「サイレント障害」の多くは、下の階層の監視が抜けていることが原因です。
階層 監視対象 代表ツール・機能 導入順序 月額目安 ①ジョブ死活 実行の成否・処理時間 Airflow標準通知+Slack、Datadog、PagerDuty 最初 実質0円(Slack無償枠) ②データ鮮度 最終更新時刻・遅延・欠損の有無 dbt source freshness、BigQuery INFORMATION_SCHEMA 2番目 実質0円(dbt Core) ③データ品質 件数の急減、値の分布ズレ、欠損急増 dbt tests、BigQuery ML、Monte Carlo、Anomalo 3番目 無償〜月額20万円超(専用SaaS)
Evastが現場に入るときも、ほぼ全案件でこの順番で入れていきます。まずSlack通知、次にdbt source freshness、そのあとで異常検知 。逆順にすると「豪華な監視SaaSを入れたのに、そもそもジョブが失敗してもSlackに来ない」というちぐはぐな状態になりがちです。
いつから専用オブザーバビリティツールを検討するか Monte CarloやAnomaloのような専用サービスは、月額が数十万円〜と一気に上がります。目安として、データソースが20を超えて、dbt testsだけでは異常が拾いきれなくなってきた段階 が導入検討のタイミングです。それ以前は、dbt Core+Airflow+Slack+簡単なBigQuery異常検知SQLで十分機能します。
5つの観点、ツール比較、費用感、始め方の手順はデータオブザーバビリティとは?データ品質監視の5つの柱と始め方 にまとめました。
データパイプライン自動化の5段階と人の責務 「データパイプラインを自動化する」と一口に言っても、実際には自動化のレベルに段階 があります。どこを目指すかで必要な投資も違えば、残る人の仕事の中身も変わります。
自動化の5段階(Lv1〜Lv5)と工数削減目安 Lv 状態 典型的な構成 従来比の工数削減目安 1 手作業CSV運用 Excel+共有フォルダ+人海戦術 基準(100%) 2 スクリプトによる部分自動化 Pythonスクリプト+cron ▲30〜40% 3 オーケストレーション導入 Airflow/Dagster+dbt+DWH ▲60〜70% 4 マネージドELT+監視の統合 Fivetran/trocco+dbt+Airflow+dbt tests ▲70〜80% 5 AI連携による障害一次対応・異常検知の自動化 Lv4+LLM連携(ログ要約・再実行提案・異常検知) ▲80〜90%
Evastの現場感覚だと、いま多くの企業が目指すのはLv4 です。Lv5は魅力的ですが、そもそもLv3〜4の土台(冪等性・DAG化・監視)がないところに乗せても効果は出ません。
自動化できる範囲と、人に残る責務 自動化で置き換えられるのは、次のような繰り返し実行される作業 です。
データの収集・変換・格納 ジョブの実行順序制御と失敗時のリトライ 監視・アラート・一次切り分け(AIエージェント併用) 定型レポートの生成・配信 一方、人にしかできない責務 として残るのは次の領域です。
要件定義:どの指標を、どの粒度で、誰のために出すか 業務ロジックの検証:SQLの数値が本当に事業実態と一致するか データ品質基準の策定:どこまでズレたら異常とみなすか 新規分析設計:まだ誰も見ていない切り口を発見する 自動化で浮いた工数は削減対象にせず、この「価値創出側」に再配分するのが定着のコツです。
データパイプラインのAI活用|SQL自動生成・異常検知・障害対応 ここ1〜2年で、データパイプラインの作り方はAIコーディング補助と生成AIの前提 を織り込んだものに変わってきました。「AIに任せる部分」と「人が最後に見張る部分」を最初から分けて設計するのが、2026年の現場の共通認識だと思います。実務で効いてくるのは、次の3つの変化です。
変化1:dbtモデル・変換SQLの初稿はAIに書かせる もっとも普及しているのは、Claude CodeやGitHub Copilot、CursorといったAIコーディング補助にdbtモデル・変換SQL・テストコードの初稿を書かせる進め方です。カラム定義とサンプルデータ、狙う集計軸を渡せば、SELECT句とJOIN条件、{{ ref() }} を含んだdbtモデルまで一気に書いてくれます。
人の仕事は、業務ロジックが正しいかのレビューと、テスト(unique / not_null / relationships)の追加に集中させる。「一次原稿ゼロベース」の負担が消えたぶん、設計と検証にかける時間が実質2倍 になった感覚があります。
変化2:異常検知・データ可観測性がAIで手が届く価格帯になった 以前は、データの中身の異常(件数急減、値の分布のズレ、欠損の急増など)を検知する「データ可観測性」ツールは、Monte CarloやAnomaloなど月額が高い専用サービスが中心でした。2025年以降は、dbtにMLベースの異常検知が組み込まれたり、BigQuery上で軽量なMLモデルを回して閾値を自動決定したり、生成AIに集計結果の要約と異常アラートを書かせるといった手作りの中間解 が現実的な選択肢になっています。
まず失敗通知とデータ鮮度監視から入り、対象データが増えてきたら、AI/MLを使った中身の監視に段階的に広げる。この順番は数年前から変わっていませんが、中身の監視のハードルが確実に下がった のが2026年時点の変化です。
変化3:障害調査でAIエージェントに一次切り分けを任せる Airflow・Dagster・Prefectの失敗ログをそのままAIに投げて、「どこで詰まったか」「一時的か恒久的か」「安全に再実行できそうか」の一次切り分けをさせる運用が増えてきました。エージェントに実行環境まで渡している現場では、ログ確認から再実行スクリプトのドラフトまでを人の手前で仕上げてくるところまで来ています。
ただし、冪等性が確保できていないパイプラインに再実行の判断まで任せるのは危険 です。この変化を安全に取り込むためにも、前章の「監視・リトライ・冪等性」の3点セットが土台として効いてきます。
AI連携の話は「新しい設計軸」というより、既存の技術要素の上にAIをどう安全に乗せるか という運用改善に近い、というのが実務での感覚です。基盤自体をゼロから設計するときの土台については、ページ末尾の関連記事欄をご参照ください。
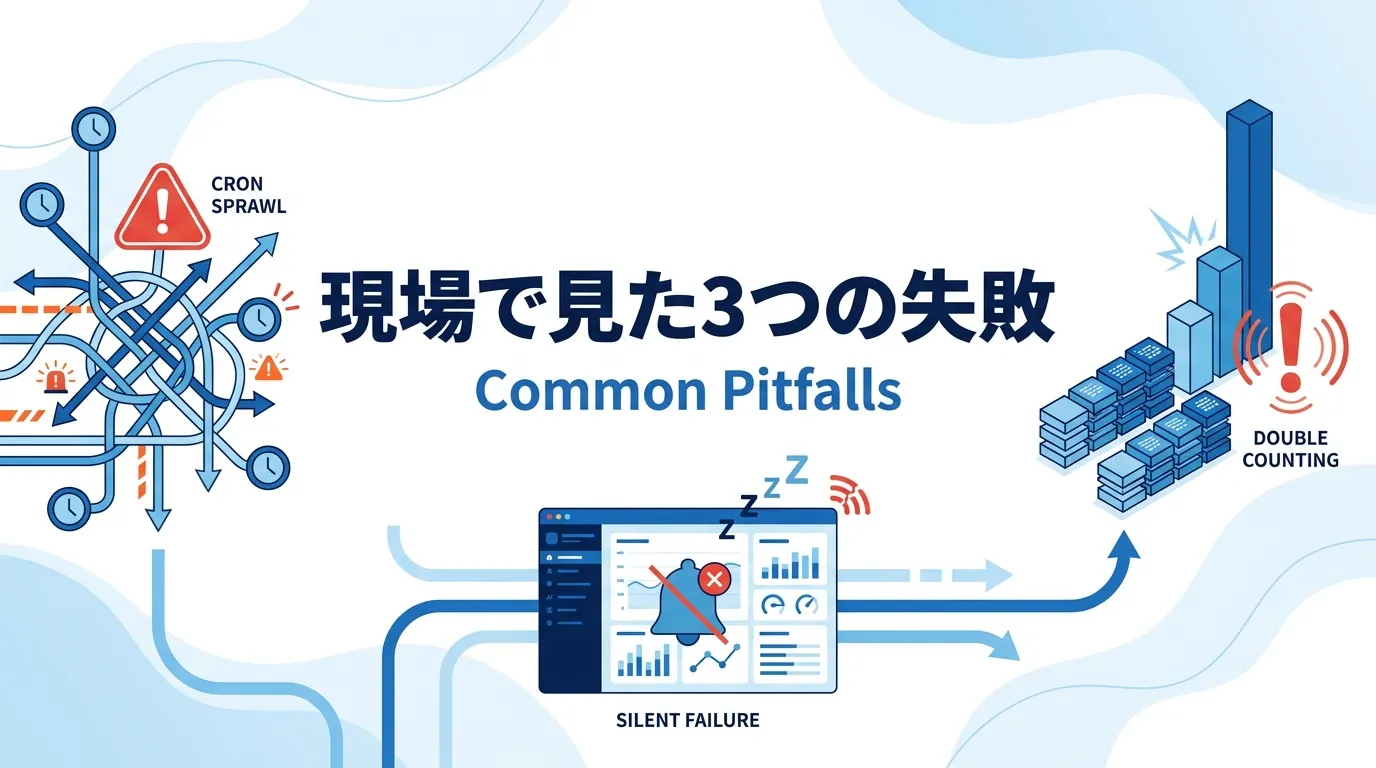
データパイプライン設計・運用の3つの落とし穴
技術要素を押さえていても、設計と運用ルールを誤ると現場は混乱します。私たちが基盤の立て直し支援で実際に遭遇した失敗を、3つ紹介します。
【設計・運用の失敗1】cronとシェルスクリプトの乱立で、誰も全体像を把握できなくなる ある企業では、5年かけて少しずつ増えたcronジョブ(シェルスクリプトの定時起動)が30本を超え、実行順序が「Aは深夜2時、Bは3時開始だから間に合うはず」という暗黙の時刻調整だけで保たれていました。データ量の増加でAの処理が3時を超えるようになった途端、後続が連鎖的に欠損し、原因特定に数日を要しました。
ジョブ間の依存関係が誰の頭の中にもない状態は、担当者の異動・退職で一気にブラックボックス化します。ジョブが10本を超えたあたりで、オーケストレーションツールへの移行と依存関係のコード化を検討してください。
【設計・運用の失敗2】パイプラインの失敗に1週間誰も気づかない「サイレント障害」 通知を仕込んでいない、あるいは通知が多すぎて誰も見なくなっている。どちらのパターンでも、結果は「気づかれない障害」です。前述のとおりダッシュボードは古いデータのまま表示され続けるため、経営会議の場で「この数字、先週から動いていなくないか」と指摘されて初めて発覚した例もあります。
対策はシンプルで、失敗通知とデータ鮮度監視を最初から組み込み、通知は「人が必ず見るチャンネル1つ」に絞ることです。通知の乱発はオオカミ少年化を招くため、警告レベルの整理も合わせて行いましょう。
【設計・運用の失敗3】障害復旧の再実行で、売上データが二重計上される 障害からの復旧時にバッチを手動で再実行したところ、その日の売上データが二重に取り込まれ、翌月のレポートの数字が合わないことで発覚した。冪等性を後回しにした典型的な失敗です。信頼を一度失ったダッシュボードは、数字が直った後もなかなか使ってもらえません。
「このパイプラインは再実行しても安全か?」を設計レビューの必須観点に加え、洗い替えやMERGEを標準パターンとして整備しておくことが予防策になります。
通信・Web業界のデータパイプライン活用:アクセスログ・イベントログの集約とリアルタイム分析 通信・Web業界では、扱うデータの多くがアクセスログ・イベントログ です。1日で数千万〜数億レコードに達することも珍しくなく、汎用的なCSV連携では処理が追いつきません。バッチとストリーミングを組み合わせたハイブリッド構成が主流になります。
Evastの現場でよく採用する典型構成は、次の3つです。
GA4系分析 :GA4 → BigQuery Export(日次エクスポート+ストリーミングエクスポート)→ dbtで変換 → BIダッシュボード。ノーコードで組めるため最初に着手しやすいアプリイベント基盤 :アプリ/Web → Cloud Pub/Sub(メッセージング)→ Dataflow(ストリーミング処理)→ BigQuery。数分遅延でユーザー行動を可視化。不正検知や離脱アラートに使いやすいCDN・サーバーログ基盤 :CDN/Nginxログ → S3 → Athena or Glue → Redshift/BigQuery。アクセス傾向の分析、DoS検知、キャッシュヒット率の改善に活用構成のポイントは、「翌朝までに前日分」と「数分以内のリアルタイム」を同じ基盤で無理に統一しないこと です。日次バッチをベースにしつつ、リアルタイムが必要な指標だけストリーミングパイプラインを追加で通す2段構えのほうが、運用も課金も安定します。
DWHに集めたユーザー行動データを、業務システム(CRM・広告配信ツール等)へ書き戻すリバースETLの活用も進んでいます。詳細はページ末尾の関連記事欄からご覧いただけます。
データパイプラインのコスト構造と削減の順序(DWH・ETL・転送・工数の4要素) データパイプラインの月額コストが膨らむ要因は、細かく見ると4つの要素 に分解できます。どの要素にどれだけ効いているかを把握せずにツールを乗り換えても、たいてい期待した効果は出ません。
要素 主な費用 削減の勘所 ①DWHスキャン量 BigQueryオンデマンド、Snowflake稼働 パーティション/クラスタリング、SELECT句のカラム限定、増分ロード ②ETL/ELTサブスク Fivetran MAR、trocco転送量、Airbyte ソース側でフィルタ、不要テーブル除外、同期頻度の見直し ③ストレージ・転送量 GCS/S3、リージョン跨ぎ転送料 古いパーティションの階層化、同一リージョン運用の徹底 ④オーケストレーション工数 Airflow運用の人件費 DAGのテンプレ化、モデル統廃合、AIによる障害一次対応の導入
Evastの経験則では、削減インパクトの8割は①DWHスキャン量 に集中します。BigQueryの現場で「先月からいきなり請求が跳ねた」という相談の9割は、パーティションフィルタが効かないクエリか、SELECT * の大量スキャンが原因です。まず①を徹底的に締めてから、②のMAR削減、③④の順に手を広げるのが費用対効果の高い順序になります。
BigQueryの詳細な最適化手順、FivetranのMAR課金対策、データ基盤全体のランニングコスト見直し、運用・保守フェーズでの継続的な見直しについては、ページ末尾の関連記事欄に集約しています。
現状のパイプラインのランニングコスト、一度点検しませんか 「請求が徐々に上がってきているが、どこを直せば効くのかわからない」というご相談は毎月いただきます。Evastでは、BigQuery請求ログとFivetran/troccoのMARレポートを一緒に見ながら30分で診断 するランニングコスト診断を無償で行っています。まずは現状把握から、というご相談で構いません。
→ Evastのランニングコスト診断(無料・30分)を申し込む
データパイプラインの導入ステップ:スモールスタート5段階と失敗しないチェックリスト 「自社にもデータパイプラインを導入したい」と考えたとき、最初から全社・全データを対象にすると、要件が膨らんで頓挫しがちです。Evastの現場で失敗が少ないのは、次の5段階のスモールスタート です。
対象業務を1本に絞る :稼働ログの日次集約、店舗POSの本部連携など、成果が見えやすい1業務を選ぶ要件と鮮度SLAを言語化する :誰が・何時までに・どの粒度で見るのか。SLA(Service Level Agreement)を「翌朝9時までに前日分」のように定量化するツール選定 :4レイヤ(連携・変換・オーケストレーション・DWH)ごとに、規模と料金体系で決める初期構築+監視を同時投入 :ジョブ死活監視・データ鮮度監視は、後付けにせず最初のリリースに必ず含める段階的に対象データを拡大 :1本目が3ヶ月以上安定稼働してから、2本目・3本目を追加していく業種別のスモールスタート例を挙げると、次のようなイメージです。
製造業 :各設備の稼働ログを1本のパイプラインで日次集約し、稼働率ダッシュボードにつなぐ通信・Web系 :GA4→BigQuery Exportで前日分のユーザー行動を翌朝までに見られるようにする小売・多店舗 :店舗ごとに散らばるPOSデータを本部のDWHへ自動連携し、全店の売上を一元把握するPoCの進め方、内製と外注の判断軸、業種別の詳細事例は、ページ末尾の関連記事欄で整理しています。
導入前チェックリスト15項目 構築を始める前に、次の15項目を1つずつ確認しておくと、後から大きな手戻りが起きにくくなります。
データ源と権限(1〜5)
対象データ源(SaaS、DB、ログ)を一覧化したか 各データ源の認証情報の管理者(誰がAPIキー・接続情報を持つか)が明確か コネクタが公式に対応しているか、自作が必要か切り分けたか 個人情報・機密情報の含有有無を確認し、マスキング要否を決めたか データ源側のAPIレート制限・料金体系を把握しているか 鮮度・量・変換(6〜10)
鮮度SLA(何時までに前日分か、リアルタイムか)を業務側と合意したか データ量(初期ロード・日次増分)の見積もりを取ったか 増分ロードの方法(更新日時・IDベース・CDC)を決めたか 変換ロジック(型変換・名寄せ・集計軸)を要件定義したか データテスト(NOT NULL、UNIQUE、参照整合性)の観点を洗い出したか 運用・DR・コスト(11〜15)
ジョブ失敗時の通知先(Slackチャンネル・担当)を決めたか データ鮮度監視の閾値と通知条件を決めたか 障害時のリラン手順と冪等性の担保方法をレビューしたか バックアップ・DR(Disaster Recovery)方針を決めたか 月額ランニングコストの見積もりと上限アラートを設定したか まとめ
データパイプラインの定義、ETLとの違い、代表ユースケース、2026年の設計3軸、主要ツール比較、監視・コスト・自動化・導入までを整理しました。要点は次の8つです。
定義 :データを発生源から利用先まで自動で運び・加工する処理の連なりETLとの違い :対立ではなく包含関係。ETLはデータパイプラインの代表的な一種ユースケース :BI自動更新/不正検知/ML特徴量/リバースETL/顧客360°/業務連携設計3軸 :処理タイミング(バッチ/ストリーミング)・変換の場所(ETL/ELT)・責任分担(マネージド/自作)主要ツール :4レイヤ(連携/変換/オーケストレーション/DWH)に分けて選ぶ監視 :ジョブ死活 → データ鮮度 → データ品質の3階層を段階導入コスト :DWHスキャン量削減が8割。次にETLサブスク、最後にツール切り替え自動化とAI :Lv1〜Lv5の到達目標を決め、冪等性の土台の上にAIを乗せるパイプラインは作った瞬間がゴールではなく、毎日動き続けて初めて価値を生みます。今日の設計判断は、「止まったとき誰がどう気づき、どう復旧するか」まで描けているかを一度確認する視点で見直してみてください。
関連記事 基礎・全体像
ツール個別の深掘り
コスト・運用
導入・体制
データパイプラインの設計・構築のご相談はEvastへ 株式会社Evastでは、データパイプラインの設計からオーケストレーション整備、DWH構築、BIダッシュボード開発まで、一貫したデータ基盤構築 を支援しています。「止まったとき誰がどう気づき、どう復旧するか」まで見据えて、現状診断からアーキテクチャ設計、運用体制づくりまでを伴走します。
こんなお悩みがあれば、お気軽にご相談ください。
「手作業のデータ集計を自動化したいが、何から始めるべきかわからない」 「cronジョブが乱立し、データ連携がブラックボックス化している」 「Airflowやdbtを使ったモダンなパイプラインに刷新したい」 「BigQuery・Fivetranの請求が徐々に膨らんでいるが、どこから削ればよいかわからない」 まずは「現状のパイプラインが本当に毎日動いているか」を、Evastが一緒に点検します。以下のいずれかからご相談ください。
→ データ基盤構築サービスを見る Evastのランニングコスト診断(無料・30分)を申し込む データ基盤・パイプラインの無料相談