リバースETLとは:DWHのデータを業務ツールに「戻す」仕組み
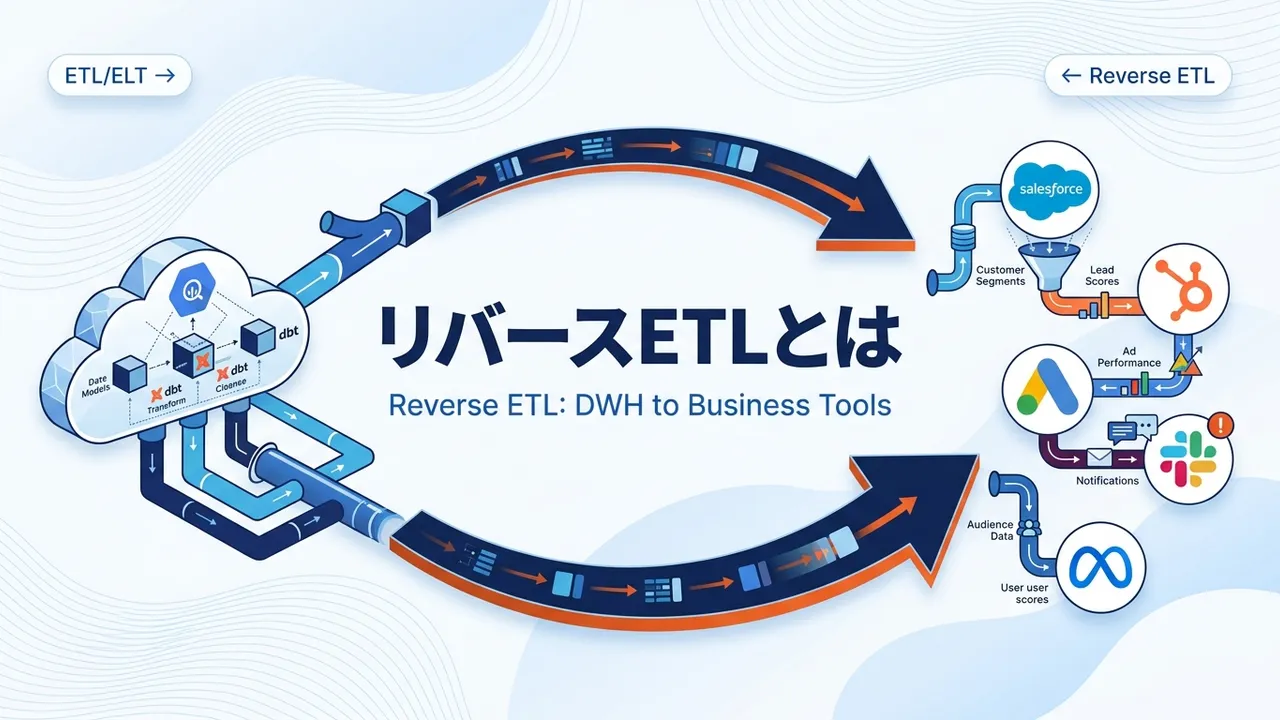
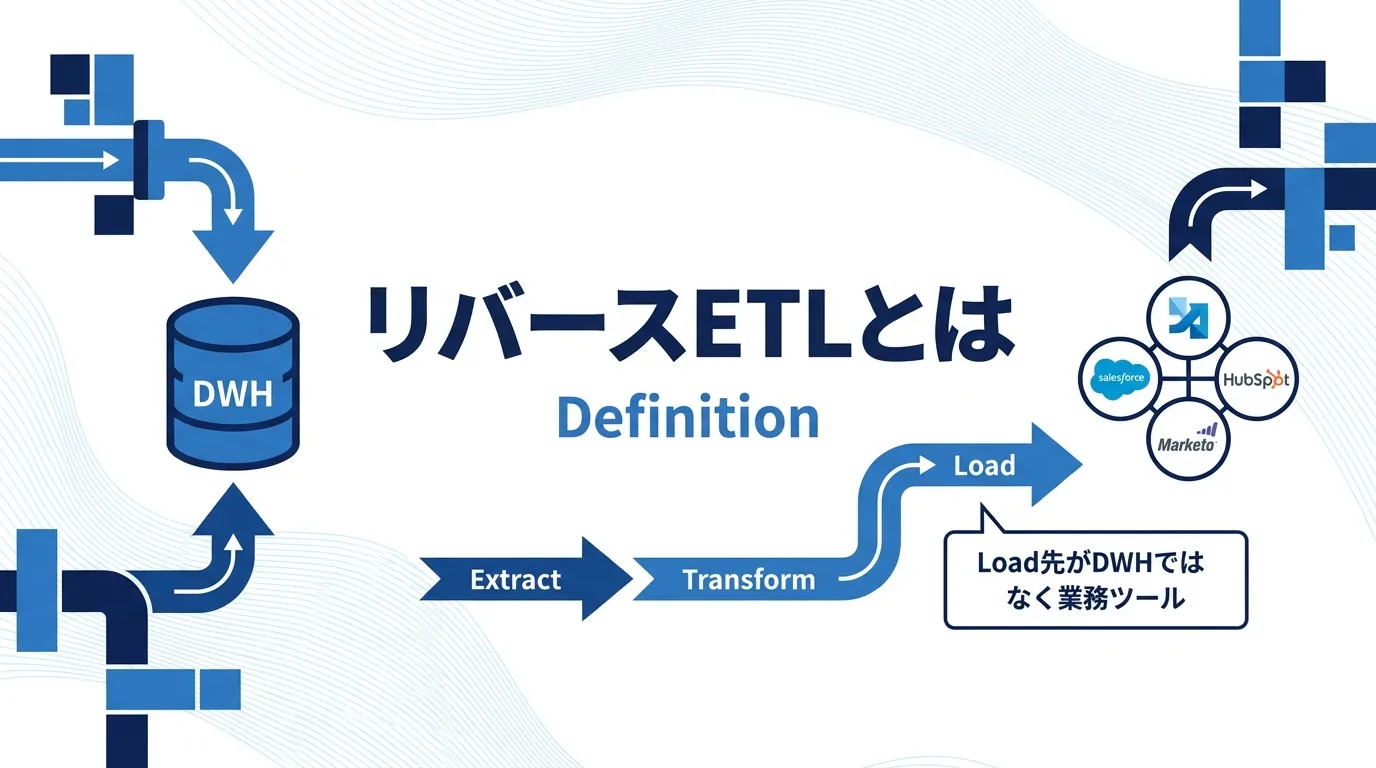
リバースETLとは、DWH(データウェアハウス)に集約したデータを、SalesforceやHubSpot、Marketoなどの業務ツールに同期する仕組み を指します。Extract(抽出)・Transform(変換)・Load(格納)という3工程は同じですが、Loadの対象がDWHではなく業務ツールになる点が名前の由来です。
Modern Data Stack(クラウドサービスを組み合わせて構築する現代型のデータ基盤パターン)における位置は、次の図のようになります。
データソース
SaaSSalesforce / HubSpot
DBMySQL / PostgreSQL
ログWeb / アプリ
DWH(真実の源)
BigQuery / Snowflakedbtで整形されたモデル
業務ツール
Salesforceセグメントタグ
HubSpotスコア
広告媒体オーディエンス
ETL・ELTで集めたデータを、リバースETLで業務ツールへ戻す 左半分(データソースからDWHまで)を担うのがETL・ELTです。この違いはETLとELTの違いとは?5つの比較軸とELTが主流になった理由 で整理しています。右半分(DWHから業務ツールへ)を担うのがリバースETLで、この2つが揃って初めて「DWHで整えたデータを現場で使える」流れが完成します。
なお、Modern Data Stackという言葉自体は、FivetranやSnowflake、dbtといったクラウドサービスを組み合わせるアプローチの総称として2020年前後から使われるようになった呼び名です。特定の製品を指すわけではありません。
なぜ「リバース」と呼ぶのか 従来のETLはオンプレミスの基幹システムから月次バッチでDWHに集め、DWHの中でレポートを作って完結、というのが典型でした。データの流れは「業務システム→DWH→BI」で一方通行です。
これに対し、リバースETLではDWHで整理したセグメントやスコアを、業務ツールに「押し戻す」形で送ります。データの流れが業務システム側へ戻るように見えるため、Redpoint Ventures の Astasia Myers が2020年ごろ に「Reverse ETL」と名付けたと言われています。以後、Hightouch・Censusといった専業ツールの登場と歩調を合わせて、業界用語として定着しました。
なぜ今リバースETLが必要とされているのか
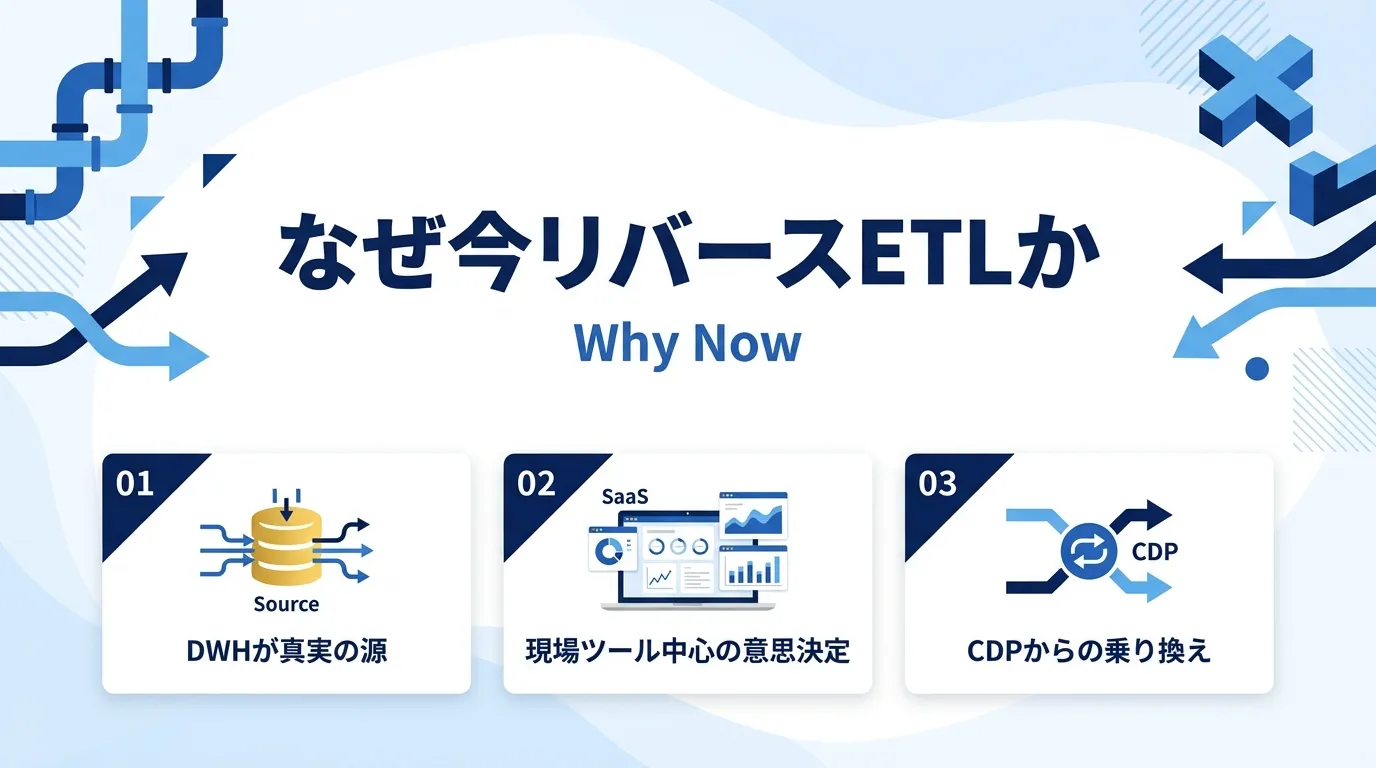
リバースETLの概念自体は目新しいものではありません。DWHのデータを業務ツールに戻す試みは、SQL Server Integration Services(SSIS)の時代からありました。ではなぜ2022〜2026年 にかけて急に注目されているのか。背景は3つあります。
背景1:DWHが「真実の源」になった 過去10年でBigQuery・Snowflake・Redshiftといったクラウド DWH の性能が向上し、コストも下がりました。企業がSaaSやログデータを片端からDWHに集めるようになり、「売上」「顧客」「解約率」といった重要指標の計算は、いつのまにかDWH内のdbtモデルが唯一の正解 になっています。
このとき業務ツール(Salesforceなど)に入っている数値は、DWHで計算されたものと必ずズレます。営業画面で見える売上は個別案件の受注金額の合計、DWHで計算されるのは会計基準に沿った月次売上、といった具合です。
現場の判断はSaaSの画面で行われているのに、正しい指標はDWH側にしかない 。このねじれを解消するのがリバースETLの最初の存在意義でした。
背景2:現場ツールでの意思決定が主流になった 営業はSalesforce、マーケはHubSpot、カスタマーサクセスはIntercom、広告はGoogle広告・Meta広告。担当者は1日中これらの画面と向き合っていて、BIダッシュボードを開くのは週に1度あるかどうかです。
「DWHにデータを集めれば分析文化が育つ」という期待は、多くの組織で裏切られてきました。dbt Labsが提唱した「data activation(データの活性化) 」という言葉が広まったのは、集めるだけでは行動につながらないという現場感の共有があります。
データを見に行くのではなく、判断の場に届ける。この方針転換の実装がリバースETLです。
背景3:CDPからの乗り換えニーズ 顧客データ基盤(CDP、Customer Data Platform)は2010年代後半に注目を集めましたが、独自のデータベースを持つため、DWHとCDPで顧客データが二重管理になる問題 を抱えていました。
DWHに既にdbtで顧客モデルが揃っている組織は、「そのモデルをそのまま業務ツールに配信できれば、CDPは要らないのでは?」と考えるようになります。ここに応えたのがリバースETLで、Hightouchは自らを「Composable CDP」(構成可能なCDP)と表現し、CDPの機能をDWHとリバースETLの組み合わせで実現するアプローチを打ち出しています。
CDPとの詳しい違いは後述しますが、DWHにデータマネジメントの重心を寄せたい組織にとって、リバースETLは自然な選択肢になっています。
リバースETLの代表的なユースケース5選
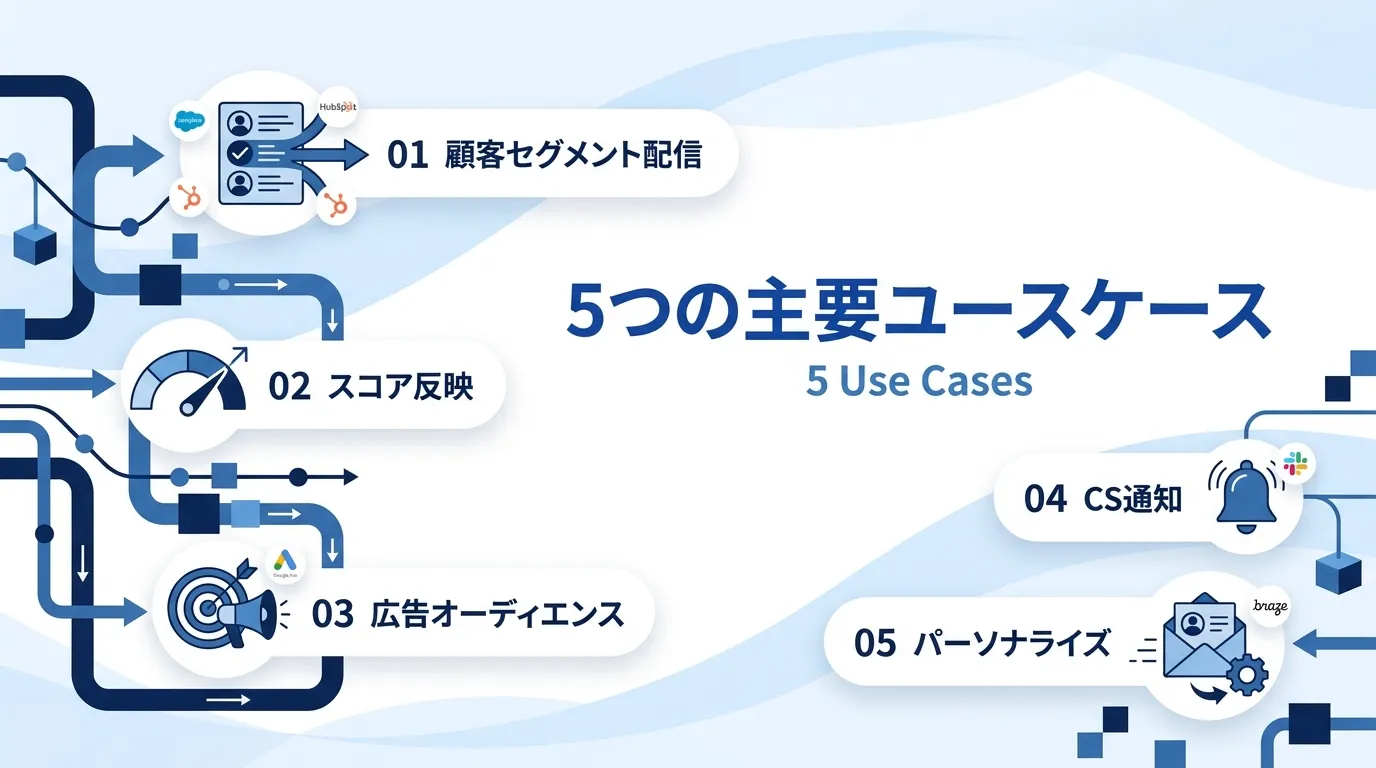
具体的にどんな使い方をされているのか、頻度の高い順に5つ整理します。DWHで計算した結果を「どの業務ツールの何に反映するか」がユースケースの中身です。
DWHのdbtモデル
customer_ltv
churn_risk_score
product_usage_trend
→
ユースケース
セグメント配信LTV上位を Salesforce へ
スコア反映チャーンリスクを Zendesk へ
広告オーディエンス既存顧客を Google / Meta へ
CS通知利用低下を Slack へ
パーソナライズ属性を Braze / Iterable へ
DWHのモデルから、業務ツールへの5つの主要ユースケース ユースケース1:顧客セグメントの営業ツールへの配信 もっとも多いのがこれです。DWHで「LTV上位10%」「直近3か月で購入額が2倍に伸びた顧客」といったセグメントを定義し、Salesforceの顧客レコードにタグとして書き戻します。
営業は「LTV上位」フィルタでリスト表示できるため、限られた工数を優先度の高い顧客に振り向けられます。マーケ側も同じセグメントをHubSpotのリストに配信して、キャンペーン対象に含める、といった使い方ができます。
Evastで担当した SaaS 事業者では、この仕組みを入れてから解約防止アプローチの対象選定が「営業の勘」から「LTVスコアと利用トレンドの掛け合わせ」に変わり、対象顧客あたりの継続率が改善しました。
ユースケース2:スコアの反映(チャーンリスク・リード優先度) DWHでプロダクト利用データや過去の解約パターンから算出したチャーンリスクスコアを、SalesforceやZendesk、Intercomなど接点となるツールに書き戻します。
カスタマーサクセスチームは、リスク上位の顧客に対して先回りのミーティングを設定できます。営業のリードスコアリング(見込み顧客の優先度付け)も同じ発想で、DWHの複合スコアをHubSpotのプロパティに反映するのが典型例です。
ユースケース3:広告オーディエンスの自動更新 DWHで作った顧客セグメントを、Google広告のカスタマーマッチ、Meta広告のカスタムオーディエンスに自動同期します。既存顧客の除外配信、休眠顧客への再アプローチ、LTV上位顧客に類似するオーディエンスの生成(Lookalike)といった運用が、SQLの更新だけで回る ようになります。
広告運用の視点では、広告レポート自動化ツールの比較と選び方 で扱っているレポート自動化・入札最適化とセットで、「DWHで意思決定→広告媒体に反映」という循環を組めるのが強みです。
ユースケース4:カスタマーサクセスへの利用シグナル配信 プロダクトの利用状況(週次アクティブユーザー数、機能利用の変化、エラー発生率など)をDWHで集計し、変化があった顧客だけをSlackのCS部屋やSalesforceのタスクに投げます。
「先月まで週5回使っていた機能が今月は0回になった」といった変化は、DWHでSQLを書けば1行で検出できます。この変化を人が気づく前にツール側に届けることで、離脱の予兆に対して行動できるようになります。
ユースケース5:メール・アプリ内メッセージのパーソナライズ Braze・Iterable・Customer.ioなどの配信ツールに、DWHで整えた最新の顧客プロファイルを流し込みます。「過去30日で購入したカテゴリ」「利用中プラン」「次回契約更新日までの残日数」といった情報を、配信ツール側で条件分岐やパーソナライズに使えるようになります。
配信ツールが自前で持つセグメント機能では複雑な条件が組めないことが多く、DWHでSQLを書いて属性を渡す方が現実的、というケースはよくあります。
リバースETLとCDPの違い
判断でよく迷うのがCDP(顧客データ基盤、Customer Data Platform)との使い分けです。両者は目的が近いため、選定時に「どちらが自社に合うか」の判断が要ります。
主な違いを表で整理します。
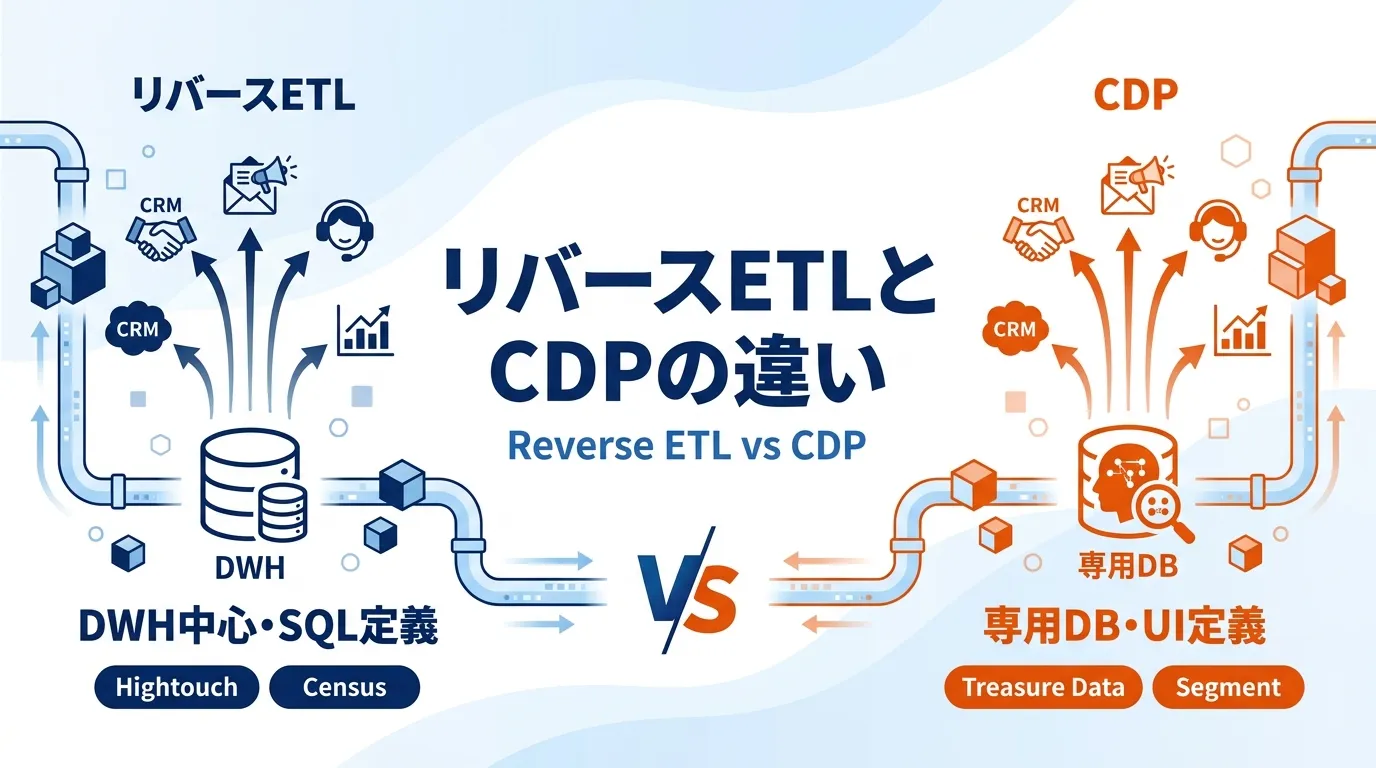
比較軸 リバースETL CDP データの置き場 DWHをそのまま真実の源として使う 専用のデータベースにコピーする セグメント定義 SQL(dbt)で定義 画面上のUI(クリック操作)で定義 主な利用者 データチーム・アナリティクスエンジニア マーケター・キャンペーン担当 代表製品 Hightouch / Census / RudderStack Treasure Data / Segment / Adobe Real-Time CDP 導入コスト DWHが前提。既にあれば低い CDP自体の導入・データ投入・運用が必要 向くケース dbtで指標整備が進んだ組織 DWHがまだない、または非エンジニア主導で回したい組織
CDPは、DWHを持たなくても顧客データを一元管理できる自己完結型の製品として設計されています。マーケターが画面操作でセグメントを作れる操作性 が最大の強みです。
リバースETLは、DWHが真実の源として先にある前提で、その内容を業務ツールに配信することに徹します。既にdbtで整えた指標を再定義する必要がない、DWHが持つ計算力とガバナンスをそのまま活かせる、という点でエンジニアリング寄りの組織に好まれます。
「既にBigQueryとdbtで基盤ができている」「マーケ用途以外にも顧客データを使う(分析・レコメンド・BI)」という組織はリバースETLが自然です。「DWHがまだない」「マーケター単独で回したい」という組織はCDPの方が現実的、というのが選定の基本線です。
なお、両者はハイブリッドで使うケースもあります。DWHで整えた顧客マスタをリバースETL経由でCDPに投入し、CDPは配信のオペレーションレイヤーとして使う、という構成です。既にCDPを導入済みの組織でも、リバースETLを「CDPへのデータ供給パイプ」として組み合わせられます。
主要ツールと選び方
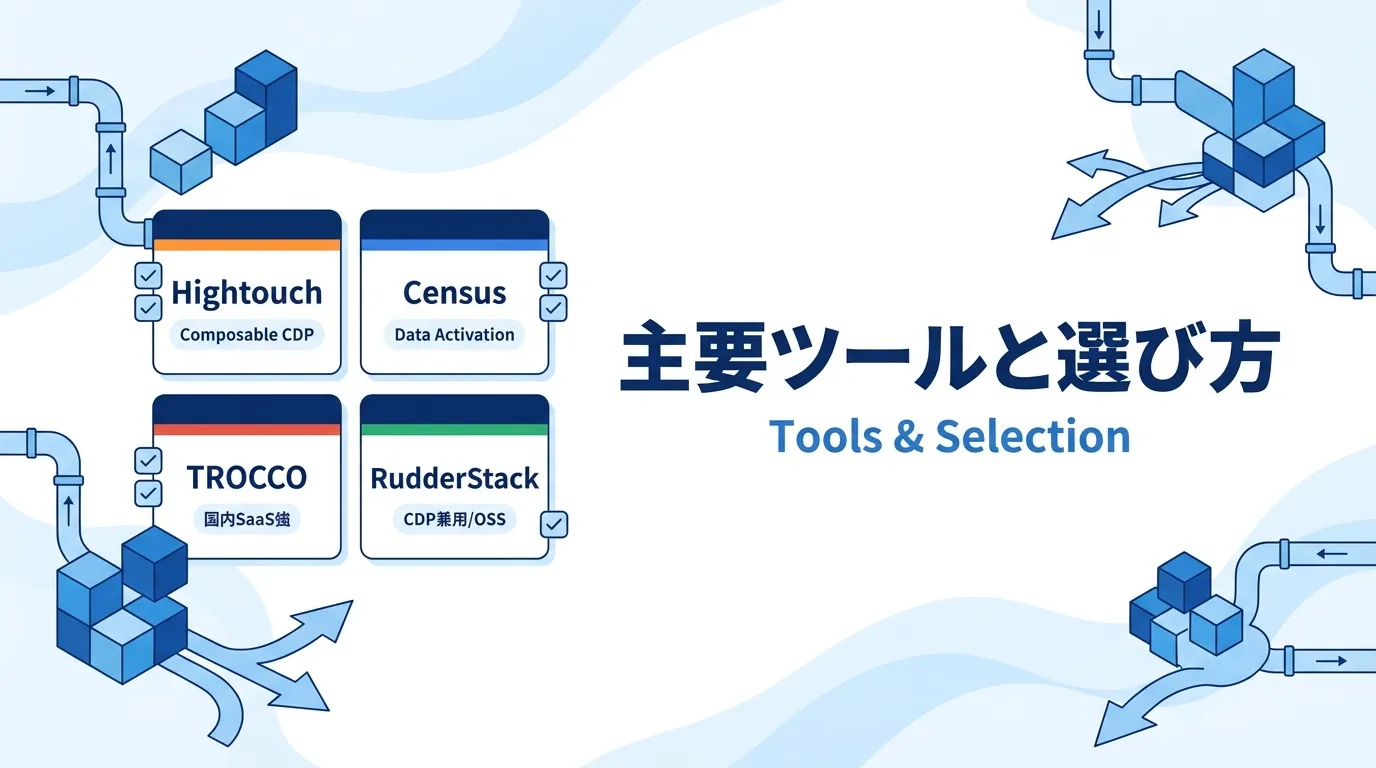
リバースETL専業として代表的なのは Hightouch と Census です。国内向けの選択肢や隣接ツールも含めて整理します。
Hightouch(ハイタッチ) 2020年創業の米国発。専業ツールとして機能面がもっとも充実しており、200種類以上 の業務ツール(Salesforce、HubSpot、Google広告、Meta広告、Slack、Intercomなど)にコネクタが揃っています。
差分同期・スケジューリング・エラー時のリトライ・監査ログといった運用面の機能が手厚く、「Composable CDP」の中核として自己定義しています。dbtモデルをそのままセグメント定義として読み込めるのが、dbtを使う組織にとっては大きな利点です。
料金は接続先の数と同期対象のレコード数で決まる従量課金 で、無料プランからスタートできる点も導入の心理的ハードルを下げています。
Census(センサス) 2018年創業。Hightouchとほぼ同世代で、機能面も似通っています。RailsやSalesforceのカスタムオブジェクトへの同期に強みがあり、DevOps文化のあるエンジニアリング組織で採用例が多い印象です。
「Data Activation Platform」を掲げ、リバースETLに加えてオーディエンス管理・A/Bテストへの連携なども統合的に提供しています。
RudderStack(ラダースタック) もともとはCDPに近い設計で、イベントデータの収集(フォワード方向)とリバースETLの両方を1つの製品でカバーする点が特徴です。オープンソース版があり、自社インフラで動かしたい組織に選ばれることがあります。
TROCCO(トロッコ) 国内の primeNumber 社が提供するデータ統合SaaS。もともとは順方向のETL・ELTツールですが、リバースETL機能も持ち、SalesforceやMarketoなど国内で使われる業務ツールへの同期にも対応しています。
日本語サポートと国産SaaSへの接続の手厚さが強みで、既にTROCCOで転送を回している組織は「1ツールに寄せる」選択がしやすくなります。詳しい比較はデータ連携ツールの比較と選び方|自動化・コスト・コネクタ で扱っています。
dbt Semantic Layerとの組み合わせ 近年は、dbt Semantic Layer(dbtで指標定義をAPIとして公開する仕組み)と組み合わせる構成も出てきました。指標の定義自体をdbtに寄せておき、リバースETLは配信を担当する、という分業です。指標の一貫性が担保しやすくなる一方、Semantic Layer側の学習コストが上乗せされます。
選び方の基本 既にdbtが導入済み :Hightouch または Census。dbt統合の成熟度で選ぶ国内SaaSへの接続が多い :TROCCO。日本語対応と国内コネクタの多さで選ぶ順方向のCDPも一緒に欲しい :RudderStack または Segment+Census の組み合わせオンプレ・自社ホスティングが必須 :RudderStack のオープンソース版初期のPoC(Proof of Concept、概念実証)はHightouchが情報量も多く、無料プランで動作確認ができるため、まずここから触る組織が多いというのが2026年時点の実感です。
導入時に押さえたい4つのポイント
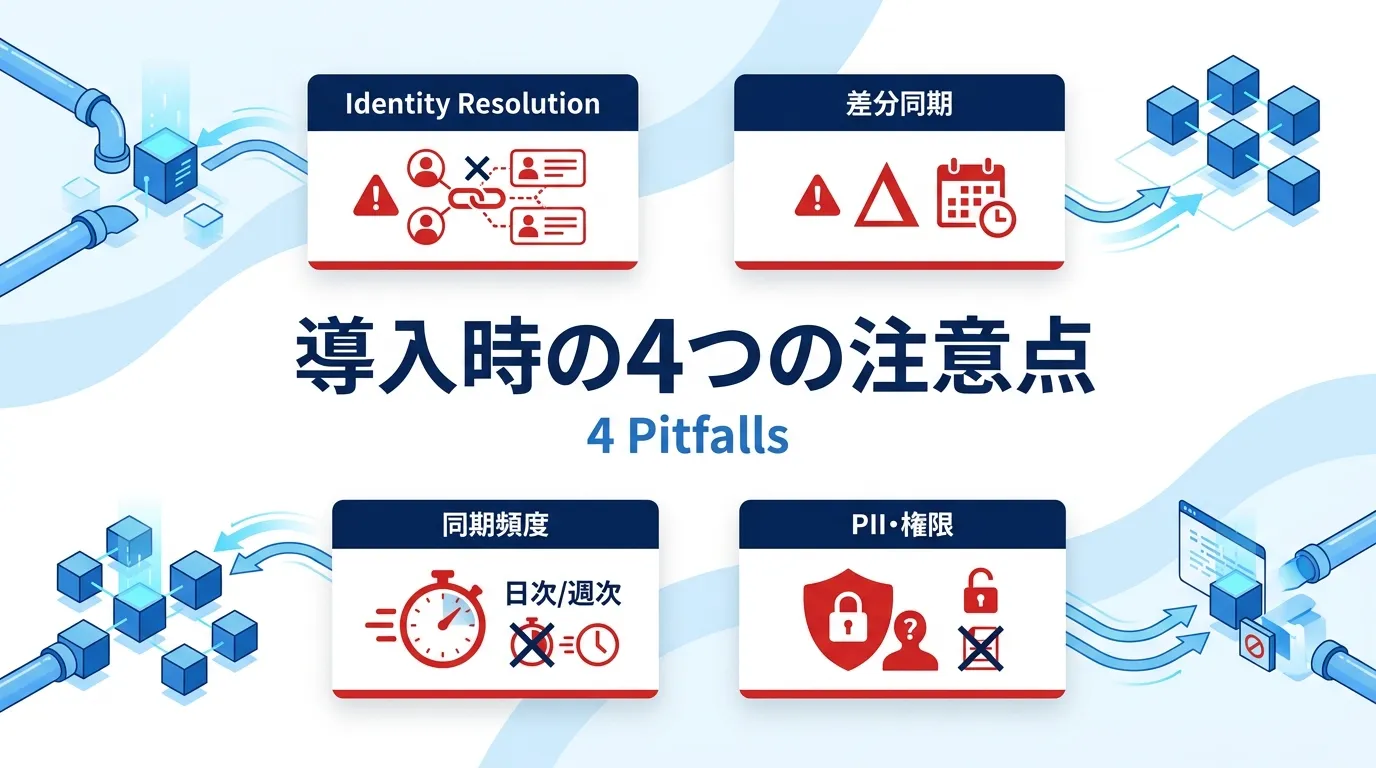
リバースETLの導入で失敗しやすいのは、ツール選定よりも運用設計の部分 です。とくに次の4点は最初に固めておくと後で苦しみません。
ポイント1:Identity Resolution(ID解決) DWHの顧客IDと業務ツール側のIDが一致しないと、そもそもデータを書き戻せません。SalesforceのAccount IDとDWHのcustomer_idの対応表、匿名アクセスから会員登録につながる際のIDマージ、複数チャネルにまたがる顧客の統合など、「誰と誰が同じ顧客か」を決める工程が最初の関門 です。
DWH側にID解決テーブル (customer_id、email、salesforce_account_id、hubspot_contact_idなどを紐づけたマスタ)を用意しておくのが定石です。ここが揃わないまま配信を始めると、業務ツール側で重複レコードや誤同期が発生し、あとから戻すのに大きな工数がかかります。
ポイント2:差分同期と全件同期の使い分け 全件同期はシンプルですが、APIの実行回数や料金が跳ね上がります 。多くの業務ツールでAPIのレート制限(1時間あたりのリクエスト数など)があり、大量のデータを毎日全件送るとエラーやコスト超過を招きます。
Hightouch や Census はデフォルトで差分同期に対応しており、DWH上でsnapshot(過去との差分計算のためのスナップショット)を取ってから差分だけをAPIに投げる仕組みが用意されています。この差分計算の精度を最初に検証しておくことが重要です。
ポイント3:同期頻度とビジネス要件の整合 「リアルタイムに近い方がいいはずだ」で高頻度同期を選ぶと、コストと運用負担が上がります 。実際は、以下の目安で十分なケースがほとんどです。
営業のセグメント配信:日次または週次 チャーンリスクスコア:日次 広告オーディエンス:日次または週次 CSへのシグナル通知:日次または準リアルタイム(1時間単位) 「営業がリストを見るタイミング」「マーケがキャンペーンを打つ頻度」といった業務側の実際のリズムに合わせた方が、コストパフォーマンスが高くなります。
ポイント4:PII(個人情報)とアクセス権限 リバースETLは顧客の氏名・メールアドレスといった**個人情報(PII、Personally Identifiable Information)**を扱う可能性が高いユースケースです。DWHのraw層にPIIが残っている場合、リバースETL経由で本来配信すべきでないカラムを外部ツールに流してしまうリスクがあります。
DWHのstaging層またはmart層で「配信して良いカラム」を明示的に絞ったビューを作り、リバースETLはそのビューだけを参照する運用にしておくと、事故を減らせます。個人情報の流通経路を1つに絞れるため、後の監査対応も楽になります。
リバースETLの始め方:1ユースケースを2週間で走らせる
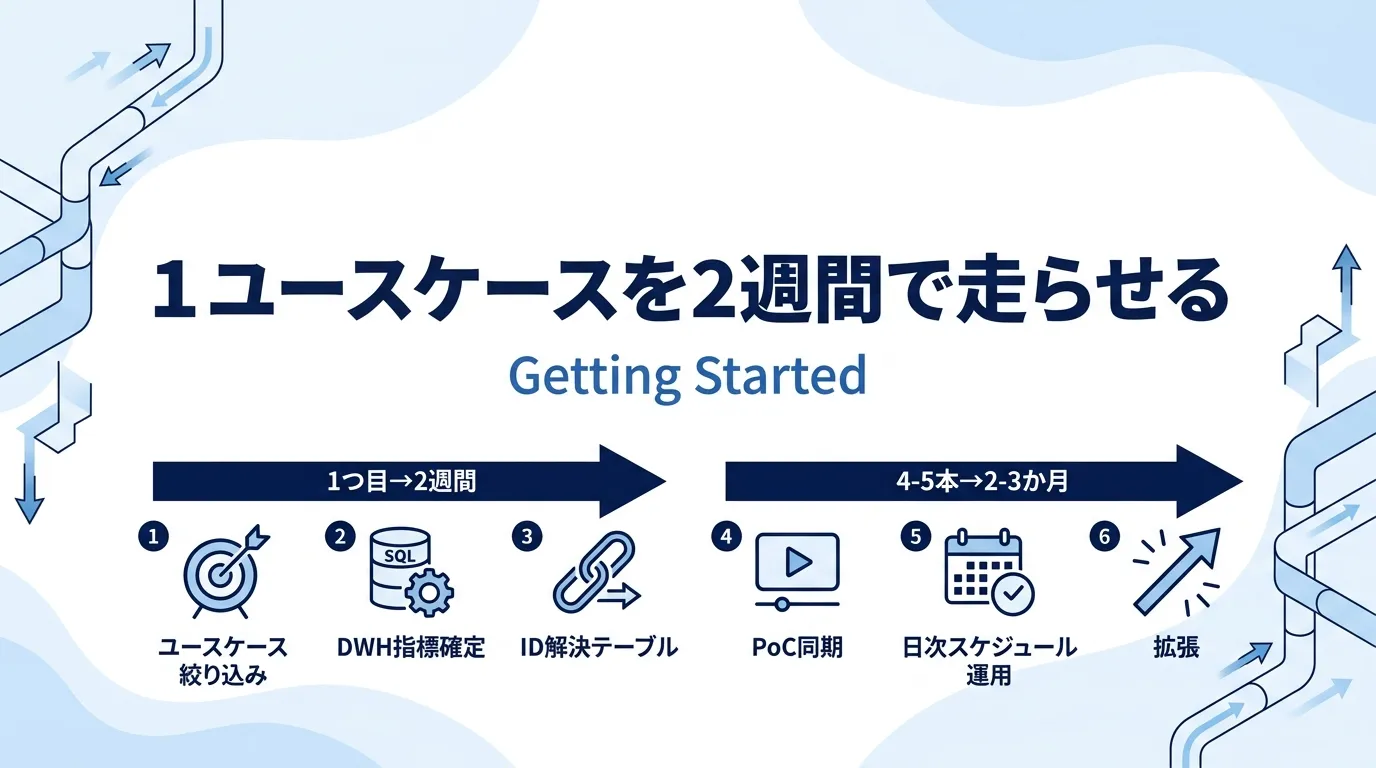
いきなり多数のセグメントを配信するプロジェクトを組むと、ID解決や運用設計で詰まりがちです。実務的には、次の順で小さく始めるのが定石です。
1つのユースケースに絞る :たとえば「LTV上位10%の顧客をSalesforceにタグ付け」1本DWH側の指標を確定する :dbtでLTV定義を1つに絞り、staging層のビューとして切り出すID解決テーブルを用意する :DWHのcustomer_idとSalesforceのaccount_idを紐づけた対応表を作るHightouch等でPoC :無料プランで手動同期を1回走らせ、Salesforce側で正しく反映されるか確認日次スケジュールで運用開始 :数週間動かして、営業側のフィードバックを収集次のユースケースに広げる :スコア配信、広告オーディエンス、CS通知の順に追加Evastで支援したケースでも、この順で進めると1つ目のユースケースが2週間程度 で本番稼働し、そこから2〜3か月 かけて4〜5本まで拡張、という進み方が多いです。
一気に広げるより、1本を確実に動かして「業務側が便利になった」という声を作ってからの方が、社内展開もスムーズです。
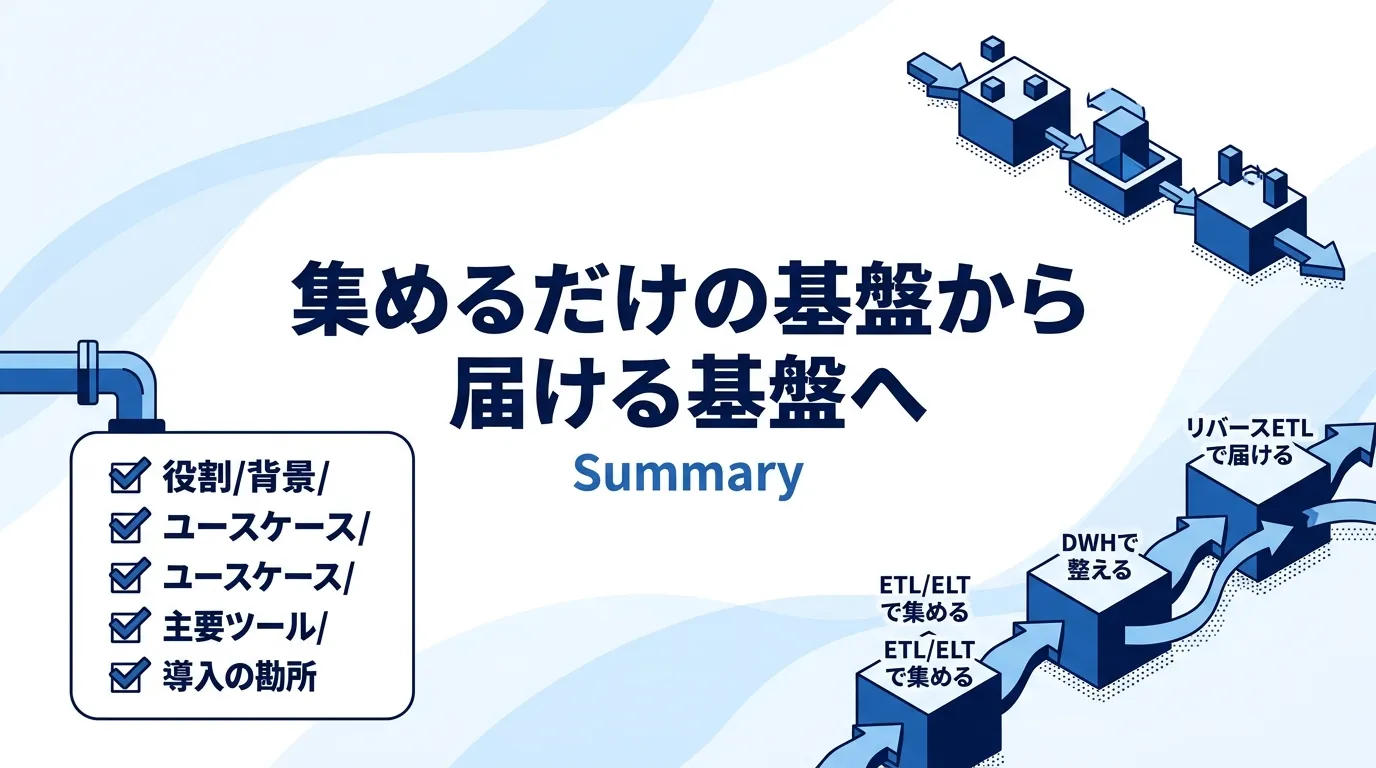
まとめ:集めるだけの基盤から、届ける基盤へ
リバースETLの要点を5つで整理します。
役割 :DWHのデータを業務ツールに戻し、現場の意思決定に届ける仕組み背景 :DWHが真実の源になり、現場ツール中心の意思決定が主流になった2020年前後から急拡大主なユースケース :顧客セグメント配信、スコア反映、広告オーディエンス、CS通知、配信パーソナライズ主要ツール :Hightouch・Census が専業の代表、TROCCOは国内向け、RudderStackはCDPと兼用導入の勘所 :ID解決テーブル、差分同期、業務リズムに合った同期頻度、PIIの扱いを最初に固める集めるだけのデータ基盤は、成果につながる前に「使われない基盤」として陳腐化します。ETL・ELTで集める、DWHで整える、リバースETLで届ける、という3ステップが揃って初めて、データ基盤がビジネスに効きます。
自社のデータ基盤がどこまで来ていて、どのユースケースから届けるフェーズに進めるか、次の1歩の設計から始めるのが現実的です。
リバースETL導入・データ基盤活用のご相談はEvastへ 株式会社Evastでは、DWH構築から dbt による変換パイプライン整備、Hightouch・Census・TROCCOによるリバースETL構成、業務ツールへの配信設計まで、一貫したデータ活用基盤の構築 を支援しています。
「BigQueryにデータは集まったが、営業やマーケの現場で使われていない」 「CDPを検討していたが、DWHとの二重管理を避けたい」 「Hightouch・Census・TROCCOのどれを選ぶべきか、選定から相談したい」 このようなお悩みがあれば、お気軽にご相談ください。ユースケースの整理から、ID解決テーブルの設計、ツール選定、初期同期の設計・運用までを伴走します。
→ データ基盤構築サービスを見る 無料相談を申し込む