製造業のデータ基盤が構造的に難しい理由
製造業のデータ活用が他業種と比べて難しいのは、扱うデータが「秒単位・多数の設備・多品種少量」であり、しかもデータの発生源と分析するレイヤーが物理的に離れていることに起因します。まずこの構造から見ていきます。
OT層(現場・設備)
- PLC制御信号・アラーム
- SCADA稼働ログ・警報
- MES作業実績・段取
- センサー振動・温度・電流
秒〜分単位
数千〜数万点/日
IT層(本社・基幹)
- ERP受注・出荷・原価
- 生産管理計画・BOM
- 品質検査結果・不良率
- 保全点検履歴・部品在庫
日次〜月次
トランザクション単位
工程横断で「なぜ稼働率が落ちたか」「不良の真因は何か」を追えず、
改善サイクルが現場カイゼン止まりになる
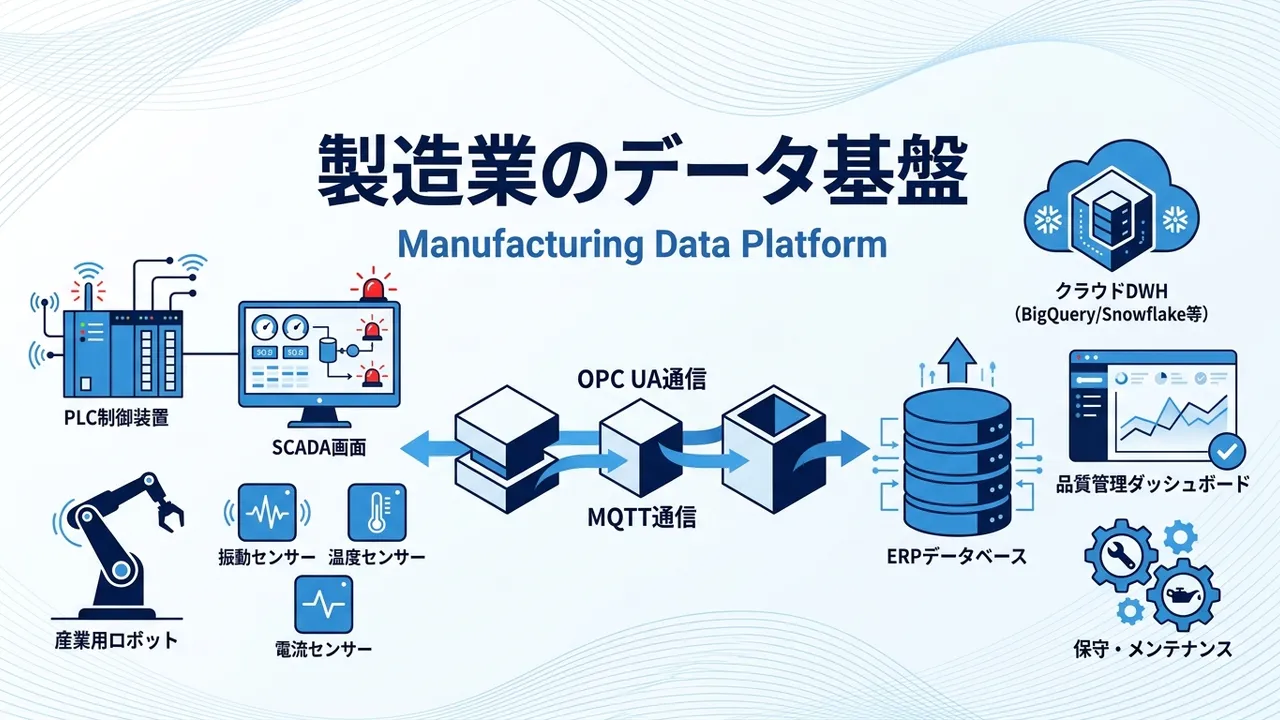
図のように、製造業のデータは大きく2つの階層に分かれています。
OT(Operational Technology)層は現場の設備側です。PLCやシーケンサ、SCADA、MES、追加設置のセンサーなど、秒〜分単位で数千〜数万点の信号を吐き続けます。データ形式はメーカー・機種ごとにバラバラで、Mitsubishi・Siemens・Omron・Rockwellのそれぞれの流儀があり、同じ「稼働中」でも意味が微妙に違います。
IT(Information Technology)層は本社の基幹側です。ERP(受注・出荷・原価)、生産管理システム、品質検査、保全管理、勤怠、原価計算。粒度は日次〜月次のトランザクションで、こちらは比較的整っています。
この2つの階層は、プロトコルも、粒度も、所管部門も違います。OT層は生産技術部と工場が握り、IT層は情シスと経理が握ります。「工程Aの稼働率が落ちた日と、その日の受注ミックス・段取り替え回数・不良率を1画面で見たい」という当たり前の要望が、この所管の分断のせいで実現できない、というのが多くの製造業で共通する状況です。
さらに厄介なのが、次の3点です。
設備の世代が混在するのが製造業のリアルです。20年前のPLCと最新のIoT対応装置が同じラインで動いています。古いPLCはEthernet/IP対応前でRS-232Cのシリアル通信、新しい装置はOPC UAとMQTTで即クラウド送信、という混在環境で、共通のデータレイヤーを設計するのがそもそも骨が折れます。ゲートウェイの選定と、通信プロトコル変換の設計に、想像以上の時間を取られます。
多品種少量ゆえに、SKU単位の統計モデルが作りにくいのも製造業の特徴です。小売のPOSデータのように「同じ商品が毎日売れる」構造とは違い、多品種少量の工場では品番の切り替え(段取り替え)が1日に何度も発生し、同じ品番が翌週まで流れないこともあります。稼働率・不良率を語るときに「品番」「工程」「オペレーター」「日時」を必ずセットで持たないと、比較が意味を持ちません。
改善サイクルの主体が現場側にあるのが最後のポイントです。現場のカイゼン活動は日本製造業の強みですが、その改善判断が現場の勘と経験に閉じたままだと、複数工場・複数ラインに横展開しにくくなります。データが整うと「他工場では同じ症状がどう出て、何で解決したか」が横断で見え、カイゼンの効き所そのものが変わっていきます。
こうした構造があるため、ライン数と工場数が増えるほど、データ活用は「現場カイゼンは続くが、全社の稼働率・品質・原価の因果関係は追えない」という壁にぶつかります。データ基盤の全体像そのものを押さえたい方は、データ基盤とは?企業が導入すべき3つの理由と構成要素を解説を先に読んでいただくと、この記事の話がより具体的に感じ取れます。
現場カイゼン止まりを示す3つのサイン
「うちは現場が強いから、カイゼンで回っている」と言う工場長は多いのですが、実は現場カイゼンの限界サインが出ていることは珍しくありません。次の3つで判断できます。
サイン1: 稼働率の集計に毎日30分以上かかっている
工場長・生産管理・現場監督が、日次の稼働率・可動率・段取り時間の集計に毎日30分〜1時間を使っているなら、これはデータ基盤化の判断ラインです。3ラインの中規模工場でも、月20時間・年間240時間の集計工数が消えています。5工場に広げれば年間1,000時間を超えます。
この工数は、扱いSKUとライン数が増えるほど比例して増えます。単に「集計を楽にする」ためではなく、経営会議で使う数字がリアルタイムに見え、稼働率低下の原因分析まで踏み込めるようにするためにデータ化するのだ、と目的を切り分けると投資判断がぶれません。
サイン2: 設備停止の真因を1週間経っても言い切れない
前週火曜日にB工程で15分の停止が2回発生した、という事実は日報で残っています。しかし「あの停止の真因は何だったか」を、翌週の会議で誰も言い切れない。こういう状態は、稼働ログと保全履歴と品質検査と操業条件が別々のシステムに閉じていて、真因分析が現場の記憶頼みになっている典型的な症状です。
原因が言い切れないと、再発防止策も打ちようがありません。結果として同じ原因の停止が翌月・翌々月に繰り返され、稼働率が5ポイント落ちたまま定着してしまう、というのが製造業で頻繁に見る症状です。
サイン3: 品質不良の相関分析が「勘」で語られている
品質検査で不良が出たとき、その原因を「気温が高かったから」「Aさんのシフトだったから」「たぶん材料ロットが変わった前後で」といった仮説で語っている状態は、データ基盤化のもう1つの判断サインです。仮説そのものは現場の勘として貴重ですが、これを「操業条件・材料ロット・オペレーター・気温・振動データ」の実測と突き合わせて統計的に検証できないと、対策が的外れになりがちです。
原因は、品質検査データが検査システムに閉じ、操業条件がPLCに閉じ、材料ロットがWMSに閉じ、気温が外部APIに閉じている、というデータの分断です。3〜6か月分の全データを1基盤に集めて初めて、相関分析ができるようになります。
3つのうち2つ以上に当てはまれば、データ基盤化を検討するフェーズに入っています。逆に、1ライン・少量多品種で担当者が固定されているうちは、Excel+PLC純正ツールで当面戦えます。業種横断でのExcel限界サインは、Excel集計が限界になったら|スプレッドシートからデータ基盤への移行にもまとめています。
製造業データ基盤の3つのアプローチと費用相場
製造業データ基盤の実現手段は、大きく次の3つに分かれます。それぞれ費用感・将来性・自社の関与度がまったく違います。
① IoTベンダーSaaSi-Reporter・MOTTAINAI等
- 設備稼働の見える化に特化
- ERP/品質データとは分離
- ライン単位で完結
初期 50〜300万円
+月10〜30万円/導入4〜8週間
→
② PoC型データ基盤1ラインでBigQuery/Snowflake
- 1ライン限定でクラウド集約
- ダッシュボードまで整備
- 横展開は追加投資
初期 300〜800万円
+月5〜20万円/2〜4か月
→
③ 本部データ基盤+予知保全全工場×OT/ITを統合
- OT/IT/品質を1基盤に統合
- 予知保全・品質根本原因を分析
- 複数工場・海外拠点まで拡張
初期 1,000〜3,000万円
+クラウド利用料/3〜6か月で最初の運用
アプローチ1: IoTベンダーSaaSで設備稼働の見える化から
IoTベンダーが提供するSaaS(i-Reporter、MOTTAINAI-見える化、コアスタッフ、コンテック各社の稼働管理系プロダクトなど)を導入し、既存PLCから稼働・停止・アラームを吸い上げ、ダッシュボードで見える化する方法です。工場側の受け入れが早く、短期で見える化が始まります。
- 初期費用:50万〜300万円(ライン数・センサー追加数で変動)
- 月額:月10万〜30万円(ライン数課金+SaaS月額)
- 導入期間:4〜8週間
- 向いているケース:まずは特定ラインの設備稼働見える化を優先したい、複数工場の統合はまだ視野にない
弱点は、SaaSのスキーマに閉じるため、ERPや品質システムとの突き合わせは基本的にできないこと、そしてSaaSを乗り換えるとデータの引き継ぎが難しいことです。「稼働率を見る」までは実現できても、「なぜ稼働率が落ちたか」「その日の受注ミックスや品質不良との関係」までは踏み込みにくい構造です。
アプローチ2: 1ライン限定のPoC型データ基盤
対象を1ラインに絞り、PLC・SCADA・MESからのデータをOPC UA・MQTT経由でクラウドに送り、BigQueryやSnowflakeに集約、Looker StudioやPower BIで可視化する方法です。SaaSではなく自社のデータ基盤を持つため、後から品質・ERPデータと結合できる拡張性があります。
- 初期費用:300万〜800万円(PoC範囲の設計・実装・ゲートウェイ含む)
- 月額:月5万〜20万円(クラウド利用料+データ連携ツール)
- 導入期間:2〜4か月
- 向いているケース:将来的に複数工場・全ライン展開を見据えている、社内にデータ人材の候補がいる、まず1ラインで投資回収を実証したい
弱点は、1ラインで止まると「PoCで終わる」リスクがあること、横展開の際に他ラインで機種・世代が違うとゲートウェイ選定と接続テストで想定以上に工数が膨らむことです。「PoCの範囲」と「横展開の設計」を最初から線引きしておかないと、単発の実験で終わりがちです。データ基盤PoCの進め方と落とし穴はデータ基盤のPoCで失敗しないための進め方と評価基準にまとめています。
アプローチ3: 本部データ基盤+予知保全モデル
複数工場・全ラインのOTデータと、ERP・生産管理・品質・保全のITデータを、本社のクラウドDWH(BigQuery・Snowflake・Databricks)に自動集約し、dbtで統合モデルに変換し、BigQuery MLやSageMakerで予知保全・品質根本原因分析を組み込む方法です。もっとも柔軟で、将来の在庫最適化・原価分析・海外拠点統合まで拡張できます。
- 初期費用:1,000万〜3,000万円(工場数・ライン数・OT-IT接続範囲で変動)
- 月額:クラウド利用料 十数万〜数十万円+運用保守 年額で初期費の10〜20%
- 導入期間:3〜6か月で最初の運用、フル機能で6〜12か月
- 向いているケース:3工場以上を運営している、予知保全と品質根本原因分析まで本格運用したい、海外拠点や複数事業部の統合を視野に入れている
初期費用は3アプローチで最も高く見えますが、複数工場を持つ製造業では、稼働率5〜10ポイントの改善と突発停止50〜70%の削減で1〜2年で投資回収するのが実務での目安です。BigQueryとSnowflakeの選び方はSnowflake vs BigQuery徹底比較|料金・機能・向く業種の違いを解説、データ基盤の見積もりの内訳はデータ基盤構築の費用相場は?見積もりの内訳と判断基準を解説でくわしく整理しています。
3つのアプローチの選び方は、将来AIによる予知保全や複数工場の統合運営まで踏み込む予定があるかどうかで決めるのが後悔の少ない判断です。特定ラインの見える化だけならアプローチ1で十分。将来のデータ活用まで見据えるなら、最初からアプローチ2でPoCを回し、アプローチ3への段階的な拡張を設計しておくほうが総額を抑えられます。
費用対効果:稼働率5〜10ポイント改善と突発停止50〜70%削減
「初期1,000万円超」と聞くと大きく感じますが、稼働率の未活用と突発停止で失っている売上・利益を数字にすると、判断はまるで変わります。
3ラインの中規模工場(年商50億円)を想定します。現状の設備稼働率が70%だとすると、これを75%に引き上げると、追加投資なしで年数億円の売上増につながります。稼働率1ポイントで工場の稼ぐ力が変わる、という感覚は現場ほど強く持っています。データ基盤で「なぜ稼働率が落ちるか」を工程横断で追えるようにすることで、稼働率5〜10ポイントの改善はよく見られる水準です。
突発停止の削減も見逃せません。1回15分の停止が月10回発生していて、1回あたり30万円の機会損失(人件費+工程間仕掛の停滞+顧客への納期遅延リスク)だとすると、月300万円・年間3,600万円のロスです。予知保全で突発停止を50〜70%削減できれば、年間1,800万〜2,500万円の削減効果になります。
これらを合計すると、3ライン規模の中規模製造業で稼働率改善と突発停止削減で年間5,000万〜1億円レンジの見えないコストが発生している計算になります。1,000万〜3,000万円の初期投資は、この見えないコストに対して1〜2年で回収できるレンジです。
加えて、製造業のデータ基盤には稼働率・停止時間以外の効果もあります。
- 品質不良率の低下:品質不良の相関分析で真因が特定できるため、不良率が0.5〜1ポイント低下することが多い。年商50億円で不良率が1ポイント下がれば、年間5,000万円の原価削減インパクト
- 段取り時間の短縮:品番別・オペレーター別の段取り実績が可視化されるため、ベストプラクティスの横展開で段取り時間が10〜20%短縮
- 保全部品の在庫最適化:予知保全で「いつ何が壊れるか」の予測ができれば、保全部品の安全在庫を圧縮できる。工場によっては年数千万円の運転資本改善
これらは営業利益率で2〜4ポイントの改善につながり、初期投資の回収期間をさらに短縮します。カイゼン活動そのものが「勘と経験」から「データを起点にした仮説検証」に変わっていく、というのが本当の意味での効果でもあります。
内製と外注のどちらで進めるかは、データ基盤は内製と外注どっち?判断基準とハイブリッドの進め方で判断軸を整理しています。製造業の場合、OTプロトコルとクラウドDWHの両方に精通したエンジニアの採用が難しいため、外部パートナーと組んで立ち上げ、3〜5年で運用まで内製化するロードマップを描く企業がほとんどです。
3〜6か月で本番に乗せるスモールスタート手順
製造業のデータ基盤は、最初から全工場・全ライン・全設備を対象にすると、要件が発散して頓挫します。最初の運用開始までを3〜6か月に区切ったスモールスタートで進めるのが、実務では失敗しにくい進め方です。
週1〜2: 現状把握とスコープ確定
- 工場長・生産管理・現場監督・情シス・生産技術にヒアリングし、いま何にどれくらい時間を使っているかを棚卸し
- 対象ラインのPLC・SCADA・MES・センサーの機種・世代・通信プロトコルを台帳化
- 最初の対象範囲を決める(例:ボトルネック工程1ラインの稼働率と段取り可視化だけ、予知保全は次フェーズ)
ここで欲張らないことが最大のコツです。最初は「ボトルネック工程1ラインの稼働率と段取り時間の見える化」1つに絞り、全ライン展開や品質・ERP統合は次フェーズに回します。
週3〜6: OTデータ収集とクラウド集約
- 対象ラインにOPC UA対応ゲートウェイ(Kepware、Cogent DataHub、National Instruments、または軽量なEdgeX/HiveMQ Edge)を設置
- PLC・SCADAからのデータをMQTTでクラウド(AWS IoT Core、Google Cloud IoT、Azure IoT Hub)に送信
- BigQueryやSnowflakeにストリーミング取り込み、dbtで工程横断のデータモデルに変換
この段階でデータ品質チェック(欠損・重複・タイムスタンプずれ)をパイプラインに組み込むと、後戻りが少なくなります。データパイプラインの考え方そのものはデータパイプラインとは?ETLとの違いと仕組みを図解で解説にまとめています。
週7〜12: ダッシュボードと現場フィードバックのループ
- Looker StudioやPower BIで、工場長・生産管理・現場監督の3種類のダッシュボードを実装
- 稼働率・段取り時間・停止要因のTOP10を、日次・週次で更新
- 現場と週次でレビューを行い、ダッシュボードの粒度・切り口を実運用に合わせて調整
このタイミングで、実際の日次朝会と生産会議で新旧併走で使います。現場が数字を見て動き始めるかどうかが最大の勝負どころで、「現場が使わないダッシュボード」を作らないための唯一の予防策が、この段階での週次フィードバックです。
週13〜24: ITデータ統合と予知保全の初期版
- ERP・生産管理・品質検査・保全管理のデータを日次で取り込み、OTデータと結合
- 品番×工程×オペレーター×時間帯でのクロス分析を実装
- センサーの3〜6か月データを使い、まずルールベース(しきい値超過アラート)で予知保全の初期運用を開始
- BigQuery MLやSageMakerでの機械学習モデルは、データが揃った時点で追加
ここまでで最初の運用が回り始めます。その後、複数ライン・複数工場への横展開、予知保全モデルの精度改善、原価分析・海外拠点統合と、段階的にスコープを広げていくのが無理のない進め方です。全体スケジュールの目安はデータ基盤構築の期間はどのくらい?規模別・工程別スケジュールの目安でも工程別に解説しています。
まとめ:製造業のデータ基盤を進めるポイント
製造業のデータ基盤について、要点を整理します。
- 製造業のデータが構造的に統合しにくいのは、OT(PLC・SCADA・MES)とIT(ERP・品質・保全)が別階層に分かれ、プロトコルも粒度も所管も違うから。PLC単体からデータを取ることが問題ではなく、両階層をライン横断で1本のスキーマに揃える設計が本質
- 現場カイゼン限界のサインは、稼働率集計に毎日30分以上・設備停止の真因が1週間言い切れない・品質不良の相関が勘で語られるの3つ。2つ以上当てはまれば検討フェーズ
- 実現アプローチはIoTベンダーSaaS/PoC型データ基盤/本部データ基盤+予知保全の3つ。将来の複数工場統合と予知保全まで見据えるなら、最初からアプローチ2でPoCを回してアプローチ3へ拡張する設計が総額を抑えやすい
- 3ライン規模の中規模工場では、稼働率5〜10ポイント改善と突発停止50〜70%削減で年間5,000万〜1億円レンジの見えないコストが改善余地。1,000万〜3,000万円の投資は1〜2年で回収できるレンジ
- 進め方は3〜6か月のスモールスタートが基本。最初は「ボトルネック工程1ラインの稼働率と段取り可視化」1つに絞り、品質・ERP統合や予知保全は段階的に広げる
製造業のデータ基盤で本当に効いてくるのは、稼働率が上がることそのものよりも、工場長・現場監督・生産管理・情シスが同じ数字を同時に見て、稼働率が落ちた原因や不良の真因を、翌週ではなくその日のうちに議論できる状態を作れることではないでしょうか。日単位で改善のPDCAが回れば、営業利益率の改善はすぐに現れます。
まずは自社の現場が稼働率集計にどれくらいの時間を使っていて、突発停止の真因分析にどれくらいの時間差が発生しているかを棚卸ししてみるところから、検討を始めてみてください。
製造業のデータ基盤構築のご相談はEvastへ
株式会社Evastでは、製造業のOT/IT統合と、BigQuery・Snowflakeを使った本部データ基盤の構築をご支援しています。PLC・SCADA・MESからのOPC UA/MQTT連携、ERP・品質・保全データとの結合、Looker StudioやPower BIでのダッシュボード、予知保全モデルの導入まで、工場側の現場業務と両立する形で設計します。
- 「複数ラインの稼働率・停止要因を1画面で見たいが、集計が毎日30分以上かかっている」
- 「PLCからデータは拾えているが、品質・原価と突き合わせるまで手が回っていない」
- 「将来、予知保全と複数工場統合まで見据えたロードマップを描きたい」
現状の稼働率集計・停止分析の棚卸しや、既製IoT SaaSで足りるのか本部データ基盤が必要なのかの判断からでも構いません。スモールスタートのロードマップまで一緒に描きます。
→ データ基盤構築サービスを見る → 無料で相談する