DWHとは:分析専用に設計されたデータの集約場所
DWH(Data Warehouse、データウェアハウス)とは、複数のシステムから収集したデータを統合・蓄積し、分析に特化した構造で保管するデータベースのことです。
「倉庫(Warehouse)」という名前が示す通り、DWHは「使うために整理して保管する場所」です。営業のSalesforce、マーケティングのGoogle Analytics、経理の会計ソフト。これらバラバラのシステムに散在するデータを一箇所に集め、横断的に分析できる状態にします。
なぜ通常のデータベースでは分析できないのか
ここが多くの担当者が引っかかるポイントです。MySQLやPostgreSQLといった一般的なデータベース(RDB)でも、データは保管できます。なぜ分析には向かないのでしょうか。
理由は設計思想の違いにあります。
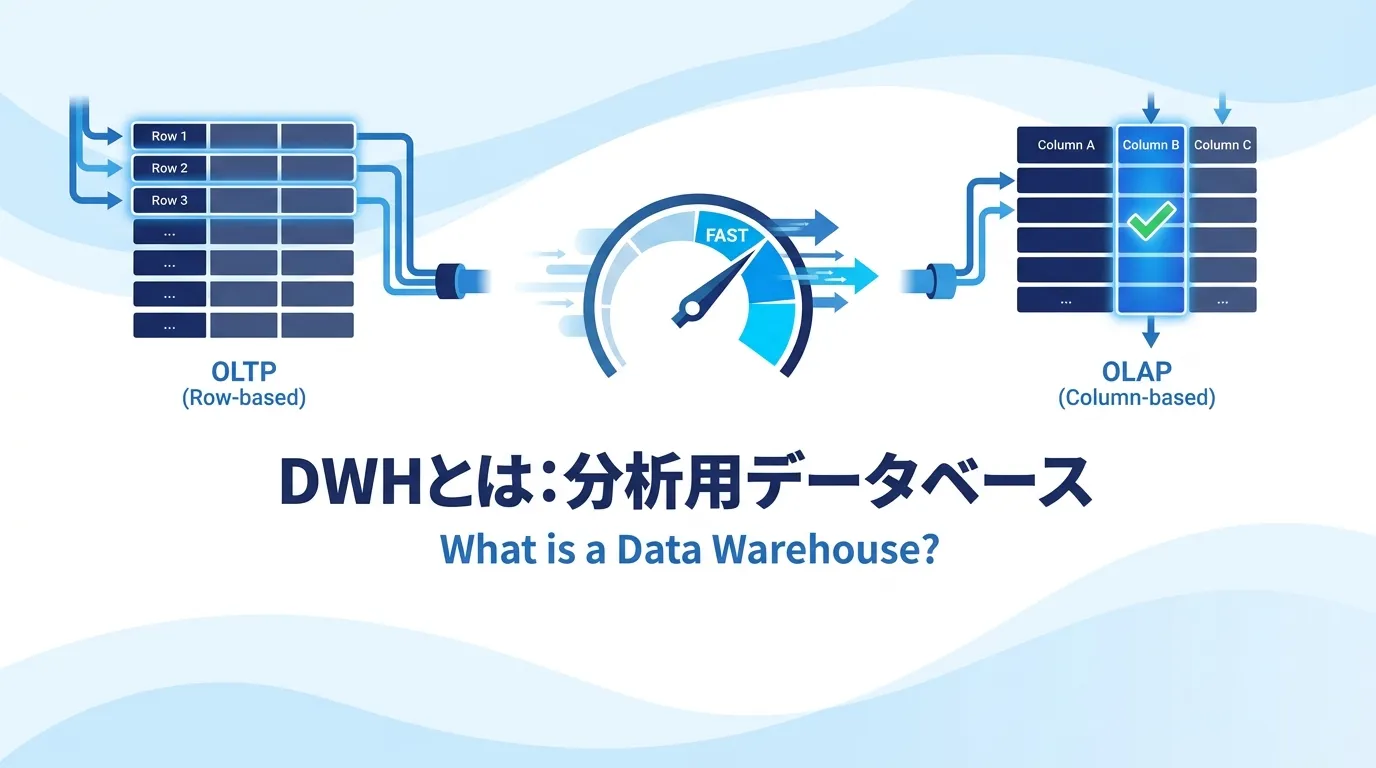
一般的なRDBは OLTP(Online Transaction Processing) 向けに設計されています。OLTPは「1件の注文を素早く登録する」「特定の顧客情報を検索する」といった、少量のデータへの高速な読み書きに最適化されています。ECサイトの注文処理や在庫管理のように、1件ずつのトランザクションを正確に、速く処理するための仕組みです。
一方、分析では「過去3年分の売上データから、商品カテゴリ別・地域別の傾向を集計する」といった処理が必要です。これは OLAP(Online Analytical Processing) と呼ばれるアクセスパターンで、数百万〜数十億件のレコードを横断的にスキャンします。OLTPのRDBにこうした分析クエリを投げると、本来の業務処理に影響が出るうえ、処理に何時間もかかることがあります。
DWHはOLAP向けに設計されており、大規模な分析クエリを高速に処理できます。その中心的な仕組みが列指向ストレージです。
列指向ストレージとは
通常のRDBは行単位でデータを保存します。「顧客ID、名前、メール、購入日、金額」という1レコードを、ディスク上でも1まとまりとして保存する方式です。
DWHが採用する列指向ストレージは、列単位でデータを保存します。「金額」列のデータだけを取り出す場合、行指向では全行のすべての列を読む必要があります。列指向では「金額」列だけを読めば済みます。
売上合計を集計するクエリなら、読み込むデータ量が10分の1以下になることも珍しくありません。これがDWHでの分析が速い根本的な理由です。BigQueryやSnowflakeはすべて列指向ストレージを採用しています。
データベース・データレイク・データマートとの違い
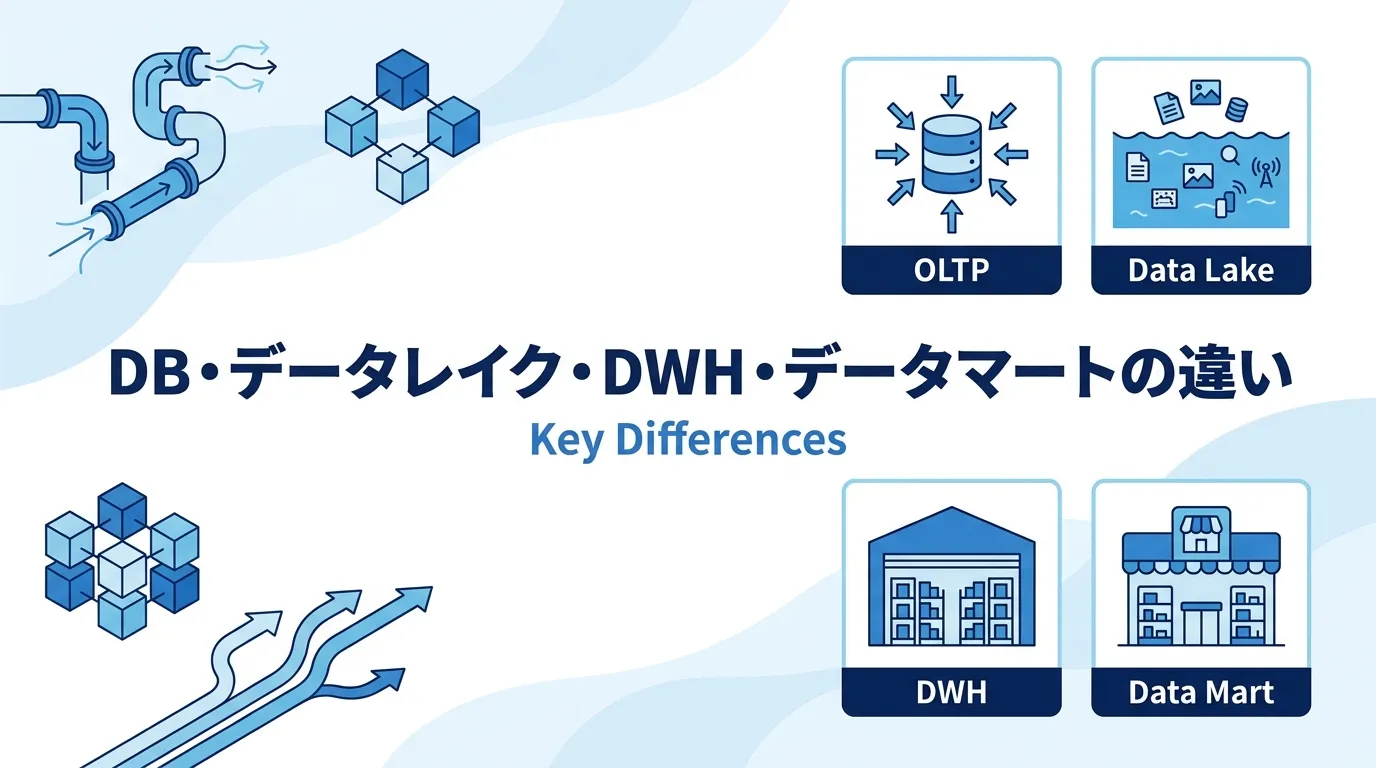
「DWH、データレイク、データマート」は同じデータ基盤の文脈で登場するため混同しやすいです。役割の違いを整理します。
| 種類 | 主な役割 | 保管するデータ | 向いている用途 |
|---|
| データベース(RDB) | 業務処理 | 最新の確定データ | 注文・在庫・顧客管理 |
| データレイク | 生データの保管 | 加工前の生データ・非構造化データ | ログ保管、将来の分析に備えた蓄積 |
| DWH | 分析 | 統合・加工済みのデータ | BI・集計・レポート |
| データマート | 部門別分析 | DWHから絞り込んだデータ | 営業レポート、マーケティング分析 |
データレイクは「とりあえず全部入れておく」場所です。Webサーバーのアクセスログ、IoTセンサーのデータ、画像や動画など、加工前の生データを安価に大量保管します。Amazon S3やGoogle Cloud Storageが代表例で、1GBあたり月数円のストレージコストです。分析前提の整備はされていないため、そのままでは集計やBI(ビジネスインテリジェンス。データを集計・可視化して経営判断に役立てる手法やツール)には使えません。
DWHは「分析のために整備された」場所です。データレイクの生データを加工・統合し、集計クエリが高速に動く形で保管します。BIツールはDWHに接続して可視化します。
データマートは「特定の用途向けに切り出した」DWHのサブセットです。全社売上データのDWHから、営業部門が見る指標だけを切り出した「営業マート」を作るイメージです。DWH内のテーブルとして実装するケースが大半で、物理的に別システムを立てることは減っています。
データソース
パイプライン
DWH
データマート
BIツール
SalesforceCRM
GA4広告管理
基幹システムERP
IoT・センサー
BIツールTableau / Looker / Power BI
クラウドDWHが主流になった理由
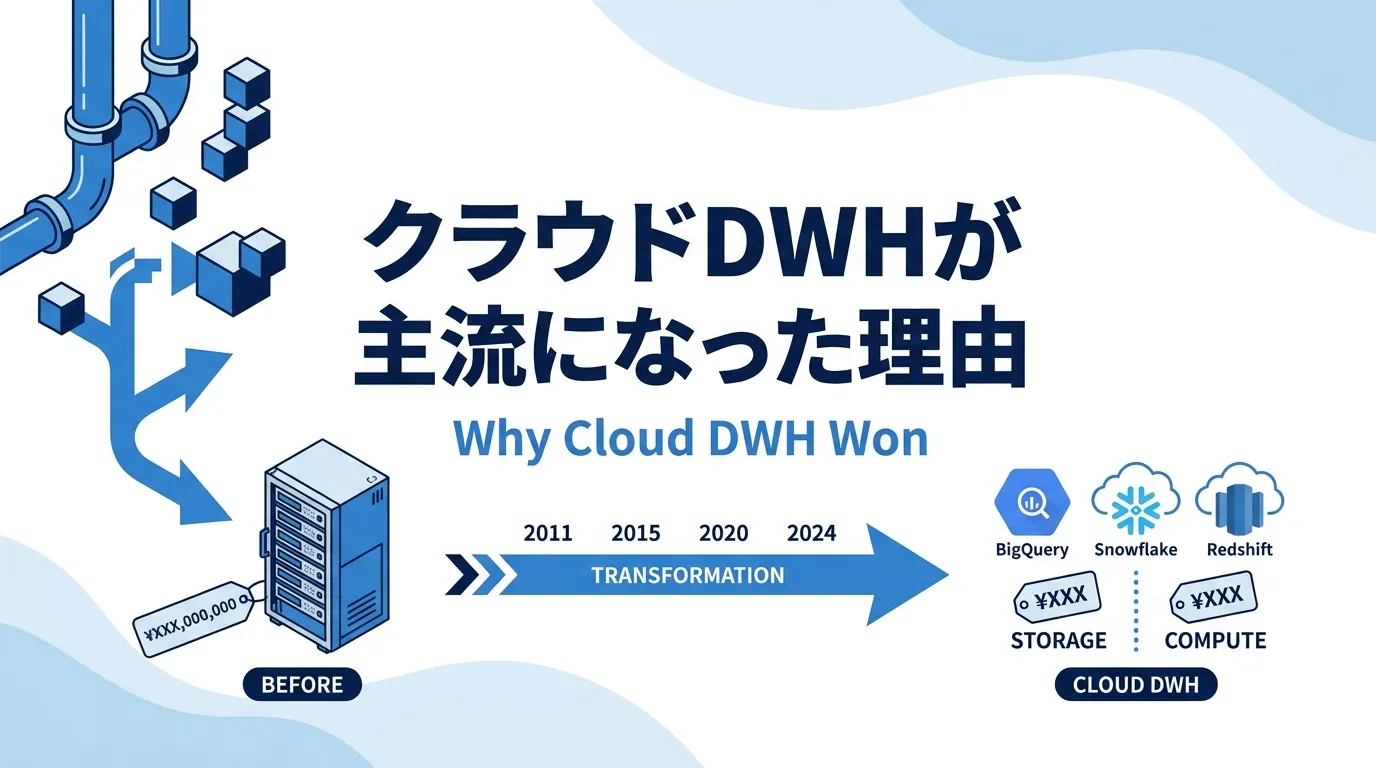
2010年代以前のDWHは、Oracle ExadataやTeradata、IBM Netezzaといったオンプレミス製品が中心でした。導入に数千万〜数億円かかり、容量を増やすにはハードウェアを追加購入するしかなく、中堅企業が手を出せるものではありませんでした。
状況を変えたのがクラウドデータウェアハウス(クラウドDWH)です。
ストレージとコンピュートの分離が最大の革新でした。従来のDWHはデータの保管と処理を同じハードウェアが担っていたため、データ量が増えれば処理能力も同時に増強する必要がありました。クラウドDWHは保管と処理を独立させたため、「大量のデータを安く保管しながら、処理は必要なときだけ強力にする」が実現できます。
BigQuery(2011年一般提供開始)はこの分離を徹底した設計で、Googleの分散処理インフラの上で動きます。Snowflake(2015年)は「仮想ウェアハウス」と呼ぶ計算リソースを複数起動でき、部門ごとに分離して課金できる設計が特徴です。
クラウドデータウェアハウスの比較:BigQuery・Snowflake・Redshiftの選び方
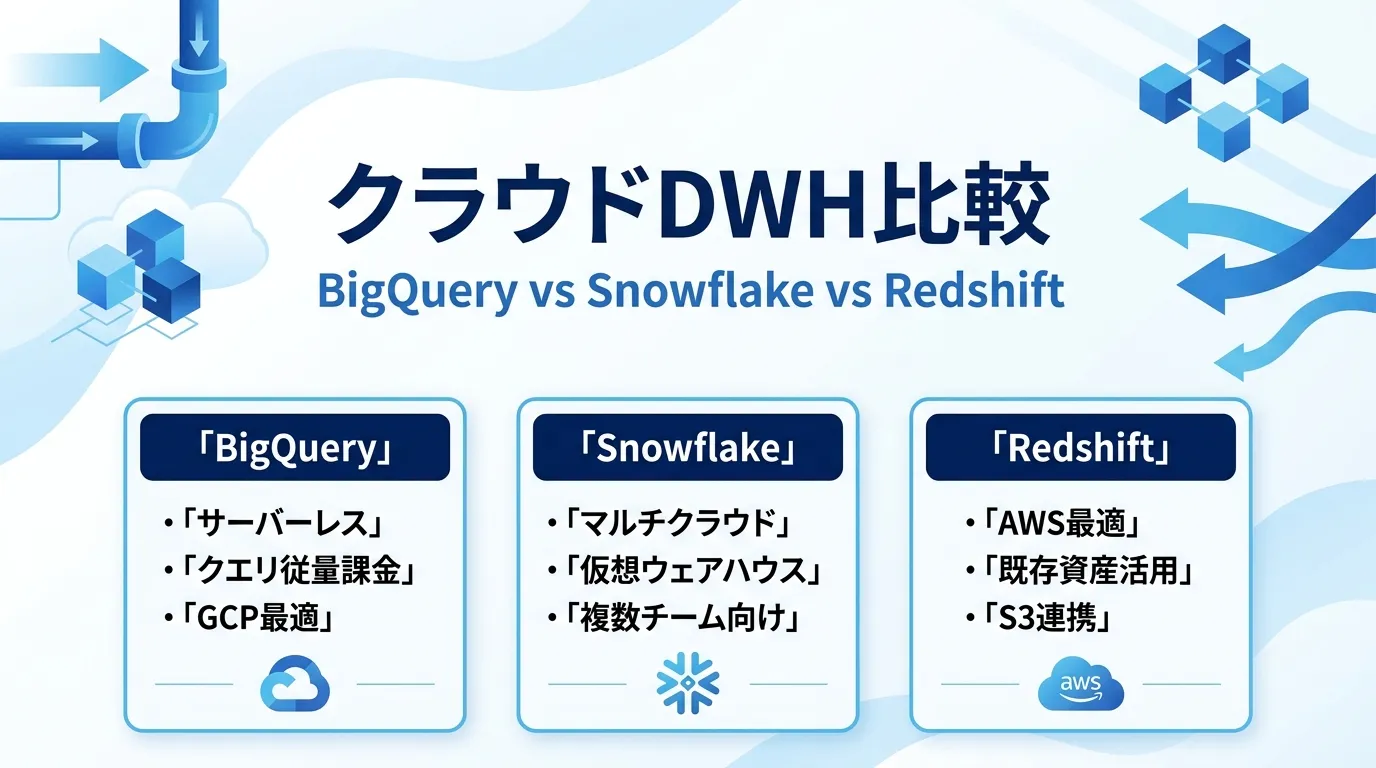
3つが主要な選択肢です。簡単に特徴をまとめると:
- BigQuery:完全サーバーレス、GCP環境との親和性が最高、クエリスキャン量課金
- Snowflake:マルチクラウド(AWS/Azure/GCP対応)、複数チームの並列利用に向く、仮想ウェアハウス時間課金
- Redshift:AWS環境と最も統合しやすい、S3直接クエリ(Redshift Spectrum)が強み
選定の判断基準は「どのクラウドをメインで使っているか」「複数チームが並列でクエリを実行するか」「スモールスタートか大規模運用か」の3点で8割が決まります。コストや性能、マルチクラウド、データ共有の7軸での詳細な比較はSnowflakeとBigQueryの違いを徹底比較:コスト・性能・機能で選ぶで、BigQueryのコスト設計についてはBigQueryの料金体系とコスト削減|課金トラップと対策でそれぞれ詳しく解説しています。AWSでRedshiftを検討する場合は、Amazon Redshiftとは?料金体系と費用相場を解説で料金体系と費用相場を整理しています。3社の料金を自社の規模に当てはめて月額を試算したい場合は、DWHの料金はいくら?費用の見積もり・試算方法を実例で解説でシミュレーション付きでまとめています。分析だけでなく機械学習や生成AIの開発まで1つの基盤で扱いたい場合は、レイクハウス型のDatabricksとは?レイクハウスの仕組みと料金を解説もあわせて検討できます。
業界別のクラウドDWH選び方(製造・自治体・EC)
3社比較の軸だけで選定が決まる場面は多いですが、業界によってはデータ量・機密性・連携要件が判断を左右します。代表的な3つの業界について、選定時に見落としがちなポイントを整理します。
製造業:センサーの時系列データと保管費の構造
製造業では PLC・SCADA・MES から出るセンサーの時系列データが分析の中心になり、1ラインあたり毎秒数百点の測定値が出るケースも珍しくありません。月あたり数百GB〜数TB規模になるため、保管費が構造的に効いてくるのが他業界との違いです。
- BigQuery は90日以上更新のないテーブルを「Long-term storage」として料金を自動で半額($0.020→$0.010/GB/月)に切り下げる仕組みがあり、大量保管に強い設計です。Snowflakeも保管費は安価ですが、圧縮率と自動階層化の観点で BigQuery が第一候補になりやすい。
- オンプレPLCとの連携で Edge Gateway や IoT Core を併用する場合、GCPエコシステム内で完結する BigQuery が構成をシンプルにできます。
- SAP や Oracle EBS などオンプレERPが基幹側で動いている場合は、マルチクラウド対応の Snowflake で AWS/Azure に寄せる選択もあります。
製造業のデータ基盤の全体像は製造業のデータ基盤|生産・品質・在庫データを統合する方法で扱っています。
自治体・公共:ガバメントクラウドとセキュリティ要件
自治体・公共領域はガバメントクラウドの指定が検討の前提になります。2026年時点では AWS・Google Cloud・Microsoft Azure・Oracle Cloud Infrastructure・さくらのクラウドが認定を受けており、住民情報を扱う基幹系はこの認定範囲内で構築する必要があります。
- 接続方式の設計が最初の関門:LGWAN接続系との分離、Private Service Connect / AWS PrivateLink / Azure Private Link のどれを使うかで運用負荷が大きく変わります。DWH選定より先に接続方式とアクセス制御を確定させることが多い。
- 住民データのマスキング:仮名加工・匿名化をDWH内で完結させたい場合、BigQuery の Dynamic Data Masking や Snowflake のマスキングポリシーでカラム単位の権限制御ができます。
- 調達要件との適合:一般競争入札の仕様書で「認定クラウドで構築」を明記されるケースが多く、認定期間内かどうかを事前確認する運用が必要です。
EC・小売:多チャネル連携とリアルタイム性の分離
ECは Shopify・楽天・Amazon・自社カート・POS などデータソースが5〜10種類になりがちで、それぞれのAPIレート制限と更新頻度が異なるため、パイプライン設計が複雑になります。
- データシェアリングとの相性:Snowflake は決済代行・物流会社などとテーブルを直接共有できる仕組みがあり、EC事業者の連携要件と相性がよい。
- リアルタイム集計はDWHの外で分離:在庫連携などのリアルタイム更新はDWHをバッチ層に据え、Redis や Firestore と組み合わせるのが定石。DWH単独でリアルタイム性を追わない設計判断が費用対効果を左右します。
- 中小規模のスモールスタート:数千SKU規模で小さく始めたい場合は、中小企業のデータ基盤スモールスタート|100万円で始める4ステップの構成が参考になります。
クラウドDWHの費用構造とコストダウン|3社の課金モデル別に整理
クラウドDWHの費用は「ストレージ」と「クエリ実行」の2つに大別され、そこに「データ転送・ロード」が上乗せされる構造です。従来のRDBのように「サーバー1台いくら」で捉えていると、月次の請求書を見て金額が動く理由が読めなくなります。まずは3社の課金軸の違いを並べて把握するのが近道です。
3社の課金モデル比較(2026年時点)
| 製品 | 主な課金軸 | 想定利用シーン | 中規模構成の月額目安 |
|---|
| BigQuery | クエリスキャン量(オンデマンド)or スロット予約 | クエリ量が波打つ、部門横断で使う | 10〜30万円 |
| Snowflake | 仮想ウェアハウス稼働時間(クレジット)+保管量 | 並列チーム利用、常時稼働の分析ワーク | 20〜50万円 |
| Redshift | クラスタ稼働時間 or Serverless RPU+Managed保管 | AWS一貫、定常的な分析ワークが中心 | 15〜40万円 |
中規模構成は「保管100〜500GB/月間クエリ数千本」を想定した目安で、実案件では利用パターンで大きく上下します。3社の料金体系を自社の規模に当てはめて月額を試算する手順はDWHの料金はいくら?費用の見積もり・試算方法を実例で解説、Snowflakeのクレジット消費の実態はSnowflake導入支援は100万〜1,500万円|費用相場と支援内容、Redshiftの料金体系はAmazon Redshiftとは?料金体系と費用相場を解説にそれぞれ整理しています。
コストダウンの順序:クエリ → ストレージ → 予約プラン
Evastが毎月DWH費用の点検をしてきた経験でいうと、削減インパクトの8割はクエリ側に集中します。順序を間違えると効果が出ないので、次の順で手を入れます。
- クエリを絞る:
SELECT * の禁止、パーティション/クラスタリングフィルタを必ず効かせる、頻繁に叩かれるダッシュボードは集計済みテーブルに退避 - ストレージ階層化:BigQueryはLong-term storageへの自動移行(90日以上更新のないテーブルが自動で半額)、Snowflakeは
AUTO_SUSPEND による無操作時のウェアハウス停止、Redshiftはゾーンマップとソートキーを効かせて読み取り量を圧縮 - 予約プランを検討:定常負荷が3〜6ヶ月安定した段階で、BigQuery Editions・Snowflake Capacity Contract・Redshift Reserved Node を月単位で見積もる
「まず予約プランで割引を狙おう」から入って失敗するのが定番です。定常負荷を測る前に長期契約に入ると、余剰キャパに毎月払い続ける構造になり、あとから解約するのに違約金が発生します。使い方が読める段階まで、まずはオンデマンドで走らせるのが安全側です。
DWH単体だけでなくETL・オーケストレーション・ストレージまで含めた費用削減の全体像はデータ基盤のランニングコスト削減|4要素別の見直し方、BigQuery特有の課金トラップと対策はBigQueryの料金体系とコスト削減|課金トラップと対策で詳しく扱っています。
クラウドDWH導入の進め方|検討〜本番運用の4フェーズ
クラウドDWHは契約したその日から本番稼働できるわけではありません。データソースの棚卸しからBI定着まで、通常は3〜6ヶ月かかります。段階を4つに区切って進めるとブレが少なくなります。
フェーズ1:要件整理とデータソース棚卸し(2〜4週間)
「何を分析したいか」と「どこにデータがあるか」を突き合わせるフェーズです。
- 分析の主要ユースケース(月次売上、顧客セグメント、広告ROIなど)を3〜5個に絞り込む
- データソースをリストアップし、それぞれの更新頻度・データ量・保有オーナーを整理
- 3年後のデータ量を粗く試算(現状の月次データ量 × 36ヶ月 × 成長率)
ここでユースケースを絞りきれないと、以降の設計が肥大化します。優先順位のトップ3以外は「後回しリスト」に明示的に落とすのがコツです。
フェーズ2:DWH選定とアカウント発行(1〜2週間)
BigQuery・Snowflake・Redshift のどれにするかを決めて、アカウントを発行します。
- 選定基準は「メインクラウド」「並列利用の必要性」「スモールスタートか大規模か」の3点(詳細は本記事の比較セクションを参照)
- 開発・ステージング・本番の3環境分離をこの段階で決めておく
- コスト予算と月次上限アラートを設定。BigQuery なら「クエリ最大バイト数」、Snowflake なら「Resource Monitor」で暴走防止を仕込む
フェーズ3:パイプライン実装とテーブル設計(6〜10週間)
データを実際に運び込み、分析用テーブルを整備するフェーズで、もっとも工数が集中します。
- ETL/ELTツールの選定(trocco・Fivetran・Airbyte・内製Pythonなど)
- raw / staging / mart の3層構造でテーブル設計
- パーティション・クラスタリング設計をこのタイミングで確定(後から入れるとテーブル再作成コストが数倍)
- dbt で SQL 変換を管理するとバージョン管理と再現性が担保しやすい
ETLの選び方はETLとは?データ統合の基礎と選定ポイントを解説、dbtの位置づけはdbtとは?SQLでデータ変換を行うツールの基本と導入メリットで扱っています。
フェーズ4:BI接続と運用定着(3〜4週間)
Tableau や Looker Studio などのBIツールを mart 層に接続し、実際のユーザーが日常的に見る状態を作ります。
- ダッシュボードは3〜5個に絞って先行公開(全社展開は運用が回ってから)
- 月次のコスト・スキャン量・失敗ジョブをレビューする運用ミーティングを設定
- 「誰が新規テーブルを作れるか」「martオーナーは誰か」のルールを明文化
運用開始後のコスト削減の具体策はデータ基盤のランニングコスト削減|4要素別の見直し方、体制の作り方はデータ基盤の運用・保守|内製と外注の分岐点で解説しています。
DWH設計の基本:スタースキーマとパーティション
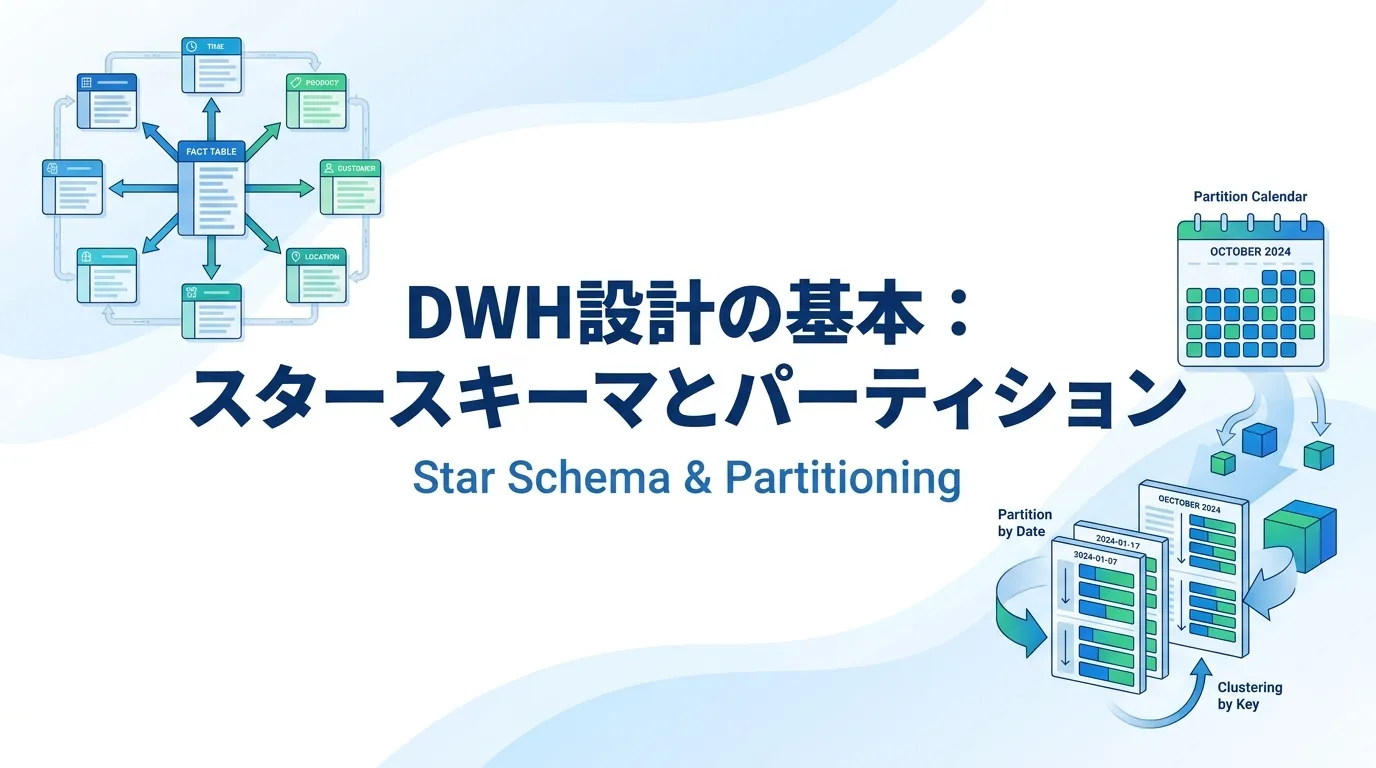
DWHを構築する際に押さえておくべき設計の基本を2つ紹介します。
スタースキーマ:分析しやすいテーブル設計
DWHのテーブル設計で最もよく使われるのがスタースキーマです。
中心に「ファクトテーブル」(売上、注文、アクセスログなど、数値データを持つテーブル)を置き、その周囲に「ディメンションテーブル」(顧客マスタ、商品マスタ、日付テーブルなど)を配置します。図にすると星形になることが名前の由来です。
たとえば「売上ファクトテーブル」には顧客ID・商品ID・日付ID・売上金額だけを持たせ、顧客の名前・地域・年代は「顧客ディメンション」に持たせます。BIツールで「地域別・年代別の月次売上」を集計するとき、JOINで組み合わせる仕組みです。
スタースキーマのメリットはクエリがシンプルになることです。通常のRDBで正規化されたテーブルは結合が複雑になりがちですが、スタースキーマは結合するテーブルが少なく、BIツールからも扱いやすい設計です。
パーティションとクラスタリング:コストとパフォーマンスの両立
BigQueryやSnowflakeで費用を抑えながら高速な分析を実現するために不可欠なのがパーティションとクラスタリングです。
パーティションは、データを日付などの単位で物理的に分割して保管する設計です。「2026年6月1日のデータ」だけをスキャンすれば済むクエリで、テーブル全体をスキャンしなくなります。BigQueryでは日付パーティションを設定するだけで、スキャン量(=費用)を10分の1以下に削減できるケースがあります。
クラスタリングは、パーティション内をさらに特定の列でソートして保管する仕組みです。「地域=東京」のデータだけをスキャンするクエリで、東京以外のブロックを読み飛ばせます。
この2つを設定しないまま本番稼働させると、データ量が増えるにつれて費用が青天井になります。Evastでは設計フェーズで必ずパーティション設計を確定してから実装を始めることをルールにしています。クラウドデータウェアハウスのランニングコストを継続的に下げる具体策は、データ基盤のランニングコスト削減|4要素別の見直し方で詳しく解説しています。
DWH導入でよくある失敗
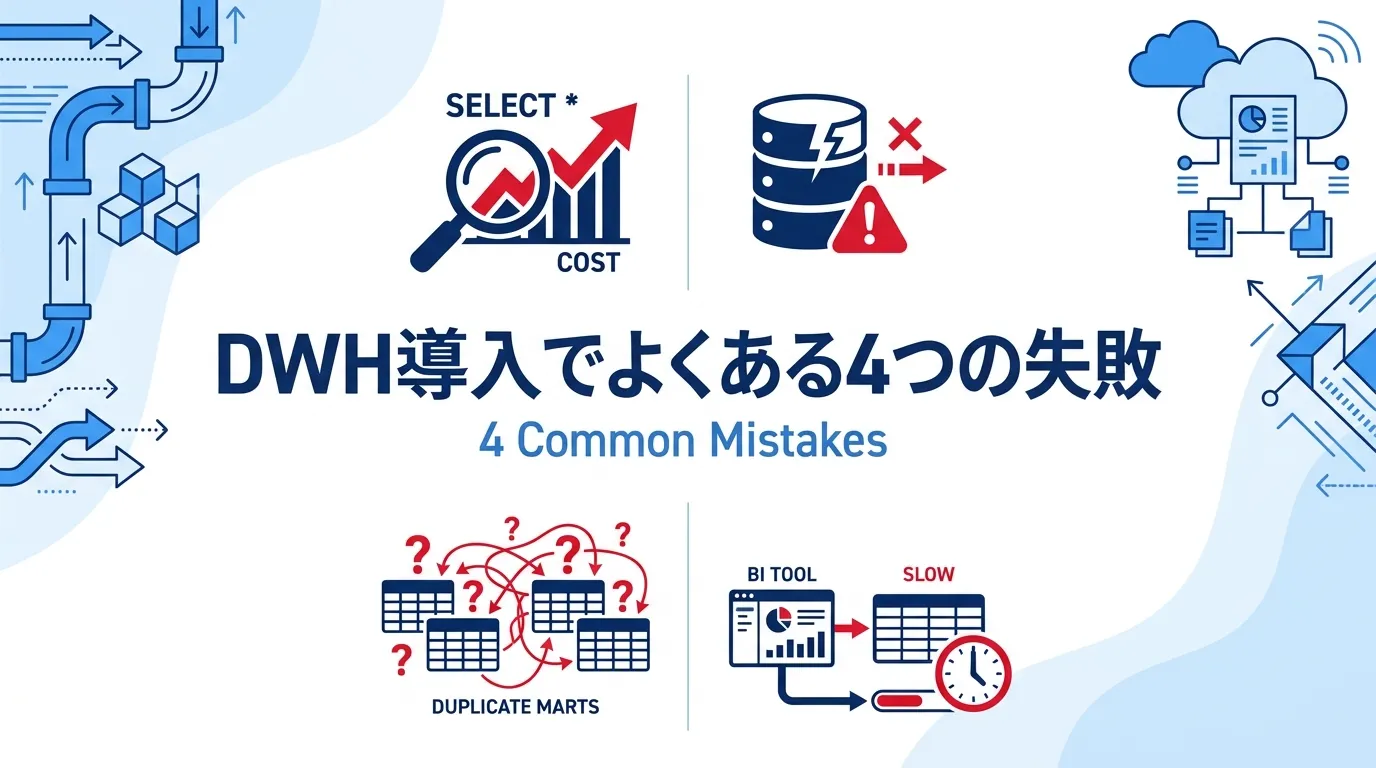
失敗1:SELECT * が横行して費用が月数十万円に膨らむ
BigQueryのオンデマンド課金は、スキャンしたデータ量が課金の基準です。SELECT *(全列取得)を習慣的に使うと、1クエリで数GBをスキャンする状態になります。Evastが支援した事例では、開発者3名がそれぞれSELECT *で探索クエリを投げていたところ、1か月で20万円以上のBigQuery費用が発生していたケースがあります。必要な列だけを指定する習慣と、ドライラン(スキャン量の事前確認)の義務化で対処しました。
失敗2:パーティション・クラスタリングなしで設計してしまう
後からパーティションを追加する場合、テーブルの再作成が必要になります。データ量が多いと数時間のダウンタイムが発生し、ETL(各システムからデータを抽出・変換し、DWHへ書き出す処理)の一時停止が必要になることも。設計フェーズで決めておかないと、本番稼働後に修正コストが数倍になります。
失敗3:データマートが乱立して「どれが正しいのか」わからなくなる
「部門ごとに好き勝手に集計テーブルを作る」状態が続くと、6か月後には同じKPIが3パターン存在し、「どれが正しいのか」を誰も把握できなくなります。raw・staging・martの3層設計と、martテーブルのオーナー制(誰が責任を持つか)を最初に決めておくことが予防策です。dbt(SQLでDWH内のデータ変換を管理するツール)を使ったレイヤー管理についてはETLとELTの違いとは?でも触れています。
失敗4:BIツールが直接生テーブルに接続する
BIツール(TableauやLooker)が最適化されていない生テーブルに直接接続すると、ダッシュボードを開くたびに大量のスキャンが走ります。BIツールはmart層のみに接続する設計にすることで、費用とパフォーマンスの両方を安定させられます。
まとめ
DWHの役割を3行でまとめると:
- 分析専用の設計:列指向ストレージにより、通常のRDBでは時間がかかる大規模集計を高速に処理できる
- データの統合場所:バラバラのシステムからデータを集め、横断分析できる状態にする
- データ基盤の核心:ETLでデータを運び込み、dbtで変換し、BIツールで可視化する。この一連の流れの中心にDWHがある
クラウドDWHはBigQuery・Snowflake・Redshiftのいずれも、かつてのオンプレミスDWHと比べて圧倒的に安く始められます。ただし「とりあえず入れて、あとで考える」は費用爆発と設計の混乱を招きます。前章の失敗事例で挙げた設計の前提を本番稼働前に決めておくことが、長期運用コストを左右します。
DWHにデータを運ぶETLの仕組みはETLとは?データ統合の基礎と選定ポイントを解説で、DWH内でのデータ変換にはdbtが使われます。dbtの役割についてはdbtとは?SQLでデータ変換を行うツールの基本と導入メリットで解説しています。
データ基盤構築のご相談はEvastへ
株式会社Evastでは、DWH選定・設計から、ETL/ELT実装・BIダッシュボード開発まで、データ基盤の一気通貫支援を行っています。
- 「BigQuery/Snowflake/Redshiftのどれを選ぶべきか迷っている」
- 「DWHは契約したが、設計をどう進めればいいかわからない」
- 「既存のDWHが遅い・費用がかかりすぎていて見直したい」
DWH選定の段階からでも構いません。現状のデータ環境の診断から、ロードマップ策定・実装まで伴走します。
→ データ基盤構築サービスを見る → 無料相談を申し込む