MCPとは?AIとデータをつなぐ「共通コネクタ」
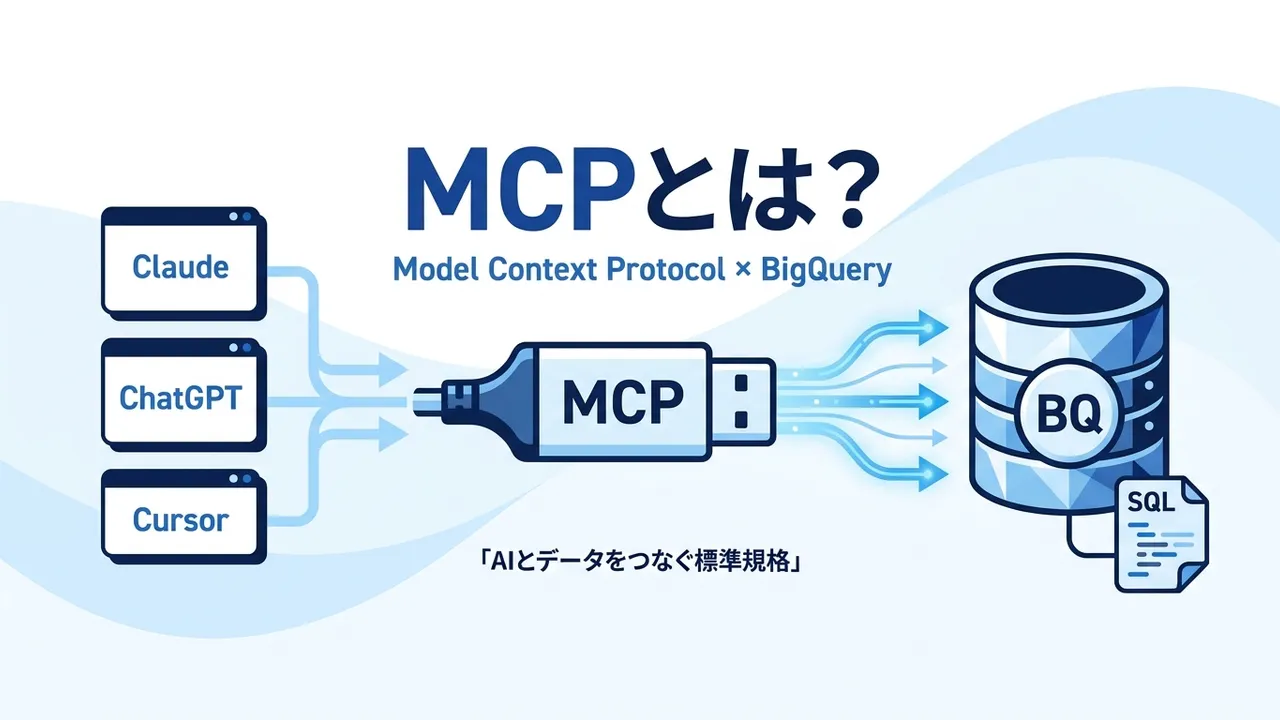
MCP(Model Context Protocol)は、大規模言語モデル(LLM)に外部のデータや機能を渡すための共通仕様です。Anthropicが2024年11月にオープン標準として公開し、2026年時点ではGoogle Cloud、Microsoft、多数のOSSツールがサポートしています。
ざっくり言えば、AIホスト側(Claudeなど)とデータ側(BigQueryなど)の間に共通の口を作り、「どうやってツールを呼ぶか」「どうやって認証するか」「何を返すか」を仕様として決めたものです。
利用者情シス/営業/経営
→
MCPホストClaude / ChatGPT / Cursor / Gemini CLI
→
MCPサーバーtools定義/OAuth/権限制御
→
BigQueryDWH本体
↓ 実行される主なMCPツール
青がMCPプロトコル、緑が権限のあるデータ範囲。誰が・どのMCPホストから・どのツールを使えるかは、IAMとMCPサーバー側で二重に絞る
図のように、MCPは3つの役割で構成されます。
- MCPホスト:ユーザーが会話するAIアプリ。Claude Desktop、ChatGPT、Cursor IDE、Gemini CLIなど
- MCPサーバー:接続先ごとに存在し、実行できるツール(
execute_sqlなど)とその使い方を定義。認証・権限もここで受ける - 接続先データソース:BigQuery、dbt、Salesforce、Slack、社内APIなど
利用者は自然文で質問を投げ、MCPホストは会話の中で「このツールを使うべきだ」と判断し、MCPサーバーに呼び出し要求を出します。サーバー側は権限を検証してBigQueryにSQLを投げ、結果をLLMに戻す。この一連の流れがMCPの本質です。
RAGとの違い
MCPとよく比較されるのがRAGとは?企業の社内データをAIに使わせる仕組みと作り方の技術ですが、両者は用途が異なり補完的に使います。
- RAG:事前にベクトル化した非構造化文書から意味の近い断片を取り出す。就業規則・議事録・マニュアルの検索に強い
- MCP:AIが会話中に必要に応じて動的にツールを呼び出す。BigQueryのSQL実行、Jiraのチケット作成、Slack投稿など「操作」に強い
現場では**「社内文書はRAG、数値・業務操作はMCP」の使い分けが定石**です。両方を1つのAIエージェントに組み合わせるハイブリッド構成も増えています。
なぜ2026年にMCPが必要になったのか
MCPの必要性は、生成AIの利用フェーズが**「対話」から「実行」へシフト**したことで一気に高まりました。
2024年前半までは、ChatGPTに要約・翻訳・下書きを頼むのが主な使い方でした。2025年後半からは、業務データを見せて集計させたい・在庫を更新させたいという「実務に踏み込む」需要が強くなりました。Google Cloudが「エージェント時代」と呼ぶ段階に入ったのがちょうどこの時期です。
問題は、AIホストとデータソースの組み合わせが掛け算で増えることです。ChatGPTからBigQueryを叩けるアダプタを作っても、翌月にClaudeやCursorに乗り換えたら作り直し。dbtもSalesforceも同じで、社内で使うAIホスト3種類 × 業務システム10種類だと30本のアダプタが要ります。
自前で作る場合
Claude用アダプタA
ChatGPT用アダプタB
社内Bot用アダプタC
↓ すべて個別実装
BigQuery / dbt / Salesforce
- AIホストごとに接続を作り直す
- 権限制御は各アダプタで独自実装
- モデル入れ替えのたびに保守コスト
MCPを使う場合
↓ 全部 MCPプロトコル
MCPサーバーtools定義/認証/権限をここに集約
↓ OAuth / IAM
BigQuery / dbt / Salesforce
- 接続実装はMCPサーバー1本に集約
- 権限はIAMとMCPサーバーで一元管理
- ホスト・モデル入れ替えは設定変更だけ
図のように、自前で作るとAIホストの数だけ実装が増え、権限制御も個別に書くことになります。MCPを採用すると接続の口はプロトコル1本に集約され、ホスト側は「MCP対応」と宣言するだけでよくなります。
これは同じ課題を、業界全体で1回だけ解こうという合意です。実際、2026年前半にはOpenAI・Anthropic・Google・Microsoftの4社がMCPを公式サポートしており、追随しない選択肢はほぼありません。
Google公式のBigQuery MCPサーバーで何ができるか
2026年1月にGoogle CloudがPreview公開したフルマネージド リモートBigQuery MCPサーバーは、Google側のインフラで動くため、社内でホスティングする必要がありません。BigQuery APIを有効化すると自動的に使えるようになります。
endpointは https://bigquery.googleapis.com/mcp の1本で、Claude Desktop・ChatGPT・Gemini CLI・Cursor IDE・Google Agent Development Kit(ADK)・LangGraphなど、主要なMCPホストから同じ口を叩けます。
主な提供ツール
BigQuery MCPサーバーがLLMに公開している主要ツールは次の5つです。
list_dataset_ids:プロジェクト内のデータセット一覧を返すget_dataset_info:データセットのメタデータを返すget_table_info:テーブルのスキーマ・行数・パーティション情報を返すexecute_sql_readonly:読み取り専用のクエリを実行execute_sql:書き込みも可能なクエリを実行
現場で最初に開放するのは list_dataset_ids get_table_info execute_sql_readonly の3つです。書き込みが必要になるのは、AIエージェントに集計結果テーブルを作らせるようなユースケースで、権限設計を詰めてから開けるのが実務的な順序です。
認証と権限
認証方式はOAuth 2.0で、APIキーは受け付けません。IAMロールで細かく絞れるため、社内標準の認可基盤に自然に馴染みます。最低限必要なロールは以下です。
roles/mcp.toolUser:MCPツールを呼び出す権限roles/bigquery.jobUser:クエリを実行する権限roles/bigquery.dataViewer:対象データを参照する権限
制限も把握しておく
Preview版で押さえておくべき制限は次のとおりです。
- クエリ処理時間は最大3分
- 結果行数は3,000行まで
- Google Drive外部テーブルは参照不可
execute_sql_readonlyではDML/DDLが実行不可
3,000行という上限は、AIに「最初の100行だけ見せて傾向を掴んでもらう」用途では十分ですが、全件抽出には向きません。ダッシュボードのバックエンドとして使うのではなく、探索と対話の用途に絞るのが基本の姿勢になります。
BigQuery本体の料金は変わらず、オンデマンドクエリで1TBあたり6.25ドル(東京リージョン)が発生します。MCPサーバー自体には追加料金はありません。コスト設計の詳細はBigQueryのコスト最適化・削減方法|料金を抑えるための実践的ガイドにまとめています。
導入で必ず踏む3つの落とし穴
Google公式のMCPサーバーは触るだけなら10分で動きます。ただ、社内で本番運用に乗せる段になると、以下の3点で必ず躓きます。
1. 権限の粒度が「ユーザー」で終わっている
「営業部の田中さんは全部見られる」という粒度のIAM設計だけでMCPを開けると、Claude経由でも田中さんが見られるデータ全てをAIが叩けます。個人情報や給与のような機密は、そもそもMCPで開くBigQueryプロジェクトから物理的に分離する設計に落とし込む必要があります。
現場でよくやるのは、分析用の派生データセットを別プロジェクトに切り、MCPサーバーからはそのプロジェクトだけを見せる構成です。元の生データセットには誰もMCP経由でアクセスできないため、事故の入り口を塞げます。
2. AIが書くSQLが「正しそうに間違えている」
execute_sql_readonly にアクセスできるようになると、担当者は「先月のCPAが悪化した要因を分解して」と自然文で聞き始めます。LLMはSQLを生成して実行し、それらしい表を返してくれます。ただ、カラム名の意味を勘違いしたSQLは普通に発生します。
「revenue」というカラムに税込・税抜が混在していたり、「conversion_date」が実際は登録日だったり。事後にダッシュボード側で検算する仕組みが要ります。「AIの答えを信じずに、AIの答えをきっかけに検証しにいく」運用フローを最初に決めるのが定石です。
対策として、テーブルと主要カラムにDESCRIPTIONを丁寧に書く、INFORMATION_SCHEMAにビジネス定義を寄せる、get_table_infoで返される情報を意味のある形に整える、といったメタデータ整備が地味に効きます。
3. 監査ログが残らない
BigQuery側のクエリ実行はCloud Audit Logsに残りますが、「どのユーザーが・どのMCPホストから・どんな自然文プロンプトを投げたか」までは自動では残りません。監査要件のある業界(金融・医療・上場企業)では、MCPホスト側の会話ログをまとめて集約する仕組みを先に設計する必要があります。
Claude Enterpriseは会話ログをS3等にエクスポートできますし、Google Workspaceに紐付いたClaudeも監査ログの範囲が整理されつつあります。導入前にセキュリティ部門と要件を握る工程を必ず入れてください。
MCP導入の進め方(4ステップ)
無理なく本番運用に乗せるための現実的な進め方は、4つのステップに分かれます。
ステップ1: 対象データと利用者を絞る(2〜4週間)
最初から全社データを開くと権限設計が終わらないため、対象を明確に絞ります。目安は次のとおりです。
- データ範囲: 1〜2部門の分析用データマート
- 利用者: 5〜10人のパイロットユーザー(データを日常的に触っている層)
- ユースケース: 3〜5個の定型質問(「先月の売上ランキング」「新規顧客の月次推移」など)
このフェーズで、対象テーブルのDESCRIPTIONとビジネス用語辞書を整えます。データ基盤自体が未整備な場合は、先にデータ基盤とは?導入すべき3つの理由と4つの構成要素|2026年版の内容を押さえてから進めるほうが失敗が減ります。
ステップ2: MCPサーバーとホストを接続する(1〜2週間)
Google公式のBigQuery MCPサーバーであれば、BigQuery APIを有効化した上で、必要なIAMロール(mcp.toolUser / bigquery.jobUser / bigquery.dataViewer)をパイロットユーザーに付与するだけで動き始めます。
MCPホストはClaude Desktop・Cursor・ChatGPTのうち、社内標準になっているものを1つ選びます。この段階で複数ホストに広げず、まず1つで運用の型を作るのが鉄則です。
ステップ3: プロンプト・SQL精度の検証(4〜6週間)
3〜5個の定型質問に対して、AIが返すSQLと結果を担当者が検算します。この期間で必ず出てくる「LLMが誤解しやすいカラム」を洗い出し、DESCRIPTIONの追記やビューでの整理を進めます。
体感で7〜8割の質問が実用精度に届いたら、次のフェーズに移ります。100%を目指さず、「AIの回答をきっかけに人が確認しに行く」運用を許容するのが現実解です。
ステップ4: 業務部門へ段階展開(2〜3か月)
パイロットで型が固まったら、業務部門を1つずつ増やします。展開時に必ずセットで行うのは、対象データセットのIAM見直し・利用ガイドラインの周知・監査ログの集約設定の3つです。
全社1,000人が同時に使い始めるような立ち上げは避け、部門50〜100人単位で段階的に広げるほうが、事故対応と改善サイクルが回ります。
導入コスト・期間の目安
MCP導入で発生する費用は、大きく3層に分かれます。
| 費用の種類 | 内訳 | 目安 |
|---|
| BigQuery利用料 | クエリ課金(オンデマンド) | 1TB=6.25ドル、月10万〜50万円が中規模の一般解 |
| MCPホストのライセンス | Claude Enterprise、ChatGPT Enterprise | 1ユーザーあたり月30〜60ドル |
| 導入・移行支援 | データ整備、権限設計、運用設計 | 初期100万〜500万円(社内リソース次第) |
MCPサーバー自体には追加料金がかからないのがGoogle公式版の大きな利点です。OSSのMCPサーバーを自社でホストする場合は、Cloud Runやコンテナのランニングが月数千〜数万円追加されます。
期間は、パイロット完了までで3〜5か月、全社展開まで含めると6〜12か月がひとつの目安です。既存のデータ基盤がデータ基盤構築の費用相場|スモールスタートから本格運用までの目安で解説しているような整った状態にあるかどうかで、前半のステップ1が大きく短縮されます。
未整備な状態から一気にMCPまで作ろうとすると、ステップ1で頓挫するケースが多いため、データ基盤の整備→MCP接続の順で進めるのが手堅い判断です。
まとめ:MCPは「AIが業務データに触る」の標準になる
MCPは、AIホストとデータソースの間にあった個別実装の壁を取り払う標準規格として、2026年に本流化しました。特にGoogleがBigQuery向けにフルマネージドMCPサーバーを提供したことで、「AIから自然文でDWHを触る」ハードルは技術的にはほぼ消えたと言ってよい状態です。
一方で、権限設計・SQL精度・監査ログといった運用面は、MCPを入れれば自動で整うものではありません。むしろMCPで接続の口が広がった分、これまで暗黙に守られていた「SQLを書ける人しか触れない」という自然な制約が外れるため、権限設計の甘さがそのまま事故に直結します。
先にデータ基盤とガバナンスを整え、パイロット部門で運用の型を作り、段階的に広げる。この順序を守れば、MCPは組織のデータ活用の裾野を確実に広げる技術になります。
Evastでは、BigQueryを中核としたデータ基盤の設計から、MCP・RAGを組み合わせた社内AI活用の実装、権限設計・監査ログの運用まで、データ基盤構築サービスとAIコンサルティングサービスで一貫してご支援しています。「まずは自社データでどこまで自然文分析が動くか、パイロットで見たい」というご相談から入っていただくのが実務的な入り口です。
会計SaaSでの具体例はfreee MCPとは?できること・設定手順とデータ基盤との使い分けで、freee公式MCPサーバーを題材に扱っています。