社内AIが業務で使われない本当の原因はデータ準備にある
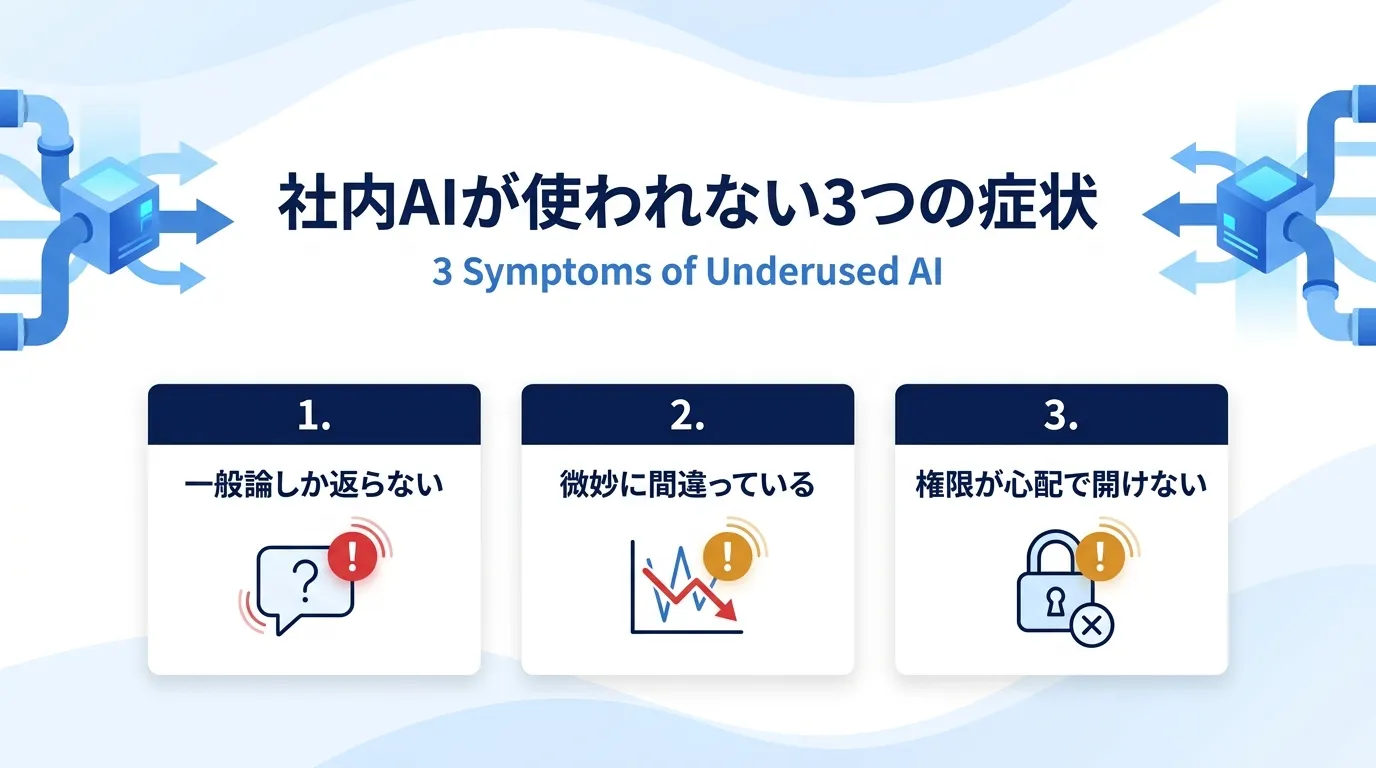
社内AIを導入した企業から相談を受けるとき、うまくいっていないケースの症状はきれいに3つに分かれます。
症状1
一般論しか返らない
「うちの育休は?」→「一般的な日本企業では〜」
原因
社内文書を見に行っていない
症状2
微妙に間違っている
「先月の売上」→ 経理数字と1割ズレる
原因
指標の定義が揃っていない
症状3
権限が心配で全社に開けない
他部署の給与テーブルが見える
原因
権限が問い合わせ時に効かない
症状1: 一般論しか返ってこない
「うちの育休は何日?」と聞いたら「一般的な日本企業では〜」と返る、「先月の東京エリアの売上は?」と聞いたら「正確な数字は社内システムをご確認ください」と返る。この症状は、AIが社内の文書やテーブルを見に行っていないことで起きます。
社内ChatGPT製品の多くはRAG(検索拡張生成)を組み込んで販売されていますが、そこに投入する社内データが接続されていない、または対象範囲が狭すぎる状態のまま運用に入ってしまう企業が少なくありません。ツールを買った瞬間に賢くなるわけではなく、社内文書を渡す仕組みを別途整える必要があります。
症状2: 回答は返るが微妙に間違っている
「先月の売上」を聞いたら数字は返ってきたが、経理の最終数字と1割ずれている。「稼働率」を聞いたら店舗別の平均が出たが、休業日を含めた計算になっている。指標の定義が社内で1つに揃っていない状態でAIに数値を触らせると、こうした「もっともらしいが違う」回答が量産されます。
BIツールで人間が見る前提のデータは、多少ずれていても目視で気づけます。しかしAIは自然文で「そこそこ合っている数字」を出すのが得意なので、間違いに気づける人が少なく、意思決定の品質が下がる方向に働きます。この問題は、AI-readyなデータとは?生成AIに使えるデータの条件と整え方で整理した「定義の統一」に踏み込まないと解決しません。
症状3: 権限が心配で全社に開けない
パイロットで動かしたら、営業部の誰かが「他部署の給与テーブル、見えちゃうんですけど」と気付いた。あるいは、人事情報を扱う想定でなかったのに、AIが機密文書に基づいて回答してしまった。この時点で導入プロジェクトは事実上凍結します。
権限がAIの問い合わせの瞬間に効かない構成でRAGやMCPを組んでしまうと、後から「見せてよいデータだけ」を切り出す作業が莫大になります。データ準備の初期段階で、誰がどの文書・どのテーブルを見てよいかをシステム的に表現できる状態を作っておかないと、パイロット止まりで終わります。
3つの症状に共通するのは、AIそのものの問題ではなく、AIに渡すデータの側が業務で使える状態に整っていないという1点です。ここを飛ばして「もっと良いモデルを試そう」と進めても、たいていは同じ壁にぶつかります。
社内AIに食わせる3種類のデータと、それぞれの整え方
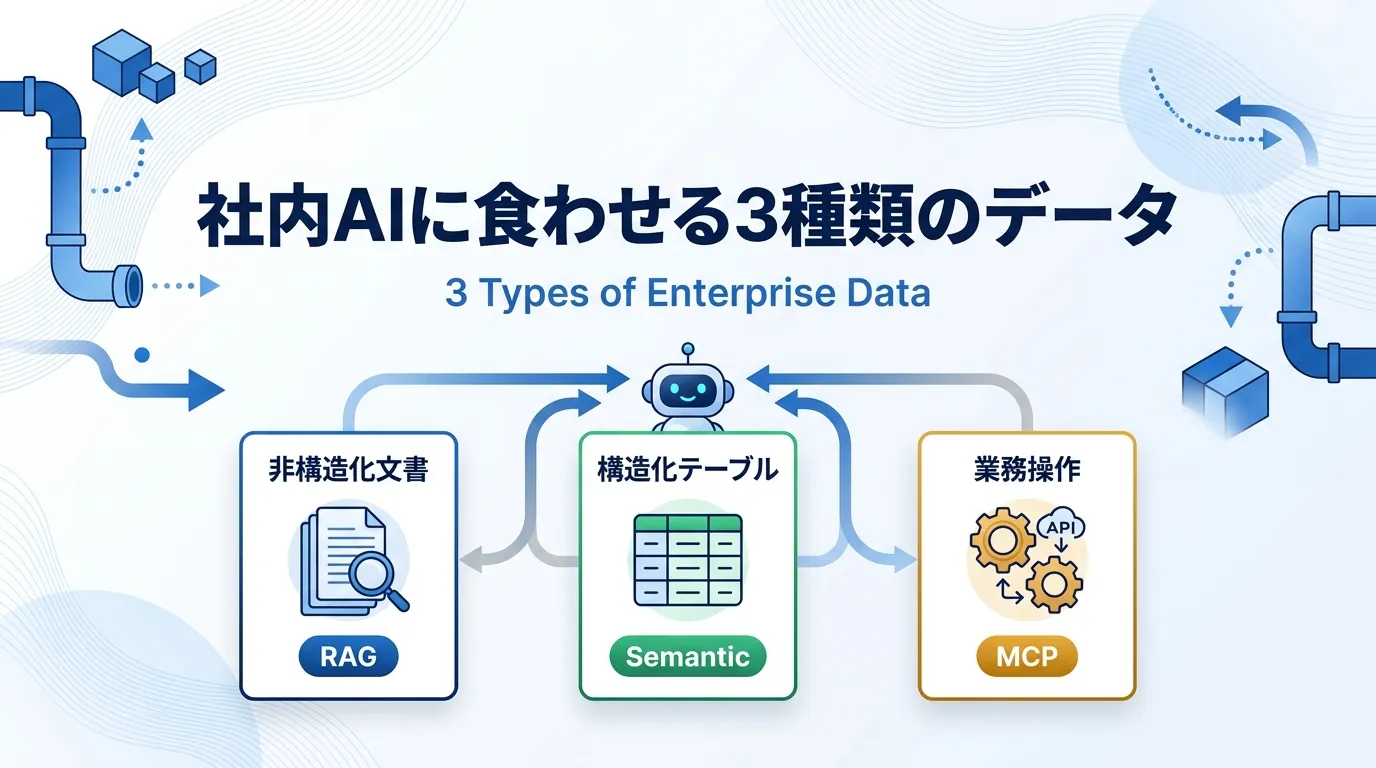
「データを準備する」と一言で言っても、社内AIに扱わせるデータは性質の違う3つに分かれ、それぞれ整え方が違います。まずこの整理を持っておくと、ベンダー提案書を読むときの解像度が変わります。
種類1
非構造化文書
規程・マニュアル・議事録・契約書
整え方
RAG(検索拡張生成)
要点
ベクトルDB+版管理+権限
種類2
構造化テーブル
売上・在庫・顧客・案件(DWH)
整え方
セマンティックレイヤー
要点
指標定義の統一が最重要
種類3
業務システム操作
Salesforce・kintone・Slack
整え方
MCP/ツール呼び出し
要点
読み取り→書き込みの段階解放
種類1: 非構造化文書(規程・マニュアル・議事録)
就業規則、業務マニュアル、営業提案書、議事録、契約書、社内Wiki。テキストや資料の形で存在する社内知識です。「うちの育休は?」「A案件の値引きルールは?」といった自然文の問い合わせに答えさせる用途で、これが最も需要が大きい層です。
整え方はRAG(検索拡張生成)が定石で、文書をチャンク分割してベクトル化し、質問との類似度で検索してAIに渡します。仕組みの詳細はRAGとは?企業の社内データをAIに使わせる仕組みと作り方|2026年版にまとめました。実務でつまずくのは、ベクトルDBの選定より前に、対象文書の版管理と権限です。
- 古い版と最新版が同じフォルダに混在していないか(就業規則の2024年版と2026年版が両方ヒットする状態は事故のもと)
- SharePointやBox、Google Drive上でアクセス権限がきちんと設定されているか
- スキャンPDFなど、テキスト抽出が難しいものが対象に含まれていないか
版管理と権限を整えないままベクトル化に進むと、精度改善のフェーズで必ず巻き戻しが発生します。文書棚卸しは地味ですが、外せない工程です。
種類2: 構造化テーブル(売上・在庫・顧客)
DWH(データウェアハウス)に蓄積されている業務データです。「先月の店舗別売上上位10店」「顧客の解約率」といった数値集計の問い合わせに答えさせる用途で、精度と信頼性の要求が最も高くなります。
整え方の要は指標の定義を統一することです。「売上」が税込みか税抜きか、返品を含むか、締日はいつか、といった前提が部署ごとに違うと、AIは平均的な数字を返して意思決定を歪めます。dbt Semantic Layer、Cube.dev、Looker LookML、Snowflake Cortex Analystといったセマンティックレイヤーで、社内で認定された指標だけをAIに触らせるのが現代の定石です。詳細はセマンティックレイヤーとは?AI時代のデータ活用の要を参照してください。
Snowflakeが2024年に公表した内部ベンチマークでは、単一プロンプトのGPT-4oが51%だったText-to-SQL精度が、セマンティックレイヤー経由のCortex Analystでは90%を超えました(Snowflake公式ブログ)。同じLLMを使っても、渡し方を整えるだけで精度が2倍近く変わります。
生SQLをAIに書かせる構成はデモとしては映えますが、本番導入では権限と定義の統制が難しく、監査でも指摘を受けやすい構成になります。
種類3: 業務システムへの操作(Salesforce・kintone)
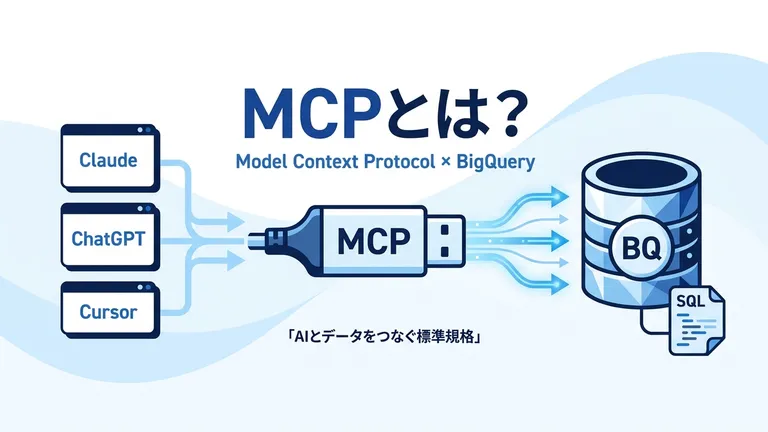
「A社との商談ステータスを『提案中』に更新して」「明日の会議室を予約して」といった、参照だけでなく操作を伴う問い合わせに答えさせる用途です。MCP(Model Context Protocol)やLangChainのツール呼び出しで、AIに業務システムを触らせる形で対応します。
MCPは2024年11月にAnthropicが公開したオープン標準で、GoogleはBigQuery向けのフルマネージドMCPサーバーをPreviewで公開したのち、2026年時点ではGoogle管理のMCPサーバー群を一般提供しています。BigQueryだけでなくSalesforce・Slack・Jira・GitHubなど主要SaaSにも公式・OSSのMCPサーバーが出ています。仕組みはMCPとは?AIエージェントとBigQueryをつなぐ標準規格の実装ガイドで整理しました。
操作系はデータ準備というより「AIに何を触らせて何を触らせないか」の権限設計が本質です。読み取り専用から始めて、書き込みは段階的に開放するのが安全な進め方です。
データ準備プロジェクトの4ステップ
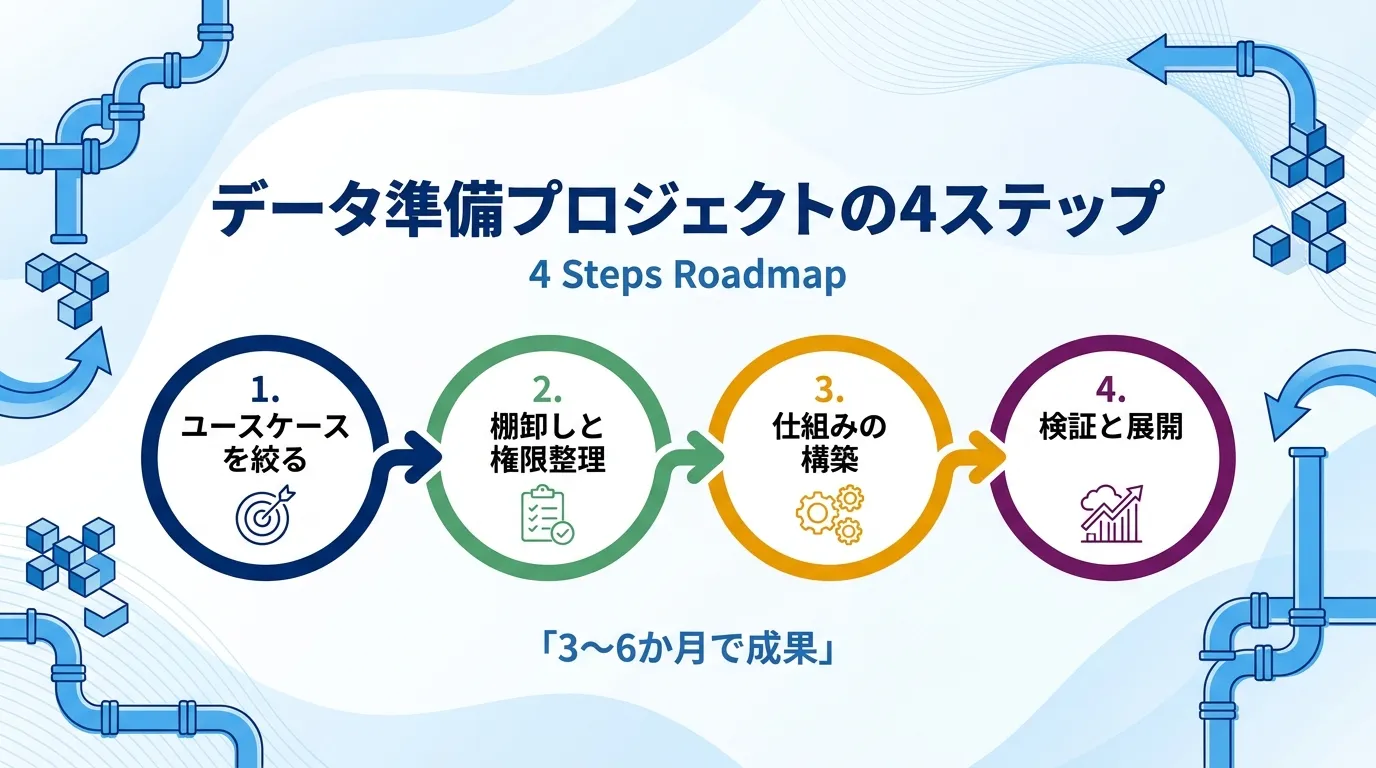
3種類のデータを全部いきなり整えようとすると、確実に頓挫します。実務でうまくいく進め方は、対象を絞って4ステップで回すやり方です。
STEP 1 2〜4週間
ユースケースを1つに絞る
- 価値が見えやすい1業務を選ぶ
- 必要データが手の届く範囲か確認
- 効果指標(KPI)を数字で置く
STEP 2 4〜8週間
棚卸しと権限整理
- 対象文書のリスト化・版統一
- アクセス権限の設計
- 指標定義の統一・鮮度設計
STEP 3 1〜3か月
仕組みの構築
- RAG/セマンティックレイヤー/MCP
- マネージド優先で最小構成
- 想定問答リストで初期精度検証
STEP 4 3〜6か月
精度検証と段階展開
- 正答率・工数・定着率を測定
- 週次で目視レビュー
- 隣のユースケースへ展開
STEP1: ユースケースを1つに絞る(2〜4週間)
「営業担当の見積り作成支援」「経理の規程照会Bot」「情シスの一次サポート」など、価値が見えやすい1つに絞ります。選定のポイントは3つです。
- その用途に必要なデータが手の届く範囲にあるか(全社DWHが必要な用途は初手に選ばない)
- 効果を数字で置けるか(作業時間の削減量、問い合わせ件数の減少など)
- 失敗しても業務が止まらないか(受注可否をAIに判断させるような用途は後回し)
Evastが支援する現場でも、最初のユースケースはほぼ例外なく「バックオフィスの問い合わせ削減」から入ります。金額に直結しない代わりに、失敗の影響が小さく、対象データの範囲を狭く切りやすいためです。
STEP2: 対象データの棚卸しと権限整理(4〜8週間)
選んだユースケースに必要なデータを洗い出し、以下を1つずつ潰します。
- 対象文書のリスト化:どのフォルダの、どのファイルを対象にするか。古い版・重複・不要ファイルを排除
- アクセス権限の整理:誰がどの文書・どのテーブルを見てよいか、システム側で表現できる形にする
- 指標の定義統一(構造化データを含む場合):「売上」「顧客数」など、AIが触る指標の定義を1つに揃える
- 鮮度と更新運用の設計:文書が更新されたときにベクトルDBやカタログにどう反映するか
このフェーズを飛ばして先にツールを選ぶと、後工程で必ず戻ってきます。地味ですが、ここに時間をかけた案件ほど本番導入後の精度が安定します。
STEP3: RAG/MCP/セマンティックレイヤーの構築(1〜3か月)
3種類のデータ性質に応じて、必要な仕組みを最小構成で組みます。
- 非構造化文書:ベクトルDB(pgvector、Pinecone、Vertex AI Search、Azure AI Searchなど)+Embeddingモデル+RAGオーケストレーション
- 構造化テーブル:DWH(BigQuery、Snowflake、Redshift)+セマンティックレイヤー(dbt/Cube/LookML/Cortex Analyst)
- 業務操作:MCPサーバー(公式・OSS・自作)+認証・監査ログ
すべて自前で組むかマネージドを使うかは、社内のデータエンジニア人数と学習コストで決めます。パイロットではマネージドで速く動かして、価値検証後に必要ならOSSに置き換えるのが定石です。
STEP4: 精度検証と段階展開(3〜6か月)
小さく展開して回答精度と業務効果を測定し、対象範囲を広げていきます。ここで見るべき指標は「AIの回答精度」だけではありません。
- 回答の正答率(想定問答リストに対する一致率)
- 業務工数の削減量(問い合わせ対応時間、資料検索時間など)
- 利用の定着率(週次アクティブユーザー数、1人あたり問い合わせ数)
- エスカレーション率(AIで解決せず人に回った割合)
利用が定着しない原因の多くは「回答が微妙に間違っている」ことなので、正答率の目視レビューと現場ヒアリングを最初の3か月は毎週回します。ここで精度を上げ切ってから、隣の部署・隣のユースケースへと広げていきます。
費用と期間の目安
社内AIのデータ準備は、対象範囲と統制要件で費用が大きく変わります。発注前の予算感覚として、代表的な3パターンを置いておきます。
| パターン | 対象 | 期間 | 初期費用 | 月額運用 |
|---|
| スモールスタート | 1部署・1ユースケース | 3〜5か月 | 200万〜800万円 | 15万〜60万円 |
| 部門展開 | 1本部・3〜5ユースケース | 6〜10か月 | 800万〜2,000万円 | 40万〜150万円 |
| 全社AI基盤 | 全社主要データ・複数用途 | 1年〜1年半 | 1,500万〜5,000万円 | 100万〜500万円 |
初期費用にはデータ棚卸し・権限整理・RAG/MCP/セマンティックレイヤーの構築・ベンダー支援費が含まれます。月額運用は、LLM APIの従量課金(ChatGPT Enterprise、Claude Team、Gemini API、Azure OpenAIなど)、ベクトルDBのマネージド費、BIツールライセンス、監視・保守費の合計です。
ヘビーユースの現場ではLLMのトークン課金だけで月100万円を超えることもあり、想定利用量とモデル選択(軽い問い合わせはHaikuやGPT-4o mini、複雑なものだけOpus/GPT-4o)を含めた設計が費用最適化の要になります。データ基盤側の初期費用の内訳はデータ基盤構築の費用相場は?見積もりの内訳と判断基準を解説で分解しました。
実装現場で必ず出る失敗パターン
Evastが伴走している案件と、他社に発注した後に相談が来た案件を並べると、社内AIのデータ準備でつまずくパターンは驚くほど似ています。代表的な5つを共有します。
失敗1: ベンダーの標準RAGに全文書を突っ込む
「まず全部入れてから精度を見ましょう」の提案は、聞こえは前向きですが、対象範囲を絞らないまま数万件の文書をベクトル化すると、検索でノイズが増えて精度が下がります。古い版と新版が両方ヒットして矛盾する回答が出るのが典型例です。先に対象範囲を絞ってから入れるが鉄則です。
失敗2: 権限を後回しにして本番展開が凍結
パイロットは開発環境で全員フルアクセスで動かしていたが、本番展開の直前で「機密文書のアクセス制御ができていない」と法務・情シスから待ったがかかる。ここから権限設計をやり直すと3〜6か月遅延します。権限は最初のユースケース選定の時点で要件を固める必要があります。
失敗3: 指標定義の統一を飛ばしてAIに数値を触らせる
BIダッシュボードで見る分には気にならなかった「売上」「顧客数」の定義違いが、AIの回答では致命傷になります。「先月の売上」が回答するたびに変わる、部署によって違う数字が返る、といった状態は現場の信頼を一気に失います。数値系のユースケースを組むなら、セマンティックレイヤーは省略できません。
失敗4: 更新運用を設計せず「入れて終わり」
初期構築時にベクトル化した文書がそのまま放置され、半年後には古い規程で回答するようになる。文書の追加・更新・削除をベクトルDBに反映する運用フロー(差分同期、削除フラグ、承認フロー)を設計に組み込まないと、時間が経つほど精度が落ちます。
失敗5: 「PoCで数字が出たから全社展開」で失速
1部署・限定ユーザーでうまくいったからと、次の日から全社に開放して失敗するパターンです。対象データ範囲・利用者の背景知識・許容できる回答精度が違うと、同じ仕組みでも定着しません。部署ごと・ユースケースごとに、STEP2の棚卸しから毎回やり直すのが安全です。
まずは1ユースケースから、小さく確実に動かす
社内AIのデータ準備は、「全社データをAI-readyに整える」という発想で始めると、ほぼ確実に頓挫します。1つのユースケースに絞り、そこに必要なデータだけを整え、精度と定着を確認してから次に進む、という順番でしか成果は出ません。
判断の起点として、まず次を確認するのがおすすめです。
- 社内でAIを一番使いたい業務は何か(現場ヒアリング)
- そのユースケースに必要な文書・テーブルは、どこにあるか(場所とアクセス経路)
- そのデータの版管理と権限は、現時点でどこまで整っているか(棚卸し)
- 効果を測る数字を何にするか(削減時間・エスカレーション率など)
Evastは、データ基盤の設計から社内AIのデータ準備・RAG構築・MCP接続・セマンティックレイヤー導入まで、1ユースケース単位で3〜6か月のスモールスタート伴走から入る形で支援しています。「まず何から手をつけるべきか」から相談したい場合は、データ基盤構築サービスの窓口からお問い合わせください。
社内AIが本当に業務を変えるかどうかは、モデルの選択ではなく、渡すデータの整え方と、対象範囲を絞る勇気で決まります。