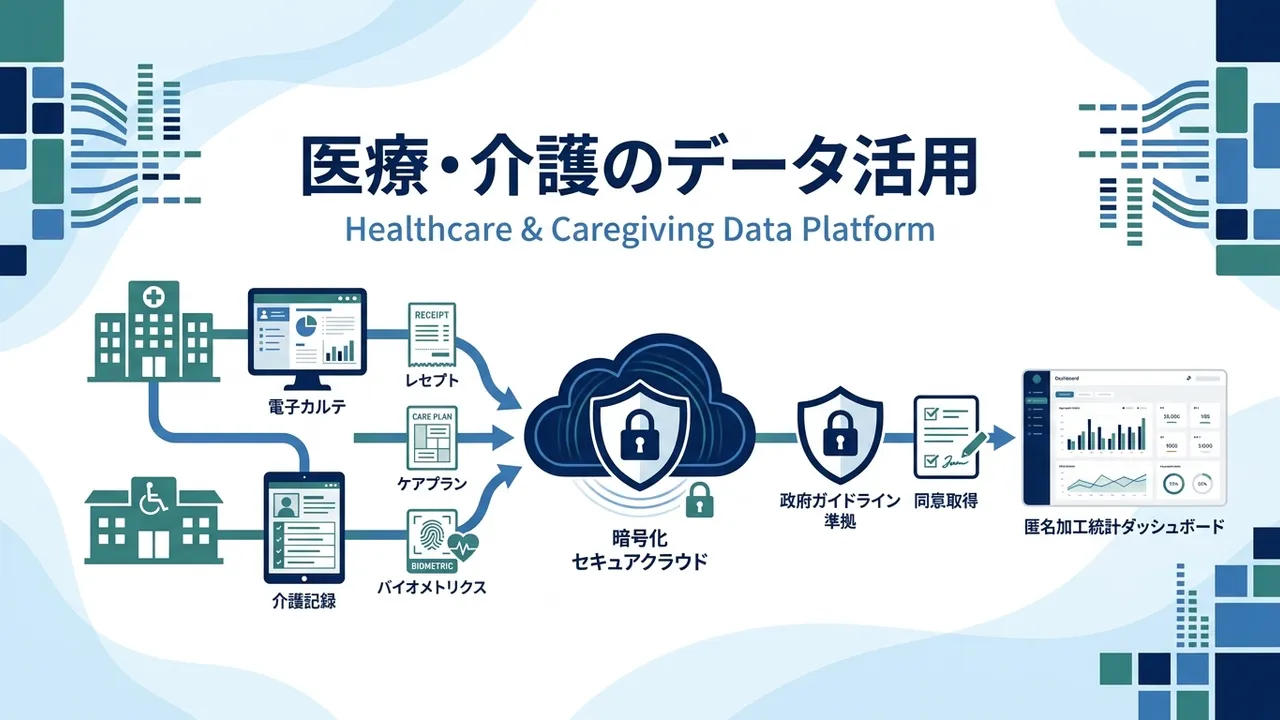
医療・介護のデータ活用が難しい構造的な理由 医療・介護でデータ活用が特に大変なのは、他業種と比べても「データの重要度」と「システムのばらけ方」の両方が極端だからです。まず、この構造から見ていきます。
1拠点ぶんのデータ源
電子カルテ 診療録・処方・検査レセコン 診療報酬請求データ部門システム 放射線・検体・リハビリ介護記録 ADL・バイタル・LIFEバックオフィス 勤怠・会計・施設予約PHR連携 紹介状・地域連携×
=
本部の負荷
要配慮個人情報の
経営判断が
1拠点ぶんの医療・介護データは複数システムに分散し、要配慮個人情報として扱いも厳しい。拠点数×システム×患者/利用者数の掛け算で法人本部の集計と経営判断が停滞する 図のように、1つの医療法人や介護事業者が扱うデータは、それぞれ別のシステムに閉じ込められています。
電子カルテ :診療録、処方、検査結果。ベンダーごとに独自のデータ構造レセプトコンピュータ :診療報酬請求データ。月次で確定医事会計・部門システム :放射線、検体検査、内視鏡、リハビリ等介護記録 :ケアプラン、ADL、バイタル、LIFEに提出する科学的介護データバックオフィス :勤怠、給与、財務会計、施設予約PHR・院外連携 :紹介状、地域医療連携、マイナポータル経由の患者閲覧これが1拠点ぶんです。複数の医療機関を運営する法人や、医療と介護を併営する事業者では、同じ作業を拠点数ぶん繰り返します。ここが医療・介護特有の「掛け算のつらさ」です。
さらに厄介なのが、次の3点です。
電子カルテがベンダーごとに分断されている のが医療の実情です。国内では複数の主要ベンダーが200床未満向け・200床以上向け・診療所向けなどでシェアを分け合い、データ構造もエクスポート機能も揃いません。厚生労働省はHL7 FHIRベースの標準規格やSS-MIX2ストレージの整備を進めていますが、標準規格に完全対応している電子カルテはまだ限られます。
すべてが要配慮個人情報 という前提から逃げられません。診療情報や介護記録は個人情報保護法における「要配慮個人情報」に該当し、取得・利用・第三者提供のすべてに厳しいルールがかかります。データ基盤に持ち込む段階から、院内利用と外部利用の境界を明確にしておかないと、後で運用が止まります。
オンプレ運用が根強い のも医療業界の特色です。3省2ガイドラインに準拠したクラウドの利用は認められていますが、電子カルテ本体は依然として院内サーバに置くケースが多数派で、データ抽出のたびに院内ネットワークとクラウドを橋渡しする設計が必要になります。
私見ですが、こうした構造を踏まえずに「AIで介護記録を要約」「BIで経営ダッシュボード」といったツール導入から入ると、ほぼ確実にPoCで止まります。順序を間違えないことが、この領域では特に効いてきます。
2026年時点で押さえるべき法規制とガイドライン 医療・介護のデータ基盤を設計するときの拠り所は、大きく3つあります。いずれも2023〜2025年にかけて改定・施行されており、それ以前の常識のまま設計を進めると監査で引っかかります。
医療情報システムの安全管理ガイドライン 第6.0版(厚生労働省) 2023年5月に改定された版が2026年9月時点でも最新で、従来1本だったガイドラインが「経営管理編」「企画管理編」「システム運用編」の3編構成になりました。特に大きな変化は、境界防御型の思考だけでなくゼロトラストの考え方を取り入れることが明記された 点と、クラウドサービス利用時の責任分界がシステム類型別に整理された点です。
医療法人の理事長や病院長は、経営管理編に沿った方針策定の責任を負います。「情シスに任せてある」では済まなくなった、という理解が現場感覚に近いです。
医療情報を取り扱う情報システム・サービス提供事業者向けガイドライン 第2.0版(総務省・経済産業省) 事業者向けは以前2本に分かれていましたが、2020年8月に統合され、2023年7月の1.1版を経て、2025年3月に第2.0版へ改定されました。厚労省版と合わせて「3省2ガイドライン」と総称します。第2.0版では対象事業者の範囲が明確化され、医療機関と事業者のあいだで交わす合意内容(責任分界や再委託の扱い)とリスクコミュニケーションの記述が大幅に強化されています。基盤構築を外部に委託する側としては、契約書と覚書の内容がこの版に沿っているかを必ず確認 してください。AWSは2024年6月に第6.0版対応の利用リファレンスを、Microsoft Azureは2024年10月に「医療機関向けクラウドサービス対応セキュリティリファレンス2024年度」を公開しており、対応済みクラウドの選択肢は広がっています。
改正次世代医療基盤法(2024年4月施行) 従来からある「匿名加工医療情報」に加えて、2024年4月から**「仮名加工医療情報」の枠組みが新設**されました。仮名加工は匿名加工より情報量を残した状態で研究利用できる仕組みで、認定を受けた作成事業者・利用事業者だけが取り扱えます。NDB等の公的データベースとの連結も可能になったため、院外との研究連携の選択肢が実務的に増えています。
押さえどころは「院内利用」と「外部利用」の分離 3つのガイドライン・法規を通読すると細かい要件は多岐にわたりますが、実務で最初に決めるべきは1点だけです。基盤上のデータを、院内経営分析・品質改善までで使うのか、それとも研究や外部提供まで想定するのか 、この線をはっきり引くことです。
院内利用に閉じる限りは、利用目的の患者・利用者への説明と、通常のアクセス制御・監査ログの範囲でおおむね進められます。外部利用まで踏み込むなら、次世代医療基盤法の仮名/匿名加工の仕組みか、認定事業者を経由する経路を最初から前提に設計する必要があります。
データ基盤構築の3つのアプローチ 医療・介護でデータ活用を進めるときの選択肢は、大きく3つに整理できます。それぞれ費用と柔軟性のトレードオフがあります。
① ベンダー純正BI電子カルテ/介護記録付属
同一ベンダー内で即導入 診療科別売上・加算算定は標準搭載 複数ベンダー横断は不可 初期 0〜50万円+月3〜10万円/導入1〜4週間
→
② 既存BIとSS-MIX2連携Looker Studio・Tableau
CSV/SS-MIX2から日次連携 始めやすいが属人化しがち ベンダーごとに実装差あり 初期 200〜600万円+月数千〜数万円/4〜8週間
→
③ 3省2ガイドライン準拠クラウドBigQuery / Redshift / Synapse
複数拠点・医療×介護を横断 LIFE活用・外部研究連携まで拡張 ゼロトラスト設計に対応 初期 600〜1,500万円+クラウド利用料/4〜8週間で最初の運用
医療・介護のデータ活用3アプローチ。複数拠点・医療と介護の横断・LIFEやHL7 FHIRの活用まで見据えるなら3省2ガイドライン準拠の専用基盤(③)が総額を抑えやすい ① 電子カルテ・介護システムベンダー純正のBIオプション 電子カルテや介護記録システムのベンダーが提供する追加モジュールを使う方式です。同一ベンダー内なら追加設定で導入でき、診療科別売上や在院日数、加算算定状況といった業界標準のレポートは最初から揃っています。
初期0〜50万円、月3〜10万円、導入1〜4週間 が相場です。ただし、複数の電子カルテを併用している法人や、医療と介護を横断したい場合は、ベンダーの提供範囲を超えられません。単一ベンダーの単一拠点で経営指標を見たいだけなら、この選択が最短 です。
② 既存BIツールとのCSV/SS-MIX2連携 Looker StudioやTableau、Power BIといった汎用BIツールに、電子カルテのCSVエクスポートやSS-MIX2ストレージからデータを流し込む方式です。日次バッチで前日の実績を集計する用途に向きます。
初期200万〜600万円、月数千〜数万円、4〜8週間 が目安です。始めやすい反面、SS-MIX2の実装レベルはベンダーによって差があり、「対応しているが項目が限定的」というケースを事前に見抜けないと、後から仕様変更で工数がかさみます。属人化しやすいのもこの方式の弱点です。
③ 3省2ガイドライン準拠のクラウドで専用データ基盤を構築 Google Cloud(BigQuery)、AWS(Redshift)、Microsoft Azure(Synapse Analytics)といった3省2ガイドライン対応のクラウドDWH上に、法人専用のデータ基盤を作る方式です。複数拠点・複数事業を横断でき、将来のLIFEフィードバック活用や、AIによる需要予測、次世代医療基盤法を使った外部連携まで拡張できます。
初期600万〜1,500万円、クラウド利用料が月数万円〜十数万円、4〜8週間 で最初の運用に入るのが標準です。3拠点以上を持つ医療法人や、医療と介護を併営する事業者 では、②→③に途中で移行するより最初から③で作るほうが総額を抑えやすい傾向があります。データ基盤の費用感と積算の考え方はデータ基盤構築の費用相場|規模別の見積もり方と削減ポイント で詳しく解説しています。
LIFEと電子カルテ情報共有サービスをどう組み込むか 制度側の動きが早いため、2026年時点で検討する場合は次の2つを設計に織り込んでおく必要があります。
LIFE(科学的介護情報システム)を「加算のため」で終わらせない LIFEは介護事業者が利用者のADL・栄養・口腔機能・認知機能などを提出し、フィードバックを受けてケアプランに反映するPDCAの仕組みです。科学的介護推進体制加算として月40〜60単位/利用者 が算定できるため、多くの事業者は加算算定のために導入します。
ただし、提出したデータとフィードバックは自事業者側にも残せます。これを事業者のデータ基盤に取り込むと、複数施設を横断した入所者アウトカム比較や、加算算定の抜け漏れチェックといった、加算の枠を超えた活用ができます。2024年度改定で提出頻度が上がった分、電子記録システムからLIFEへのCSVアップロードを手作業で回すのは限界が近づいており、記録システムAPIから基盤経由で自動化する構成が現実解になりつつあります。
電子カルテ情報共有サービス(2027年1〜2月に全国展開予定) 厚生労働省の「医療DX令和ビジョン2030」の中核として、電子カルテ情報共有サービスが2025年1月から全国9地域・22医療機関でモデル事業として始まりました。当初は2025年度中の本格運用を目指していましたが、傷病名・感染症・アレルギー・検査情報の仕様と現場運用のズレが表面化し、2026年3月の「概要案内2.0版」で仕様が抜本的に見直されています。現在は2026年10〜12月に再度のモデル事業で検証したうえで、2027年1〜2月に全国展開を開始する計画 です。傷病名・処方・アレルギー・検査結果など、医療機関間で共有すべき情報が標準規格で流通するようになります。
自法人のデータ基盤を設計するとき、この標準規格(HL7 FHIRベース)を出力・入力できる構造にしておくと、将来の院外連携や紹介・逆紹介の効率化が視野に入ります。逆に、独自スキーマで固めてしまうと、数年後に再構築が必要になるリスク があります。
4〜8週間で始めるスモールスタート いきなり要配慮個人情報を含む本格基盤から始める必要はありません。医療・介護の場合、以下の順序で段階的に立ち上げるのが安全かつ現実的です。
1週目:スコープ確定と院内合意
対象拠点、対象システム、対象データを最初に絞ります。診療録本体には触れず、医事会計と勤怠、介護記録の集計値だけに絞る のが定番です。個人情報保護管理者・医療情報安全管理責任者への説明と、院内の情報セキュリティ委員会への付議もこの週で終わらせます。
2〜3週目:接続と初期構成
電子カルテのCSV日次出力(多くの電子カルテが標準で持つ機能)と、レセコンの月次データ、介護記録システムのAPIをクラウド上のストレージに連携します。この段階では患者ID・利用者IDをハッシュ化して基盤に入れる設計 にしておくと、後から外部利用の議論が出たときの選択肢が広がります。
4〜6週目:ダッシュボード実装と運用リハーサル
診療科別の患者数・売上、病棟別の在院日数、介護度別の稼働率、時間帯別の入退室といった経営指標のダッシュボードをLooker StudioやPower BIで実装します。理事長・院長・事務長・介護部長といった利用者ごとに閲覧範囲を分け、監査ログが機能することを確認します。
7〜8週目:本番運用切替と体制引き継ぎ
Excel運用と並行運用したうえで、月次締めのタイミングで切り替えます。この段階で、データの追加要件(患者単位の分析、LIFEフィードバック活用、AIによる予測など)が現場から出てきたら、次のフェーズとして計画します。
集計値レベルまでで完成させると、要配慮個人情報を扱わない範囲でデータ活用の土台ができます。ここから患者・利用者単位の分析や、次世代医療基盤法を使った外部連携に進むかは、成果と体制を見ながら判断します。
よくある失敗パターン 医療・介護のデータ基盤構築で頻出する失敗を3つだけ紹介します。
電子カルテ刷新のついでに基盤も、で頓挫する 電子カルテのリプレースは3〜5年に一度の大型プロジェクトで、ベンダー主導・院内負荷が最大化するタイミングです。同時にデータ基盤の話を進めると、電子カルテ選定が優先されて基盤の要件が後回しになり、結局ベンダー純正BIの範囲で妥協することになります。データ基盤は電子カルテのリプレースとは切り離し、既存電子カルテからの抽出を前提に別トラックで進めるほうが結果的に速いです。
同意設計を後から追加しようとする 基盤の設計と実装が終わってから「実は外部研究にも使いたい」となると、既に取得した情報の利用目的追加が困難で、患者・利用者への再説明と再同意取得が発生します。基盤設計の最初の週に、院内利用に限るか外部利用まで想定するかを理事会レベルで決めておく 必要があります。
LIFEの提出データだけで基盤を組む 加算算定のためにLIFEデータだけを整えても、経営判断に必要な稼働率や職員配置、収支といった指標は別システムに残っているため、経営ダッシュボードとしては使えません。介護事業者の場合はLIFE + 介護保険請求 + 勤怠 + 会計の4点セットが最小構成 です。
このあたりの構造は業種を問わずに共通する部分もあり、データ基盤構築でよくある失敗パターン やExcelから脱却してデータ基盤に移行する進め方 も併せて参考にしてください。
まとめ:慎重さと段階設計が総額を決める 医療・介護のデータ活用は、他業種の「ツールを買って集計を自動化する」発想とは前提が違います。要配慮個人情報を扱うこと、電子カルテがベンダーごとに分断されていること、3省2ガイドラインへの準拠が必須であることの3つが、設計と契約と体制のすべてに影響します。
ただし、慎重に段階を踏めば決して手が届かない領域ではありません。まず院内経営ダッシュボードから始めて、要配慮個人情報を扱わない範囲でデータ活用の型を作る。次にLIFEフィードバックや患者・利用者単位の分析に進む。最後に、必要があれば次世代医療基盤法の枠組みで外部連携に踏み出す。この順序を守るだけで、頓挫リスクが大きく下がります。
データ基盤を組織で根付かせるための土台については、なぜ今データマネジメントが必要か?2026年DX成果を分ける4つの要点 で詳しく整理しています。
Evastでは医療法人・介護事業者向けに、3省2ガイドライン準拠のクラウド上でのスモールスタート型データ基盤構築と、要配慮個人情報の同意設計・院内合意プロセスの支援を行っています。既存の電子カルテ・介護記録システムを活かしたまま、経営ダッシュボードから段階的に立ち上げるご相談は、下記からお気軽にお問い合わせください。
→ データ基盤構築サービスを見る
→ データマネジメント支援を見る