SaaSのプロダクトデータ基盤が構造的に難しい理由 SaaSでデータの統合が特に大変なのは、他業種と比べても「プロダクト内の行動」「課金・請求」「営業・契約」「カスタマーサクセス/サポート」の4層が、別々の目的で最適化された別々のSaaSに閉じており、共通ユーザーIDや共通企業IDでつながらないことに原因があります。まず、この構造から見ていきます。
プロダクト行動
Amplitude 機能利用・ファネルMixpanel コホート・リテンションGA4/PostHog ページ・イベントSegment イベント収集・配信anonymous_id / user_id
課金・請求
Stripe プラン・MRR・返金Chargebee 複雑な契約体系自社課金 エンプラ個別契約会計SaaS 売上計上・繰延customer_id / subscription_id
営業・契約
Salesforce 商談・ARR・更新HubSpot SMB向けCRMNotion/Sheets エンプラ個別管理MA リード獲得・スコアAccount ID / Contact ID
CS・サポート
Intercom 会話・NPSZendesk 問い合わせ・SLAヘルススコア CS独自設計Slack Connect 顧客との会話Contact ID / 会話ID
共通ユーザーID/企業IDで名寄せする層がなく、企業別「LTV × チャーン兆候 × プロダクト行動」を1画面で見られない
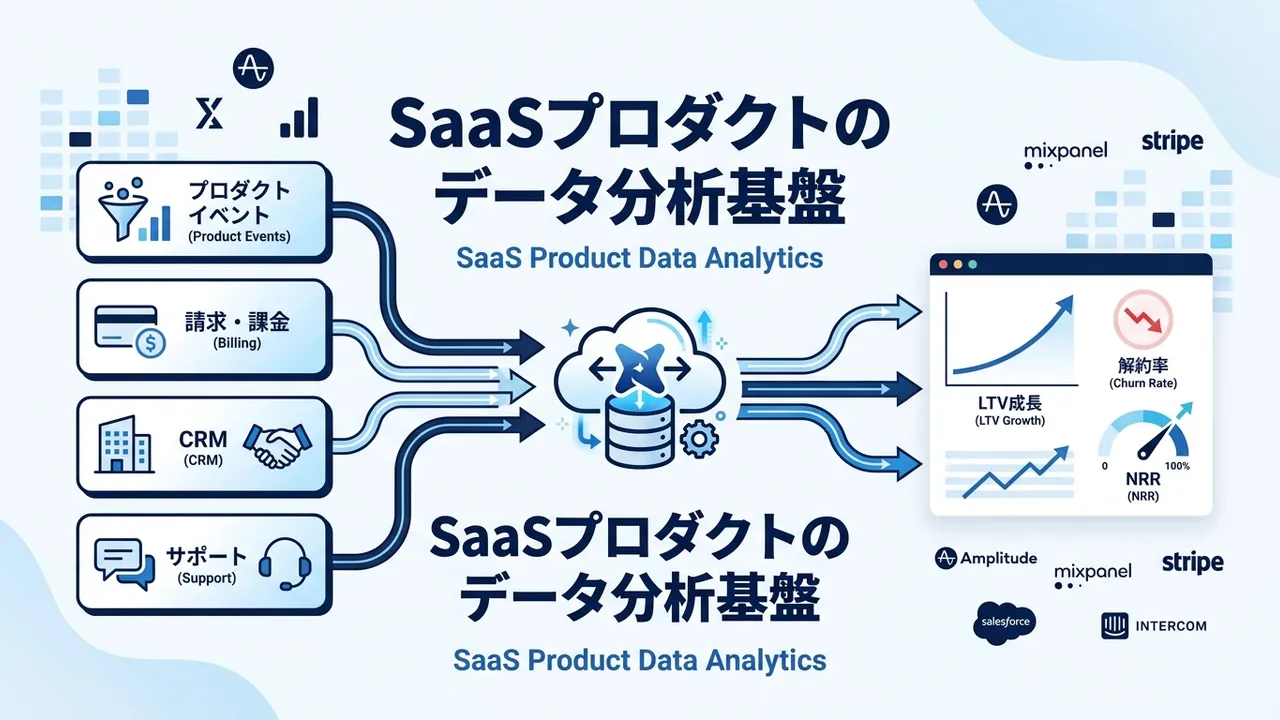
SaaSのデータは、プロダクト行動・課金・営業/契約・CS/サポートの4層が別ツール・別IDに閉じ、LTV/チャーン/NRRを1つの粒度で計算する共通レイヤーが存在しない構造で分断される 図のように、SaaSのユーザーデータは大きく4つの層に分かれています。
プロダクト内の行動ログ は事業の心臓部です。ページビュー、機能利用、ボタンクリック、エラー発生、機能内の滞在時間、といったイベントがAmplitude・Mixpanel・PostHog・GA4・Segment、あるいは自社実装のイベント基盤に流れています。SaaS事業ではこの層のデータ量が最も大きく、月間で数千万〜数億イベント に達することも珍しくありません。
課金・請求データ は経営の根幹です。Stripe・Chargebee・自社課金システムに、契約プラン、MRR、決済成功/失敗、アップグレード、ダウングレード、解約日、返金といったイベントが記録されています。プロダクトの行動ログとは別のスキーマ・別のIDで管理されているのが一般的です。
営業・契約データ はエンタープライズ案件の中核です。Salesforce・HubSpot・自社CRMに、リード、商談、契約、更新、ARR、契約担当者、業種、従業員規模といった情報があります。ここでのIDはSalesforce Account IDやHubSpot Company IDで、プロダクト側のuser_idとは別体系です。
カスタマーサクセス/サポート はチャーンの兆候を握っている領域です。Intercom・Zendesk・Notion・Slackコネクト、社内ヘルスコアツールに、問い合わせ内容、対応履歴、NPS、健康度スコア、オンボーディング進捗が入っています。CSMが日々見ているダッシュボードはここに集約されていますが、これも独立したIDで管理されています。
この4層のデータを、経営会議で「A社のNRRが下がっている原因は、プロダクト内でどの機能利用が落ちて、CSがどう対応していて、それがどのプランでの現象なのか」と1画面で見たい、というのが本来のあるべき姿です。しかし4層のツールが別々のIDで動いているため、この一発の問いに答えるのに、各SaaSからのCSV出力を突き合わせる作業が発生します。
さらに厄介なのが、次の3点です。
ゲスト→会員化の瞬間にIDが分岐する のがSaaS特有の悩みです。無料トライアルで匿名IDのまま数日プロダクトを触り、サインアップした瞬間にuser_idが発行される。データ基盤でanonymous_idとuser_idを紐づけて過去の行動を再アトリビュートしないと、「無料トライアル中にどの機能を触ったユーザーが有料転換したか」の分析ができません。
ユーザー単位と企業(アカウント)単位のどちらでMRRを見るかの設計が甘い のもよくある問題です。プロダクトはuser_id単位でイベントが飛び、契約は企業単位(Salesforce Account単位)で結ばれます。エンタープライズ契約では1企業に数十〜数千ユーザーがぶら下がるので、user_id ↔ account_id ↔ contract_id の3段紐づけ設計をやり切らないと、企業別のヘルススコアが出せません。
MRR/ARRの定義が部門ごとにズレている のが3点目です。営業のARR、経理の売上、プロダクトのアクティブ企業数、CSの担当企業数、これらが同じ数字を指すはずが、契約解除日・返金・トライアル扱いの解釈で3〜5%ズレて、経営会議で毎回議論になるのが典型パターンです。
こうした構造があるため、プロダクトとユーザーと契約が増えるほど、SaaSのデータは「プロダクトアナリティクスSaaSで行動は見えるが、LTV・チャーン・NRRを事業評価と結びつけた経営判断ができない」という壁にぶつかります。データ基盤の全体像そのものを押さえたい方は、データ基盤とは?企業が導入すべき3つの理由と構成要素を解説 を先に読んでいただくと、この記事の話がより具体的に感じ取れます。
Amplitude/Mixpanel止まりを判断する4つのサイン 「うちはAmplitudeを入れていて、プロダクトの行動は見えている」「Stripeのダッシュボードで課金は把握できている」というSaaSは多いのですが、じわじわとひずみが出ているケースがほとんどです。次の4つで、統合検討の時期を判断できます。
サイン1: チャーン分析にプロダクト内の行動を組み込めていない これが最もはっきりした判断基準です。「先月チャーンした企業のうち、直近30日でログイン頻度が半減していたのは何社か」「解約直前1週間で特定機能の利用が消えていたユーザー比率は」といった問いに、Stripeのダッシュボードだけでは答えられません。Amplitude単体では課金停止イベントが取れず、逆にStripeだけでは行動ログが見えないためです。
チャーンを事後に集計するのではなく、チャーンの兆候を先読みしてCSがアクションする 運用に移りたいなら、プロダクト行動と課金と契約を1つのデータ基盤で結ぶ必要が出てきます。
サイン2: MRR/ARRの数字が部門ごとにズレて経営会議で毎回議論になる 営業の言うARRと、経理の言う売上と、プロダクトの言うアクティブ企業数が微妙にズレる。ズレ幅は3〜5%だが、経営会議で毎回「どの数字が正しいのか」の議論が10分入る。これが月次で続いているなら、セマンティックレイヤー (MRRやLTVの定義をSQLではなく共通モデルで持つ層)を挟むデータ基盤化のフェーズに入っています。
数字を「定義そのもの」として1回モデル化してしまえば、経営会議のたびに議論するコストが消え、そのぶんの時間を打ち手の議論に回せます。
サイン3: プロダクトチームと営業/CSチームが別のダッシュボードを見ている PMはAmplitudeで機能採用率を、営業はSalesforceで商談パイプラインを、CSはIntercomで問い合わせを、経営はスプレッドシートでMRRを見ている。同じ「顧客」を語っているのに、全員が違うダッシュボードから違う切り口の数字を持ち寄る 状態は、SaaSのスケールに従って必ず来ます。
この状態が続くと、「PMが機能改善しても、それがNRRに効いたかを追えない」「CSがヘルスコアを見ても、プロダクト側の兆候が反映されていない」という分断が固定化します。データ基盤で1つの真実の顧客ビュー(Customer 360)を持てば、部門横断でユーザーを見る土台ができます。
サイン4: エンタープライズ契約が増えて企業単位のヘルススコアが要る SMB向けSaaSでARR10億円を超え、大手企業向け(エンタープライズ)契約が売上の30%以上 を占め始めると、企業単位のヘルススコア(利用状況・契約更新確度)が要求されます。エンタープライズ契約は1社解約のインパクトがSMB100社ぶんに相当するため、CS/セールスが企業単位で先読みするデータが必要です。
このスコアリングには、プロダクト内の行動集計(企業所属ユーザーのMAU/機能採用率)・契約情報・サポート履歴・営業活動を同じ企業IDで結んだテーブルが不可欠で、これはAmplitudeやSalesforce単体ではまかなえません。
4つのうち2つ以上に当てはまれば 、SaaSのプロダクトデータ基盤化を検討するフェーズに入っています。逆に、ARR3億円以下でユーザー数万まで、プロダクトも1つ、プランも数本のうち はAmplitude/Mixpanel+Stripeダッシュボード+スプレッドシートの組み合わせでしばらく戦えます。業種横断のExcel限界サインについては、Excel集計が限界になったら|スプレッドシートからデータ基盤への移行 にもまとめています。
SaaSプロダクトデータ基盤の3つのアプローチと費用相場 「統合」といっても、実現手段はいくつかあります。SaaSでよく検討されるのは、次の3つです。それぞれ費用感と柔軟性がまったく違います。
① プロダクトアナリティクスSaaSAmplitude / Mixpanel / PostHog
プロダクト内行動の分析 課金・CRMは弱い連携 SQLレスで運用可能 月10〜50万円導入2〜6週間/MTU課金
→
② GA4+BigQuery自作GA4 / BigQuery / Looker Studio
GA4イベントを無料エクスポート Stripe/Salesforceも集約 SQLでチャーン/LTV分析 初期 100〜300万円+月数千〜数万円/4〜8週間
→
③ モダンデータスタックSegment × DWH × dbt × BI
プロダクト/課金/CRM/CSを統合 MRR/LTVをdbtでモデル化 企業単位ヘルススコア日次 初期 500〜1,500万円+月20〜60万円/3〜6か月で最初の運用
SaaSプロダクトデータ基盤の3アプローチ。LTV/チャーンを経営指標として一元管理したいなら、モダンデータスタック(③)に段階的に寄せていくのが総額を抑えやすい アプローチ1: プロダクトアナリティクスSaaSに寄せる Amplitude・Mixpanel・PostHog・Heapなどのプロダクトアナリティクスに集約し、Stripe・Salesforce・IntercomからのデータをそれぞれのIntegrationで流し込む方法です。イベント計測とダッシュボードとファネル分析がひとつのUIで完結し、非エンジニアでも触りやすいのが強みです。
月額 :10〜50万円(イベント量・MTU課金)導入期間 :2〜6週間向いているケース :ARR3〜10億円、プロダクト1〜2本、プランが数本、PMとマーケが主な利用者、SQLを書く文化がまだ薄い弱点は、チャーンとLTVを課金・契約と結んだ深い分析、およびカスタムなセマンティックレイヤーの構築に届かない ことです。ダッシュボードのカスタマイズや、他の業務システム(会計・人事・自社DB)とのクロス分析にも限界があります。エンタープライズ契約が増えるとイベント量課金が跳ね上がりコスト効率も悪化し始めます。プロダクトチーム内で完結する行動分析としては優れていますが、経営指標の統合基盤にするには物足りないケースが多いのが実情です。
アプローチ2: GA4のBigQueryエクスポート+Looker Studioで自作 GA4のイベントをBigQueryに無料でエクスポートし、Stripe・Salesforce・IntercomからのデータをFivetran/troccoなどのSaaSコネクタでBigQueryに集約、Looker Studio や Metabaseで可視化する方法です。GA4のBigQueryエクスポートは無料で始められ、BigQueryの無料枠内で運用できる規模も多いのがメリットです。設定の実務はGA4のデータをBigQueryにエクスポート・活用する方法 にまとめています。
初期費用 :100万〜300万円(データ連携設計とダッシュボード実装を外注する場合)月額 :BigQuery利用料 数千〜数万円+SaaSコネクタ月3万〜10万円+BI無料〜数万円導入期間 :4〜8週間向いているケース :ARR5〜30億円、プロダクトのイベント設計がある程度整っている、社内にSQLが書ける担当者が1人以上いる、GA4を既に導入している弱点は、GA4のイベントスキーマがネストしていて扱いにくい ことと、プロダクト内の細かい行動計測がGA4向けに設計されていない場合、既存の計測を大幅に見直す必要がある ことです。またGA4のUIとBigQueryの集計は完全には一致しないため、両方を見ているうちに数字がブレる問題も出ます。とはいえ、初期費用を抑えつつ将来のモダンデータスタック移行にも寄せていける「橋渡し」のアプローチとして現実的です。
アプローチ3: モダンデータスタックで本格構築(Segment/Snowplow → Snowflake/BigQuery → dbt → BI) Segment・Snowplow・RudderStackなどのCDP/イベント収集ツールでプロダクト行動を集めて、Stripe・Salesforce・Intercomなどからは Fivetran/Airbyte/trocco で連携し、Snowflake・BigQuery・Databricks などのクラウドDWHに集約、dbtでMRR/ARR/LTV/チャーンなどのビジネス指標をモデリング、Looker/Tableau/Preset/Metabase で可視化する構成です。もっとも柔軟で、あらゆるビジネス質問に答えられます。全体像はモダンデータスタックとは?構成要素と2026年の主要ツール を参照してください。
初期費用 :500万〜1,500万円(統合対象システム数と指標定義の複雑度で変動)月額 :Segment等の月10〜30万円+SaaSコネクタ月5〜15万円+クラウドDWH 数万〜十数万円+dbt Cloud/BI 数万〜十数万円導入期間 :3〜4か月で最初の運用、フル機能で6〜9か月向いているケース :ARR10億円以上、複数プロダクト・複数プラン、エンタープライズ契約あり、経営会議で使う指標を統合したい、将来的にAI/レコメンド/機械学習まで見据えたい費用は3アプローチで最も高く見えますが、ARR30億円を超えるSaaSでは、チャーンを0.5ポイント下げるだけでLTVが1.5倍以上になり事業評価額に直結するため、1〜2年での回収が現実的 です。データ基盤構築の見積もりの内訳はデータ基盤構築の費用相場は?見積もりの内訳と判断基準を解説 でくわしく整理しています。
3つのアプローチの選び方は、LTV/チャーン/NRRを経営指標として一元管理したいか、そして複数プロダクト・エンタープライズ契約まで見据えるか で決まります。プロダクト内の行動分析だけで足りるならアプローチ1、GA4を軸に安く始めたいならアプローチ2、経営指標を統合したいならアプローチ3、というのが判断の骨格です。
費用対効果:チャーン0.5pt改善とLTV可視化の投資回収 「初期500万〜1,500万円」と聞くと大きく感じますが、SaaS事業が抱えているチャーンとLTVの見えないコストと比べると、判断は変わります。
チャーン0.5ポイント改善 が、SaaSのデータ基盤化で最も分かりやすい効果です。月次チャーン3%のSaaSは、平均継続月数がおよそ33か月です。これを月次チャーン2.5%に下げると平均継続月数は40か月に伸び、LTVは1.2倍になります。月次1%を0.5%まで下げれば、平均継続月数は100か月から200か月へと2倍になります。チャーン率の絶対値が小さいほど、0.5ポイントの改善インパクトは倍々で効いてくる 構造です。
ARR10億円のSaaSで、この改善が1年〜2年で実現すれば、事業評価額(ARRの5〜10倍のマルチプル)で数十億円のインパクト になります。500万〜1,500万円の初期投資に対し、桁が違うリターンが見込めるのがSaaSの特徴です。
LTV/CAC比の可視化による広告投資の最適化 も継続的に効きます。チャネル別・キャンペーン別・プラン別のLTVが可視化されると、CACの高いチャネルへの過剰投資を止め、LTVの高い顧客層への集中投資に切り替える判断が早くなります。マーケ投資が年間5億円のSaaSなら、LTV/CACベースの再配分で年間5,000万〜1億円の効率化 がよく出るレンジです。
エンタープライズ契約のNRR改善 も大きい効果です。1社あたりARRが数千万円のエンタープライズ契約は、1社解約のインパクトがSMB100社ぶんに相当します。企業単位のヘルススコアで解約兆候を先読みし、CSが四半期前にアクションできる運用が回れば、NRRが5〜10ポイント改善 する例が多くあります。
部門横断の集計工数削減 も定量効果として計算できます。経営会議のためにマーケ・営業・CS・PMがそれぞれスプレッドシートで集計する時間、毎月のMRR/ARR/チャーンの数字合わせに使う時間、これを合計すると月あたり50〜100時間、年間で600万〜1,200万円 のコストが集計作業に消えているケースが典型です。
これらを合計すると、ARR10億〜30億円規模のSaaSでAmplitude/Stripe/Salesforce/Intercomの分断で発生している見えないコスト・機会損失は年5,000万〜数億円規模 になります。500万〜1,500万円の初期投資は、この見えないコストに対して1〜2年で回収できるレンジです。
内製と外注のどちらで進めるかは、データ基盤は内製と外注どっち?判断基準とハイブリッドの進め方 で判断軸を整理しています。SaaSの場合、プロダクトエンジニアはいるがデータエンジニアとアナリティクスエンジニアが不足しているケースが多く、モデリング(dbt)とパイプライン設計だけを外部パートナーと組み、運用は内製に寄せるハイブリッドが増えています。
SaaS特有の3つの設計論点 他業種のデータ基盤と比べて、SaaSで特に設計を丁寧にすべきポイントが3つあります。ここを甘く見ると、基盤を作った後に「思ったより使えない」となりがちなので、事前に押さえておいてください。
論点1: イベントスキーマ(トラッキングプラン)を最初に固める プロダクト内のイベント設計を最初にきちんとやらないと、後からダッシュボードで見たい切り口が取れずに計測を追加する、というループが延々続きます。推奨は、イベント名/プロパティ/型/必須項目をトラッキングプラン(Segment Protocols や Amplitude Data、自作のドキュメントでも可)としてコード化し、PRレビューで変更を管理する 運用です。
イベント名は snake_case で統一し、page_viewed feature_used subscription_upgraded のように「対象+動詞(過去形)」で揃えるのがベストプラクティスです。プロパティ(例:plan_name, feature_key, mrr_amount)を必ず付けるルールにすれば、後からいくらでも切り口を増やせます。
論点2: ID解決(Identity Resolution)を設計に組み込む anonymous_id(トライアル前のクッキーID)、user_id(サインアップ後)、account_id(Salesforce上の企業ID)、contract_id(Stripe上の契約ID)、この4つを行き来できる紐づけテーブル(dim_identity_map)をデータ基盤側で持つのが定石 です。
Segment・Snowplow・Amplitude・Mixpanelには「Identify」機能があり、user_idを紐づけるとサインアップ前の匿名イベントも同じユーザーとしてつなげてくれます。これに加えて、user_id ↔ account_id の紐づけを Salesforce の Contact ↔ Account 情報とマッピングし、account_id ↔ contract_id を Stripe の Customer ↔ Subscription からマッピングする。この3段紐づけをdbtでモデル化しておくと、企業単位・契約単位・ユーザー単位のあらゆる分析が同じテーブルから引けます。
論点3: MRR/ARR/LTV/チャーンの定義をセマンティックレイヤーで一元化する 「MRRに何を含めるか」「トライアルは含めるか」「契約解除日はキャンセルクリック日か契約終了日か」「返金は差し引くか」「NRRの分母は前年同月の何を使うか」、これらは部門ごとに解釈がズレるとどんなダッシュボードを作っても数字が合いません。
推奨は、dbt でこれらを metrics/ レイヤー、あるいは Looker の LookML、Cube.js、MetricFlow のようなセマンティックレイヤー で「1回だけ定義」し、以降のダッシュボードは全部その定義から引く設計です。これができると、経営会議のたびに「MRRの定義」を議論するコストが消えます。
3〜6か月のスモールスタート手順 SaaSのプロダクトデータ基盤化は、いきなり全指標・全部門を対象にすると要件が膨らんで頓挫します。最初の運用開始までを3〜6か月 に区切ったスモールスタートで進めるのが、実務では失敗しにくい進め方です。
月1: 現状把握と第1優先の指標を1つに絞る 経営・PM・営業・CS・マーケのキーマンにヒアリングし、いま何を見たいか・見られていないかを棚卸し プロダクト内の計測状況、Stripe/Salesforce/Intercomの利用状況、既存のスプレッドシート運用を確認 第1優先の指標を1つ決める(例:企業別のヘルススコア+チャーン兆候アラート、その他の指標は次フェーズ) ここで欲張らないことが最大のコツ です。最初は「CSMが月曜朝に見る企業別ヘルススコア」を1つ作り切る、と決め打ちします。マーケのアトリビューションや財務のARR基盤は次フェーズに回します。
月2: イベントスキーマとID解決の設計、データ集約 トラッキングプランを整備し、必要なイベント計測を追加(Amplitude/Segment/Snowplowの選定を含む) Stripe・Salesforce・IntercomのデータをFivetran/Airbyte/troccoでBigQuery/Snowflakeに集約するパイプラインを構築 dim_identity_map(anonymous_id ↔ user_id ↔ account_id ↔ contract_id)の設計と実装 この段階でデータの品質チェック(欠損・重複・異常値)まで組み込んでおくと、後戻りが少なくなります。データパイプラインの考え方はデータパイプラインとは?ETLとの違いと仕組みを図解で解説 で整理しています。
月3: 指標モデリングとダッシュボード実装 dbtでMRR/ARR/LTV/チャーン/NRRのモデリング(fact_subscription_events, fact_mrr_movement, dim_customer_health) 企業別ヘルススコア(プロダクト利用×契約金額×サポート履歴の合成スコア)を実装 Looker/Tableau/Metabase/Preset でCSM向けダッシュボードを実装 CS・PM・経営と一緒にリハーサルを行い、既存のスプレッドシートとの数字合わせで検証 このタイミングで、実際の月次経営会議を新旧併走で回します 。既存レポートと基盤の数字が一致することを確認してから、既存運用を段階的に卒業します。
月4〜6: 本番運用開始と機能拡張 本番運用に切り替え、CS・営業・PM・経営にダッシュボードを配布 週次で「見にくい」「この指標を足したい」というフィードバックを集めて改善 チャーン兆候アラートのSlack通知ルールを設計(例:ログイン頻度半減+機能利用消失を検知したら担当CSMに通知) マーケのアトリビューション、財務のARR台帳との整合、経営ダッシュボードを追加 次のフェーズ(LTV予測モデル、生成AIによる問い合わせ要約、レコメンド)の計画に入る ここまでで最初の運用が回り始めます。その後、BigQuery ML / Snowflake Cortex での LTV予測、生成AIによる社内データ活用 、RAGによる社内ドキュメント検索 、と段階的にスコープを広げていくのが、無理のない進め方です。全体スケジュールの目安はデータ基盤構築の期間はどのくらい?規模別・工程別スケジュールの目安 でも工程別に解説しています。
まとめ:SaaSプロダクトデータ基盤化を進めるポイント SaaSのプロダクトデータ基盤について、要点を整理します。
統合が難しいのは、プロダクト行動(Amplitude等)・課金(Stripe等)・営業(Salesforce等)・CS/サポート(Intercom等)の4層が別ツール・別IDに閉じ、LTV/チャーン/NRRを1つの粒度で計算する共通レイヤーがない から。ツール選定を刷新しても本質的には解決しない Amplitude/Mixpanel止まりのサインは、チャーン分析にプロダクト行動を組み込めない・MRR/ARRの定義がズレる・部門ごとに別ダッシュボード・エンタープライズ契約で企業単位ヘルススコアが必要 の4つ。2つ以上当てはまれば検討フェーズ 実現アプローチはプロダクトアナリティクスSaaS/GA4+BigQuery/モダンデータスタック の3つ。LTV/チャーンを経営指標として一元管理したいならモダンデータスタックが現実解 チャーンを月次1%→0.5%に下げるだけでLTVは2倍、事業評価額へのインパクトは数十億円 にもなる。500万〜1,500万円の投資は1〜2年で回収できるレンジ 進め方は3〜6か月のスモールスタート が基本。最初は「CSMが月曜朝に見る企業別ヘルススコア」1つに絞り、マーケアトリビューションや財務ARRは次フェーズに回す SaaS特有の設計論点はイベントスキーマのコード化・ID解決の3段紐づけ・MRR/LTVの定義をセマンティックレイヤーで一元化 の3つ。ここを丁寧にやり切ることが成否を分ける SaaSのプロダクトデータ基盤化で本当に効いてくるのは、月次締めが早くなることよりも、PM・営業・CS・マーケ・経営が同じLTVとチャーンを同時に見て、解約の兆候に翌月ではなく今週のうちに手を打てる状態 を作れることではないでしょうか。1週間単位でヘルスの兆候に対処できれば、NRRとLTVの改善はすぐに現れます。
まずは自社が「先月チャーンした企業の直前1か月のプロダクト行動」を今すぐ出せるかどうかを試してみるところから、検討を始めてみてください。
SaaSプロダクトデータ基盤構築のご相談はEvastへ 株式会社Evastでは、SaaS企業のプロダクトデータ基盤構築とLTV/チャーンの可視化 を、業種特有の論点(イベントスキーマのコード化・ID解決の3段紐づけ・MRR/LTVのセマンティックレイヤー化)を踏まえてご支援しています。BigQuery/Snowflake上でのdbtによるMRR/LTV/チャーンモデリング、Segment/Snowplowでのイベント計測整備、企業単位ヘルススコアの設計から、生成AI/LTV予測モデルまでを、SaaS事業ドメインの理解とセットでご提案します。
「先月チャーンした企業のCSMが、直前3週間のプロダクト行動を見られていない」 「経営会議のたびにMRR/ARR/チャーンの数字が部門ごとにズレて議論になる」 「エンタープライズ契約が売上の30%を超え、企業単位のヘルススコアが必要になった」 現状の集計工数の棚卸しや、プロダクトアナリティクスSaaSで足りるのかモダンデータスタックが必要なのかの判断からでも構いません。3〜6か月のスモールスタートのロードマップまで一緒に描きます。
→ データ基盤構築サービスを見る データマネジメント支援を見る 無料で相談する