リユース業の値付けが構造的に難しい理由
リユース業で値付けが特にデータ化しにくいのは、他業種と比べても「1点あたりに必要な情報の粒度」と「価格が変動する速度」が噛み合わないからです。まず、この構造から見ていきます。
1点あたりの値付け要素
- ブランド相場帯・人気度
- 型番希少性・生産年
- 状態ランク・付属品
- 相場変動日次で上下
- モール価格楽天・メルカリ差
- 在庫日数滞留リスク
×
=
担当者の負荷
月40時間の
相場調べ+値付け
滞留在庫と
安売りが両方発生
図のように、1点のブランド品の適正な買取・販売価格を決めるには、次のデータを突き合わせる必要があります。
- ブランド・型番マスタ:ブランド別の相場帯、モデルごとの人気度、生産年、希少性
- 状態ランクと付属品:Sランク〜Cランクの評価基準、箱・保証書・シリアルの有無
- 過去の買取・販売実績:同ブランド・同型番・同ランクの直近3〜12か月の成約価格
- モール相場:楽天・Yahoo!ショッピング・メルカリ・ヤフオク!の現在売価と落札実績
- 自店の在庫日数:仕入れからの経過日数、値下げ履歴、店舗別回転率
- キャンペーン・季節要因:モールのポイントアップ、年末年始や母の日などのイベント需要
これが1点ぶんです。60店舗で1日数百点の買取が発生すれば、同じ照合を1日数百回、月間数千〜1万回近く繰り返します。ここがリユース特有の「一点物ゆえの積算のつらさ」です。
さらに厄介なのが、次の3点です。
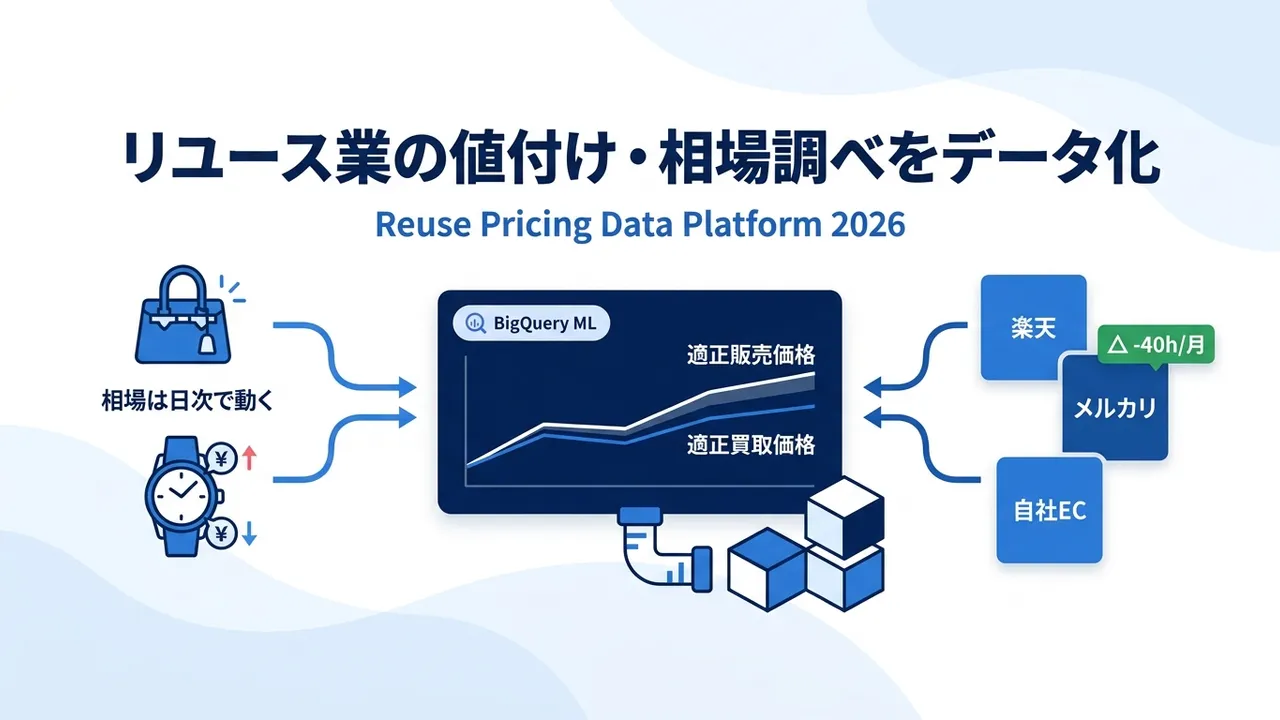
相場が日次〜週次で動くのがリユースの特徴です。ブランド品の中古市場価格は、為替・新品の値上げ・SNSでの流行・モールのキャンペーンで日々上下します。前月の実績値だけを見て値付けすると、今の相場との乖離が広がっていきます。担当者はモールを毎日手で見て回るしかなく、これが月30〜40時間の隠れたコストになります。
一点物なので同じ商品が二度と入らないという制約もあります。POSデータのようなSKU単位の統計モデルが作りにくく、代わりに「ブランド×型番×状態ランク」の特徴量で類似品の成約価格から推定する仕組みが必要です。これはExcelや相場サイトの手動照合では属人化を避けられません。
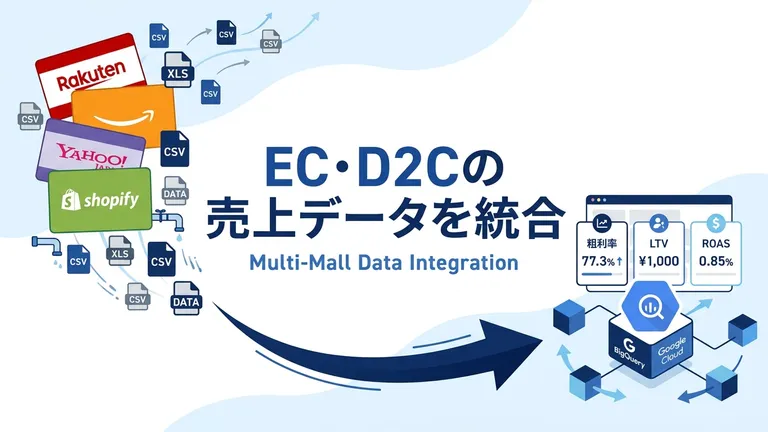
販売チャネルが並列に増えていくのも今のリユース業のリアルです。実店舗・自社EC・楽天・メルカリ・ヤフオク・海外バイヤーと、チャネルごとに売れやすい価格帯と手数料率が違います。どこに出すのが最も利益率が高いかを判断するには、全チャネルの相場と自店在庫を1つのビューで見る必要があります。EC・D2Cで4モール以上を横断集計している事業者向けには、モール別手数料と広告費を控除した粗利算定まで踏み込んだEC・D2Cの売上データを統合する方法|複数モール横断分析も参考になります。
こうした構造があるため、店舗数と扱いブランドが増えるほど属人化が進み、値付けの精度と速度が同時に落ちていきます。データ基盤の全体像そのものを押さえたい方は、データ基盤とは?企業が導入すべき3つの理由と構成要素を解説を先に読んでいただくと、この記事の話がより具体的に感じ取れます。
Excel・手作業の限界を判断する3つのサイン
「うちはまだ担当者の経験で回せている」と言う本部の方は多いのですが、じわじわとひずみが出ているケースがほとんどです。次の3つのサインで、データ化検討の時期を判断できます。
サイン1: 相場調べと値付けに月30時間以上を使っている
これが最もはっきりした判断基準です。買取担当者や本部の相場チームが、モール検索と過去実績の照合だけで月30時間以上使っているなら、人件費換算で月10万〜12万円分の工数が値付け準備に消えています。60店舗規模だと本部+各店長で月100〜150時間、100店舗規模なら月200時間に達するのが実務での実感です。
この工数は、扱いブランドと店舗数が増えるほど比例して増えます。単に「相場を早く見たい」から自動化するのではなく、値付けの精度を担保しながら人時を減らすためにデータ化するのだと考えるほうが、投資判断がぶれません。
サイン2: 店舗ごとに買取・販売価格の判断がバラついている
同じブランド・同じ型番・同じランクなのに、A店では8万円で買い取り、B店では6万円で買い取っている。販売価格も同様に、C店では12万円で売り出し、D店では9万円で売り出している。こういうバラつきに本部が気づけない、あるいは気づいても是正できない状態は、経験頼み値付けの典型的な症状です。
原因は、店舗ごとの買取・販売実績が本部で横断的に見えず、担当者ごとに参照している相場ソースがバラバラだからです。値付けが揃わないと、SNSで「あの店は買取が安い」と拡散され、集客にも影響します。
サイン3: 滞留在庫と安売り(値下げ処分)が同時に起きている
売れ筋の商品は入荷即完売するのに、他の商品は3か月・6か月と在庫棚に残り続け、最終的にモールで大幅値下げして処分している。これに本部が翌月まで気づけない、というのはリユース業の典型的な症状です。
原因は、店舗POSの在庫と本部の販売実績、モールごとの売れ行きがリアルタイムに繋がっておらず、値下げの意思決定が「担当者の記憶」に頼っているためです。滞留在庫による資金の寝かせと値下げロスは、実は同じデータ問題の裏表です。
3つのうち2つ以上に当てはまれば、値付けのデータ化を検討するフェーズに入っています。逆に、店舗数が5店以下で担当者が固定されているうちは、Excel+相場サイトの目視でしばらく戦えます。業種横断でのExcel限界サインと表計算の構造的な限界については、Excel集計が限界になったら|スプレッドシートからデータ基盤への移行にまとめています。
値付けデータ化の3つのアプローチと費用相場
「データ化」といっても、実現手段はいくつかあります。リユース業でよく検討されるのは、次の3つです。それぞれ費用感と柔軟性がまったく違います。
① POS/在庫SaaS+相場ツール既製サービスの組み合わせ
- ブランド相場APIを個別購入
- POSの在庫と紐付けは手動
- 複数モール横断は制約
初期 30〜100万円
+月5〜20万円/導入2〜6週間
→
② スプレッドシート+モールAPI連携Looker Studio・Tableau
- モールAPIから相場を自動収集
- BIで店舗横断の可視化
- 個品数の増加で行数上限に
初期 150〜500万円
+月数万円/4〜10週間
→
③ 本部データ基盤+価格予測BigQuery ML / Redshift ML
- 買取・販売・モールを1基盤に統合
- MLで買取/販売の適正価格を算出
- 滞留在庫の値下げ提案まで拡張
初期 500〜1,500万円
+クラウド利用料/4〜8週間で最初の運用
アプローチ1: POS/在庫SaaS+既製の相場ツール
リユース業向けのPOS・在庫SaaS(KOMEHYO Systems、ユーワークス、リユース系業務パッケージなど)に、ブランド相場APIや相場サイトの有料プランを組み合わせる方法です。既存の店頭業務にすぐ組み込めるのが強みです。
- 初期費用:30万〜100万円
- 月額:月5万〜20万円(店舗数課金+相場ツール月額)
- 導入期間:2〜6週間
- 向いているケース:店舗数が数店〜10店程度、扱いブランドが固定されている、まずは相場調査の時短を優先したい
弱点は、POSの在庫データと相場ツールの結び付けは基本的に人手であること、そして複数モール横断の販売最適化までは対応できないことです。「相場を早く見る」までは実現できても、「どのチャネルで売るのが最も利益率が高いか」の判断はSaaSの外にあります。
アプローチ2: スプレッドシート+モールAPI連携+BIツール
楽天・Yahoo!ショッピング・メルカリのAPIから相場と自店販売データを日次で収集し、Google DriveやスプレッドシートにまとめてLooker StudioやTableauで可視化する方法です。BIツール単体の月額は数千円〜と安く、既存のExcel運用に近い形で始められます。
- 初期費用:150万〜500万円(API連携作りとダッシュボード設計を外注する場合)
- 月額:BI月額数千円〜数万円+データ連携ツール(trocco・Fivetran等)月3万〜10万円
- 導入期間:4〜10週間
- 向いているケース:店舗数が10〜30店、社内にスプレッドシートやSQLが分かる担当者がいる、まずは相場と在庫を一元表示したい
弱点は、扱い個品数が数万点を超えるとGoogle Sheets/Excelの行数上限に到達すること、そしてスプレッドシートの管理が属人化しやすいことです。中〜大規模のリユースチェーンでは、早晩このアプローチの限界に当たります。BI選定はPower BI・Tableau・Looker比較|5軸の違いと選び方【2026年版】にまとめています。
アプローチ3: 本部データ基盤の構築+価格予測モデル
各店の買取・販売・在庫データ、モールの相場と受注、査定システム、会員データを、本部のクラウドDWH(BigQuery・Redshift・Snowflake)に自動集約し、dbtで統合モデルに変換し、BigQuery ML/Redshift MLで買取・販売の適正価格を予測する方法です。もっとも柔軟で、将来の在庫最適化・チャネル別配分・与信までカバーできます。
- 初期費用:500万〜1,500万円(店舗数と扱いブランド範囲、モール数で変動)
- 月額:クラウド利用料 数万〜十数万円+運用保守 年額で初期費の10〜20%
- 導入期間:4〜8週間で最初の運用、フル機能で3〜6か月
- 向いているケース:店舗数が数十〜数百、複数モールでの販売を最適化したい、価格予測や滞留在庫アラートを本格運用したい
費用は3アプローチで最も高く見えますが、60店規模を超えるリユースチェーンでは、手集計の人件費削減と滞留在庫の値下げロス削減で1〜2年で投資回収するのが実務での目安です。データ基盤構築の見積もりの内訳はデータ基盤構築の費用相場は?見積もりの内訳と判断基準を解説でくわしく整理しています。
3つのアプローチの選び方は、将来AIによる価格予測や在庫最適化、複数モールの販売配分まで踏み込む予定があるかどうかで決めるのが後悔の少ない判断です。当面の相場調べを楽にしたいだけならアプローチ1で十分。将来のデータ活用まで見据えるなら、最初からアプローチ3を選んだほうが総額を抑えられます。
費用対効果:月40時間削減と滞留在庫の値下げロス圧縮
「初期500万円」と聞くと大きく感じますが、値付けの属人化と滞留在庫で払っている見えないコストと比べると、判断は変わります。
本部と各店の買取担当者が、合計で月100時間を相場調べと値付けに使っているとします。人件費を時給換算で3,000〜4,000円とすると、月30万〜40万円相当の工数が値付け準備だけに消えている計算です。年間にすると360万〜480万円。3年で1,000万〜1,400万円になります。
さらに、滞留在庫の値下げロスも見逃せません。60店規模のブランドリユースだと、月間の粗利のうち3〜5%が滞留在庫の値下げ処分で消えていることが多く、月商1億円のチェーンなら月30万〜50万円、年間で360万〜600万円の値下げロスが発生している計算になります。
これらを合計すると、60店規模のリユースチェーンで値付け属人化と滞留在庫で年800万〜1,200万円の見えないコストが発生している計算になります。500万〜1,500万円の初期投資は、この見えないコストに対して1〜2年で回収できるレンジです。
加えて、値付けのデータ化には人件費削減以外の効果もあります。
- 買取粗利率の改善:適正な相場に連動した推奨買取価格を出せるため、高すぎる買取(粗利圧迫)と安すぎる買取(機会損失)の両方を減らせる。粗利率で2〜3ポイント改善するケースが多い
- 販売チャネル最適化:楽天・メルカリ・自社ECの手数料と回転速度を加味し、商品ごとに最適なチャネルへ配分できる。同じ商品の売上を10〜15%押し上げるケースもある
- 買取現場の判断速度:相場と過去実績の突き合わせが1点あたり10分から30秒に短縮され、接客時間そのものが増える
これらは営業利益率で2〜4ポイント改善するインパクトがあり、初期投資の回収期間をさらに短縮します。属人化していた買取判断が組織のノウハウとして蓄積される、という副次効果も見逃せません。
内製と外注のどちらで進めるかは、データ基盤は内製と外注どっち?判断基準とハイブリッドの進め方で判断軸を整理しています。リユース業の場合、データエンジニアの採用が難しく、買取査定や商品ドメインの知識を持つ外部パートナーと組んで立ち上げる企業がほとんどです。
事例:ブランドリユースF社の60店統合と月40時間削減
具体的なイメージを持てるように、Evastが実際に構築した事例を紹介します。
約60店舗を展開するブランドリユースF社では、各店が買取と販売のデータをExcelにまとめて本部に送り、担当者は毎日モール相場を手で調べて値付けの参考にする運用が続いていました。楽天・メルカリ・ヤフオクはそれぞれの管理画面で別運用、査定システムと在庫台帳も別管理で、店舗横断の値付け基準を統一できない状態でした。
Evastが構築したのは、Google Cloud上の本部データ基盤です。おおまかな構成は次のとおりです。
- 各店の買取・販売Excelは日次でCloud Storageに自動アップロード、Cloud FunctionsがBigQueryへロード
- 自社EC(Shopify)はFivetranで、楽天・Yahoo・メルカリはモールAPIをCloud Functionsで取得(Cloud Schedulerで定期実行)
- dbtでブランド・型番・状態ランクを横断して比較できるデータモデルに変換、Elementaryで欠損や異常を継続的にチェック
- BigQuery MLで、ブランド・型番ごとの適正な買取価格・販売価格と、値下げのタイミングを予測
- 全体のオーケストレーションはCloud Composer(Airflow)、構成はTerraform、dbtはGitHub Actionsで管理
- Looker Studioで本部と店舗が同じ数字を見られるダッシュボードを提供、予測価格は各店POSとECに推奨値として戻す
- 相場の急変や滞留在庫はSlackに自動通知
構築期間は約4か月、使ったスタックはBigQuery・BigQuery ML・dbt・Fivetran・Cloud Functions・Cloud Storage・Cloud Composer・Looker Studio・Dataplex・Terraform・GitHub Actionsが中心です。
成果としては、担当者が毎日手で行っていた相場調べと集計はほぼなくなり、値付けにかけていた月40時間ほどの作業がほぼゼロになりました。買取価格も販売価格も、相場に連動した推奨値をその場で確認できます。
さらに適正な価格と値下げのタイミングを出せるようになった結果、滞留在庫が減り、在庫回転率は約15%改善しました。店舗とECの在庫を横断で見て、売れやすいチャネルへ回せるようにもなっています。
くわしい構成図と工程はブランド品の相場をデータ化し、値付け作業を月40時間削減(ブランドリユースF社の事例)にまとめています。データパイプラインの考え方そのものはデータパイプラインとは?ETLとの違いと仕組みを図解で解説、BigQueryの課金設計はBigQueryのコスト最適化、dbtの役割はdbtとは?BigQueryのデータ変換を効率化するツールを解説で整理しています。
4〜8週間のスモールスタート手順
リユース業の値付けデータ化は、いきなり全店・全モール・全ブランドを対象にすると要件が膨らんで頓挫します。最初の運用開始までを4〜8週間に区切ったスモールスタートで進めるのが、実務では失敗しにくい進め方です。
週1: 現状把握とスコープ確定
- 本部の相場担当・店長・買取責任者にヒアリングし、いま何にどれくらい時間を使っているかを棚卸し
- 現行POS・在庫台帳・査定システム・モール管理画面のデータの出方(Excel/CSV/API)を確認
- 最初の対象範囲を決める(例:主要3ブランドの直営30店の買取・販売だけ、モール連携は次フェーズ)
ここで欲張らないことが最大のコツです。最初は「主力ブランドの買取推奨価格を出す」1つに絞り、扱いブランド全体や全モール統合は後のフェーズに回します。
週2〜3: データ取得と本部DWHへの集約
- 各店の買取・販売Excelをスプレッドシート経由でBigQueryやRedshiftに投入するパイプラインを構築
- モールAPI接続を作り、Cloud FunctionsやLambdaで日次取得
- dbtでブランド・型番・状態ランクの粒度を統一したデータモデルを作る
この段階でデータの品質チェック(欠損・重複・異常値)まで組み込んでおくと、後戻りが少なくなります。
週4〜6: ダッシュボード実装と価格予測の初期版
- Looker Studioで本部・店長・買取担当の3種類のダッシュボードを実装
- BigQuery MLで主力ブランドの買取価格・販売価格を予測する初期モデルを構築
- 本部の相場担当と一緒にリハーサルを行い、担当者の手動値付けと予測値の突き合わせで検証
このタイミングで、実際の日次値付けを新旧併走で回します。予測値と担当者判断の乖離が大きい商品だけ人が最終確認する、という運用フローを設計します。
週7〜8: 本番運用開始と改善サイクル
- 本番運用に切り替え、店舗ダッシュボードと推奨価格をPOSに配布
- 週次で「相場が急変したブランド」「予測が外れた個品」のフィードバックを集めて改善
- 滞留在庫アラート、複数モールの販売配分最適化など、次のフェーズの計画に入る
ここまでで最初の運用が回り始めます。その後、BigQuery MLでの予測精度改善、扱いブランドの拡張、EC・会員データの統合と、段階的にスコープを広げていくのが、無理のない進め方です。全体スケジュールの目安はデータ基盤構築の期間はどのくらい?規模別・工程別スケジュールの目安でも工程別に解説しています。
まとめ:リユース業の値付けデータ化を進めるポイント
リユース業の値付けと相場調査のデータ化について、要点を整理します。
- 値付けがデータ化しにくいのは、一点物×日次で動く相場×複数モール横断で、1点あたりに必要な情報の粒度と価格変動の速度が桁違いに高いから。相場ツール1つを買っても本質的には解決しない
- Excel・手作業限界のサインは、相場調べに月30時間以上・店舗ごとの値付けバラつき・滞留在庫と安売りの同時発生の3つ。2つ以上当てはまれば検討フェーズ
- 実現アプローチはPOS/在庫SaaS+相場ツール/モールAPI連携+BI/本部データ基盤+価格予測の3つ。将来のAI活用やチャネル別配分最適化を見据えるなら、最初から本部データ基盤(BigQuery ML/Redshift ML)を選ぶほうが総額を抑えやすい
- 60店規模のリユースチェーンでは、値付け属人化と滞留在庫で年800万〜1,200万円の見えないコストが発生している。500万〜1,500万円の投資は1〜2年で回収できるレンジ
- 進め方は4〜8週間のスモールスタートが基本。最初は「主力ブランドの買取推奨価格」1つに絞り、モール統合や全ブランド展開は次フェーズに回す
リユース業の値付けデータ化で本当に効いてくるのは、時間が浮くことよりも、本部・店長・買取担当者が同じ相場データと在庫状況を同時に見て、日次で動く価格に翌週ではなくその場で追従できる状態を作れることではないでしょうか。日単位で買取粗利と滞留在庫を改善できれば、営業利益率の改善はすぐに現れます。
まずは自社が値付け準備にどれくらいの時間を使っていて、滞留在庫の値下げロスが月にどれくらい発生しているかを棚卸ししてみるところから、検討を始めてみてください。
リユース業の値付け・相場データ化のご相談はEvastへ
株式会社Evastでは、リユース業の買取・販売データ統合と、BigQuery MLを使った価格予測基盤の構築を、実際の事例をベースにご支援しています。ブランドリユースF社では約4か月で約60店舗の買取・販売データをGoogle Cloudで統合し、担当者の相場調べを月40時間削減、BigQuery MLの価格予測で在庫回転率を約15%改善しました。
- 「60店舗の相場調べと値付けに月100時間以上かかっていて、店舗運営に手が回らない」
- 「店舗ごとに買取・販売価格の判断がバラついていて、粗利率が読めない」
- 「将来、複数モールの販売配分や滞留在庫の自動アラートまで進めたい」
現状の値付け工数の棚卸しや、既製のPOS・相場ツールで足りるのか本部データ基盤が必要なのかの判断からでも構いません。スモールスタートのロードマップまで一緒に描きます。
→ ブランドリユースF社の事例を見る → データ基盤構築サービスを見る → 無料で相談する