金融機関のデータ基盤が構造的に難しい理由
金融業でデータ活用が特に大変なのは、他業種と比べても「システムの層の深さ」と「統制の重さ」の両方が桁違いだからです。まず、この構造から見ていきます。
金融機関のデータは大きく3つの層に分かれます。
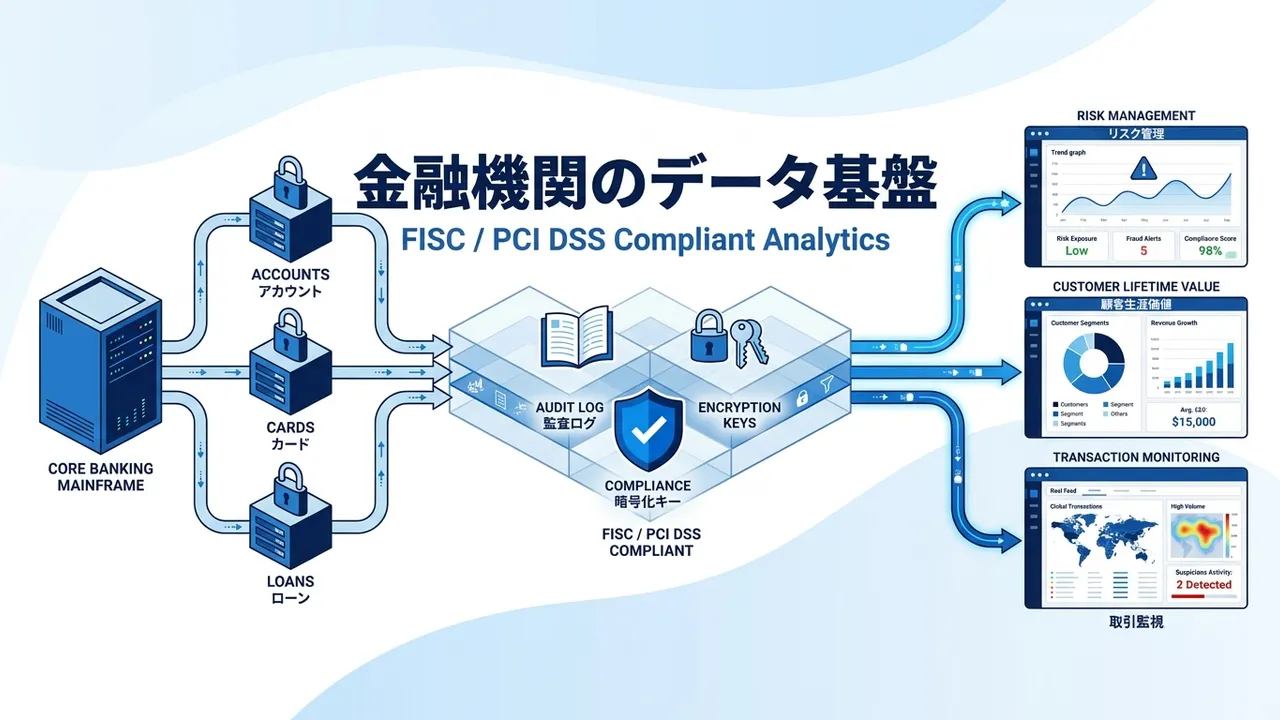
勘定系 は業務の背骨です。銀行なら元帳・預金・融資・為替、証券なら注文・約定・保管、カード会社なら会員・オーソリ・売上請求。数十年前に構築されたメインフレーム+COBOL資産をいまも中核に据えているケースが多く、可用性・整合性の要件が桁違いに厳しいレイヤーです。「1秒止まると新聞に載る」世界なので、分析用途で直接クエリを叩くことは実質許されません。
情報系 は勘定系のデータを分析目的に複製した層です。多くの金融機関で1990〜2000年代に導入されたTeradataやOracle Exadataによる情報系DWHが現役で、部門別のデータマート(法人融資、リテール、資産運用、コールセンター)が並列に並んでいます。ここは触れますが、TB〜PB規模のデータと20年ぶんのSQL資産があり、クラウド移行のハードルが高い層です。
チャネル系 は顧客接点の現場です。インターネットバンキング、モバイルアプリ、ATM、店頭タブレット、コールセンター、Webサイト、SNS。それぞれ別ベンダーが開発しており、ログのフォーマットも保存期間も統制レベルも揃っていません。近年はここに生成AIチャットボットや資産運用アプリが加わり、さらに層が増えています。
この3層のデータを、経営企画が「今月、40代の預金1,000万円以上の顧客層で、ネットバンキング利用率と投資信託の残高推移はどう動いていて、どの顧客が解約予兆で、どのチャネルからのアプローチが有効か」と1画面で見たい、というのが本来のあるべき姿です。しかし勘定系・情報系・チャネル系が別世界で、しかも情報系DWHの改修に半年、勘定系連携の変更に1年、というスピード感の違いがあるため、この一発の問いに答えるのに月単位の時間がかかるのが実態です。
さらに厄介なのが、次の3点です。
規制が層状にかかるのが金融業の最大の特徴です。FISC安全対策基準、PCI DSS v4.0.1(カード情報を扱う場合)、金融庁「金融分野におけるサイバーセキュリティに関するガイドライン」、業態別の総合的な監督指針(銀行・保険・証券それぞれ)、改正個人情報保護法、マイナンバー法、犯収法(マネロン対策)、G-SIBs指定行なら国際的な資本規制と、10前後の統制文書を並行して満たす必要があります。要件の重複と齟齬を整理せずに設計を始めると、内部監査・金融庁検査で必ず引っかかります。
顧客IDの一意性が長期にわたって揺らぐのが金融の内部構造です。数十年前に開設された口座、複数支店をまたぐ名寄せ、旧姓や住所変更の履歴、法人の合併・分割、CIFコードとお客様番号と会員番号の分離。営業店・投信・カード・保険窓販といった複数商品にまたがる名寄せができていないと、真の顧客生涯価値も、実効的なマネロン監視も出せません。データ基盤に取り込む段階で、時点管理の設計(バイテンポラルデータや履歴テーブル)と、名寄せの信頼度スコアを初手で入れないと後で高くつきます。
監査証跡と説明可能性が事後の検査で問われるのが3点目です。金融庁検査・日銀考査・会計監査・内部監査、それぞれで「このデータは誰がいつ何の目的で参照したか」「このモデルの判断根拠は何か」を後から出せる必要があります。データ基盤の各テーブルに対するアクセスログ、リネージ、モデル学習に使ったデータのバージョン、これらが2〜3年遡って追える設計になっていないと、検査対応で疲弊します。ITとしての技術要件の前に、証跡設計が入り口の課題です。
押さえるべき規制と統制文書(2026年時点)
金融データ基盤の設計で拠り所になる主要文書は、2026年時点で次の5つです。いずれもここ2〜3年で大きく動いており、数年前の常識のまま設計を進めると監査で引っかかります。
FISC安全対策基準・解説書
金融情報システムセンター(FISC)が公表する、金融機関のシステム安全対策の実務基準です。クラウド利用時の統制やゼロトラストの考え方、生成AIの安全対策、耐量子計算機暗号(PQC)への移行、といった論点が近年の改訂で段階的に整理されてきました。法令ではありませんが、金融庁の監督指針・検査マニュアルが実質的に参照するため、金融機関はほぼ全社が準拠を前提に設計しています。
AWSは「金融サービス向けリファレンスアーキテクチャ」、Google Cloudは「日本の金融機関向けクラウドサービス利用リファレンス」、Microsoft Azureは「日本の金融機関向けアーキテクチャガイド」を、いずれも公表・更新しています。クラウド利用そのものが論点になるフェーズはすでに過ぎており、いまは「どのクラウドをどのスコープで」の議論に移っています。
PCI DSS v4.0.1(2025年1月以降が唯一の有効版)
カード会員番号(PAN)を保管・処理・伝送するすべての事業者に適用される国際基準です。旧v4.0は2024年12月31日で廃止され、2025年1月以降はv4.0.1が唯一の有効版になりました。さらに2025年4月からは、v4.0で「ベストプラクティス」として猶予されていた要件が完全に義務化されています(出典: PCI SSC)。
データ基盤の設計で重要なのは、PCI DSSの適用範囲(スコープ)をどう絞るかです。PANやトラック情報を直接DWHに載せると、DWH全体がPCI DSSのスコープに入り、監査コストと運用制約が桁で増えます。定石は、決済ゲートウェイ側でトークン化した文字列(原本と1対1で復元可能な代替値)だけをDWHに取り込み、原本のPANはカード会社と決済代行事業者側に留める設計です。この境界設計を最初に決めておかないと、後からPCI DSS対応で全面改修が発生します。
金融庁「金融分野におけるサイバーセキュリティに関するガイドライン」
金融庁のサイバーセキュリティ関連文書は、2024年に大幅改定され、経営陣の関与、サードパーティリスク管理、インシデント対応、脅威ベースのペネトレーションテスト(TLPT)の適用範囲拡大が強化されました。「情シスに任せてある」で通らなくなった、というのが現場感覚に近い変化です。
その後の証券監督指針の改正でも、多要素認証(MFA)の必須化など個別領域の要件が積み上げられています。データ基盤の管理者権限は当然として、BIツールへのログインまで含めて多要素化する前提で設計しておくのが安全です。
業態別の総合的な監督指針
銀行、証券、保険、信用金庫・信用組合、資金移動業、暗号資産交換業、それぞれに金融庁の総合的な監督指針があり、システムリスク管理・外部委託先管理・情報セキュリティ管理の章がデータ基盤設計に効いてきます。直近ではクラウド活用時のリスク評価と経営陣関与の水準が段階的に上がっており、リファレンス条項を追いかけ続ける運用が前提になります。
改正個人情報保護法・マイナンバー法・犯収法
改正個人情報保護法は2022年4月施行以降も継続的に議論が続き、要配慮個人情報の範囲、仮名加工情報・匿名加工情報の運用ルールが整理されてきました。金融機関では、口座残高・借入残高・資産運用状況といった機微な財務情報の扱いと、マイナンバーの厳格な区分管理が重なります。犯収法(犯罪収益移転防止法)の改正で、疑わしい取引の届出(STR)の高度化も継続的な課題です。
これらを全部満たそうとすると設計が固まらないので、実務では 3段階のデータ区分を最初に決めます。「絶対に触れない領域(勘定系原本・PAN原本・マイナンバー原本)」「制限付きで扱う領域(要配慮個人情報・取引履歴)」「自由に扱える領域(集計値・仮名加工情報)」の3階層に分けておくと、以降の設計・監査対応の議論が噛み合います。
金融データ基盤の全体構成(分析系とオペレーショナル系の分離)
金融データ基盤の全体像を描くと、大きく2つの系統が並走します。この2系統を混ぜないのが、金融特有の設計原則です。
分析系データ基盤 は経営企画・マーケティング・リスク管理・監査が使う層です。勘定系・情報系・チャネル系から日次バッチまたはCDCでデータを複製し、クラウドDWH(Snowflake、BigQuery、Redshift、Databricks)に集約します。用途は経営ダッシュボード、顧客分析、解約予兆、リスク計量、マネロン取引監視の分析部分、規制報告の集計です。SLAは日次〜時間単位、可用性は99.9%程度で足りることが多いです。
オペレーショナル系データ基盤 は営業店・コールセンター・アプリが実運用で使う層です。顧客の360度ビュー、リアルタイムの取引監視、次善の推奨商品(NBA/NBO)、生体認証と連携した本人確認。SLAは秒単位、可用性は99.99%以上、勘定系との整合が問われます。分析系とは別の物理基盤で、しばしばNoSQLやリアルタイム処理基盤(Kafka、Flink、Redis)を組み合わせます。
この2系統を「1つの基盤で兼ねよう」とすると、分析用のクエリで営業店の応答が詰まったり、リアルタイム更新の負荷でバッチが崩れたりします。初期構築では分析系だけを対象にし、オペレーショナル系は段階的に別基盤で立てるのが現実的です。地銀・第二地銀の多くは、まず分析系を3年で立ち上げ、その後にオペレーショナル系を5年計画で組む、という順序で進めています。
クラウドDWHの選定は、ワークロードと既存資産で分かれます。Teradataからの移行を優先するなら、SQL互換性でSnowflakeが有力です。マーケティング系・広告連携・Google Workspace中心ならBigQueryが素直で、生成AI連携まで含めてSnowflakeを選ぶケースも増えています。機械学習と非構造化データを主軸に据えるならDatabricks Lakehouseが有利です。詳しくはSnowflakeとBigQueryはどう違う?費用・運用・向いている業種を比較とDatabricksとSnowflakeの違いを実務目線で比較|選び方の判断軸を参照してください。
3つの実現アプローチと費用相場
金融データ基盤の実現手段は、規模と統合スコープで大きく3つに分かれます。それぞれ費用感と規制対応の重さがまったく違います。
| アプローチ | 初期費用 | 月額 | 期間 | 主対象 |
|---|
| ① 単一部門・単一システム | 300万〜800万円 | 20万〜50万円 | 3〜6か月 | 信金・第二地銀・中堅証券の1歩目 |
| ② 部門横断の分析基盤 | 1,500万〜5,000万円 | 80万〜300万円 | 6〜12か月 | 地銀・中堅証券・カード会社 |
| ③ 全社統合(勘定系連携含む) | 5,000万〜3億円 | 300万〜2,000万円 | 1.5〜3年 | 大手金融・G-SIBs・広域連携 |
アプローチ1: 単一部門・単一システムのCSV連携型
1つの部門(例: リテール営業本部)と1つの情報系DBの範囲で、CSV/APIエクスポート→クラウドDWH→BIの最小構成を組む方法です。勘定系には触れず、既存の情報系DBから抽出した集計済みデータのみを扱います。
- 向いているケース: 顧客分析・支店別収益の可視化から始めたい、要配慮個人情報・PAN・マイナンバーを基盤に載せない設計にできる、内部監査・情シス統括の合意が取りやすい範囲に絞れる
このスコープなら、FISC対応クラウドの上で標準的な統制(アクセス制御・監査ログ・暗号化)を組めば通ります。PCI DSS適用外・要配慮個人情報の直接保持なしという境界を明示することで、監査コストが桁で下がります。第二地銀・信金・中堅証券の第一歩として現実的です。
アプローチ2: 部門横断の分析基盤(情報系集約)
複数の情報系DB(法人融資、リテール、資産運用、コールセンター)を1つのクラウドDWHに集約し、部門横断の分析ができる基盤を組む方法です。勘定系にはまだ触れず、情報系の日次バッチ出力を主要ソースにします。
- 向いているケース: 名寄せ済みの顧客IDで法人・リテール・投信・カードを横断分析したい、マネロン取引監視の高度化や解約予兆モデルを組みたい、地銀・中堅証券・カード会社の中規模基盤として3〜5年運用したい
この規模になると、TROCCOやFivetran、Informaticaといったデータ連携ツールと、dbtによるデータ変換の標準化がほぼ必須になります。統制面では、FISC安全対策基準への準拠、PCI DSS適用範囲の切り分け(カード情報を扱う場合)、監督指針の外部委託先管理を、要件定義の段階で内部監査と刷り合わせておく必要があります。
アプローチ3: 勘定系連携・オペレーショナル系まで含む全社基盤
勘定系から情報系、チャネル系、外部データ(信用情報、統計、市場データ)まで、全社のデータを1つの基盤に集約し、分析系とオペレーショナル系の両方を運用する構成です。地銀の広域連携基盤や、大手証券・大手カード会社の統合基盤がこの規模になります。
- 向いているケース: 大手金融・G-SIBs指定行・広域連携基盤、リアルタイムのマネロン監視・生体認証連携・次善の推奨まで含める、5〜10年計画でメインフレームからの脱却を進める
この規模では、CDCツール(Oracle GoldenGate、IBM InfoSphere CDC、Qlik Replicate)、リアルタイム処理基盤(Kafka、Flink)、機械学習プラットフォーム、規制報告自動化まで含めた総合設計が必要です。ベンダー選定・要件定義だけで6〜12か月、PoCで6か月、本番展開で1〜2年という時間軸を覚悟する必要があります。
自社が本当にアプローチ3を必要としているかは、データ基盤のROIをどう試算する?費用対効果の計算方法と稟議で通る書き方【2026年版】で試算のフレームを紹介しているので、稟議に持ち込む前に確認しておくと安全です。
進め方の6ステップ
金融データ基盤を失敗させない進め方は、次の6ステップに分けて設計します。順序を飛ばすと、後段で必ずやり直しになります。
ステップ1: 統制スコープの合意(1〜2か月) 情シス統括、内部監査、コンプライアンス、リスク管理、対象業務部門の5者で、扱うデータの種別(PAN・要配慮個人情報・マイナンバー・仮名加工情報)と、適用する統制文書(FISC・PCI DSS・監督指針)の範囲を文書化します。ここで曖昧にすると、後段の設計・監査対応が破綻します。
ステップ2: ユースケースの絞り込みと投資回収仮説(1か月) 1〜2つのユースケースに絞り、投資回収仮説を数値で立てます。地銀なら「法人融資の与信判断リードタイムを2週間から3日に短縮する」「解約予兆モデルで解約率を1ポイント改善する」、カード会社なら「マネロン取引監視の誤検知を50%削減する」など、金額換算できる指標を選びます。
ステップ3: PoC(3〜4か月) 小規模データ・限定ユースケースでの技術検証を行います。クラウドDWHの選定、データ連携ツールの動作確認、統制要件の実装可能性の検証、BIダッシュボードの試作、監査ログ・アクセス制御の設計を並行して詰めます。PoC段階で内部監査に一度レビューを入れておくと、本番展開でのやり直しが減ります。
ステップ4: 本格構築(6〜12か月) 本番環境の構築、データ連携パイプラインの実装、dbtでのデータモデリング、BIダッシュボードの本番実装、監査証跡の実装、権限設計の実装、障害対応手順の策定、を並行して進めます。ここで 責任分界の文書化を先に済ませます。勘定系担当・情報系担当・分析基盤担当の3者の切り分けを紙で残しておかないと、障害時に揉めます。
ステップ5: 内部監査・金融庁検査への対応リハーサル(1〜2か月) 本番稼働前に、内部監査によるレビューと、想定される金融庁検査項目への対応リハーサルを実施します。証跡の出力、権限一覧の提示、障害時の初動対応、外部委託先管理の記録、これらを実際に出せる状態になっているかを確認します。
ステップ6: 本番稼働と継続的改善(継続) 本番稼働後は、クラウドコスト最適化、モデル再学習の自動化、規制文書改定への追随、が継続テーマになります。FISC・PCI DSS・監督指針はいずれも年次で更新されるため、規制モニタリング担当を分析基盤運用チームに組み込むのが定石です。
業態別の勘所
同じ「金融機関のデータ基盤」でも、業態によって力点が違います。
銀行(地銀・第二地銀・信金) の力点は、法人融資の高度化とリテールの解約予兆・NBAです。勘定系との連携が最大の論点で、Teradataからのクラウド移行、CIFの名寄せ、支店別収益の可視化が第一目標になります。マネロン取引監視(AML)の誤検知削減も投資対効果が出やすい領域です。
証券(対面・オンライン) の力点は、顧客の投資行動分析と手数料自由化後の収益源多様化です。オンライン証券なら大量の注文・約定データとWeb・アプリのログの結合、対面証券なら営業員の活動データと顧客ポートフォリオの結合が中心になります。マネロン監視と、証券監督指針が求める顧客本位の業務運営(FD)の証跡整備が上乗せされます。
カード会社(イシュア・アクワイアラ) の力点は、不正利用検知、与信管理、加盟店分析です。PCI DSS適用範囲の設計が生命線で、DWHにPANを載せないアーキテクチャの確立が最初の課題になります。不正利用検知モデルは、リアルタイム性の要求が高く、分析系ではなくオペレーショナル系として設計する必要があります。
資金移動業・暗号資産交換業 の力点は、犯収法対応と取引監視、外部委託先管理です。事業拡大速度に対して規制対応の運用が遅れやすく、データ基盤側で監査証跡の自動生成を最初から組み込むのが安全です。
よくあるつまずき
金融データ基盤の失敗パターンには、業界特有の型があります。
統制スコープを決めずに設計を始めるのが最も多い失敗です。PCI DSSの適用範囲、要配慮個人情報の扱い、マイナンバーの区分管理を後回しにすると、PoC完了後に「このままでは監査を通せない」と設計をやり直す羽目になります。ステップ1で文書化しておくのが必須です。
勘定系との連携を急ぎすぎるのも典型的です。「せっかく作るなら勘定系まで」と欲張ると、勘定系担当との調整だけで半年、要件定義でさらに半年、本番稼働まで2年、というスケジュールになります。まず情報系だけで立ち上げ、成果を出してから勘定系連携に踏み込むのが賢明です。
内部監査を巻き込むのが遅いのも失敗の温床です。本番稼働直前に内部監査から「証跡が足りない」「権限設計が甘い」と指摘され、大幅な手戻りが発生します。ステップ3のPoC段階で一度レビューを入れておくのが実効的です。
クラウドコストが青天井になるのも金融特有です。監査要件で「全ログを7年保存」「全クエリの実行履歴を残す」といった要求が入ると、クラウドDWHのストレージとクエリコストが想定の2〜3倍になることがあります。BigQueryのパーティション設計、Snowflakeのクラスタリング、Redshiftのソートキーを初期から詰めておく必要があります。詳しくはBigQueryパーティション・クラスタリング設計|スキャン量を9割減らす型と設計ミス【2026年版】やデータ基盤の運用コストを下げる7つの型|クラウドDWHの請求を圧縮する実務が参考になります。
モデルの説明可能性を後付けにするのが5点目です。機械学習モデルによる与信判断・解約予兆・マネロン検知は、金融庁検査で必ず「判断根拠」を問われます。SHAP値やLIMEによる説明性、学習データのバージョン管理、モデル更新履歴を後から実装しようとすると数千万円規模の追加投資が発生します。設計段階で説明可能性を組み込むのが定石です。
金融機関のデータ基盤は、規制対応と業務価値の両立を稟議で通せるかが最大の分岐点です。Evastでは、FISC・PCI DSS・金融庁ガイドラインを踏まえた金融データ基盤の要件定義・PoC・本格構築を、地銀・第二地銀・カード会社・中堅証券向けに支援しています。自社の現状で「まず何から着手すべきか」を整理したい方は、サービス紹介ページからお気軽にご相談ください。初回打ち合わせでは、統制スコープの整理と、6ステップのどこから入るのが妥当かを一緒に検討します。