パーティションとクラスタリングが「請求書ショック」に直結する理由
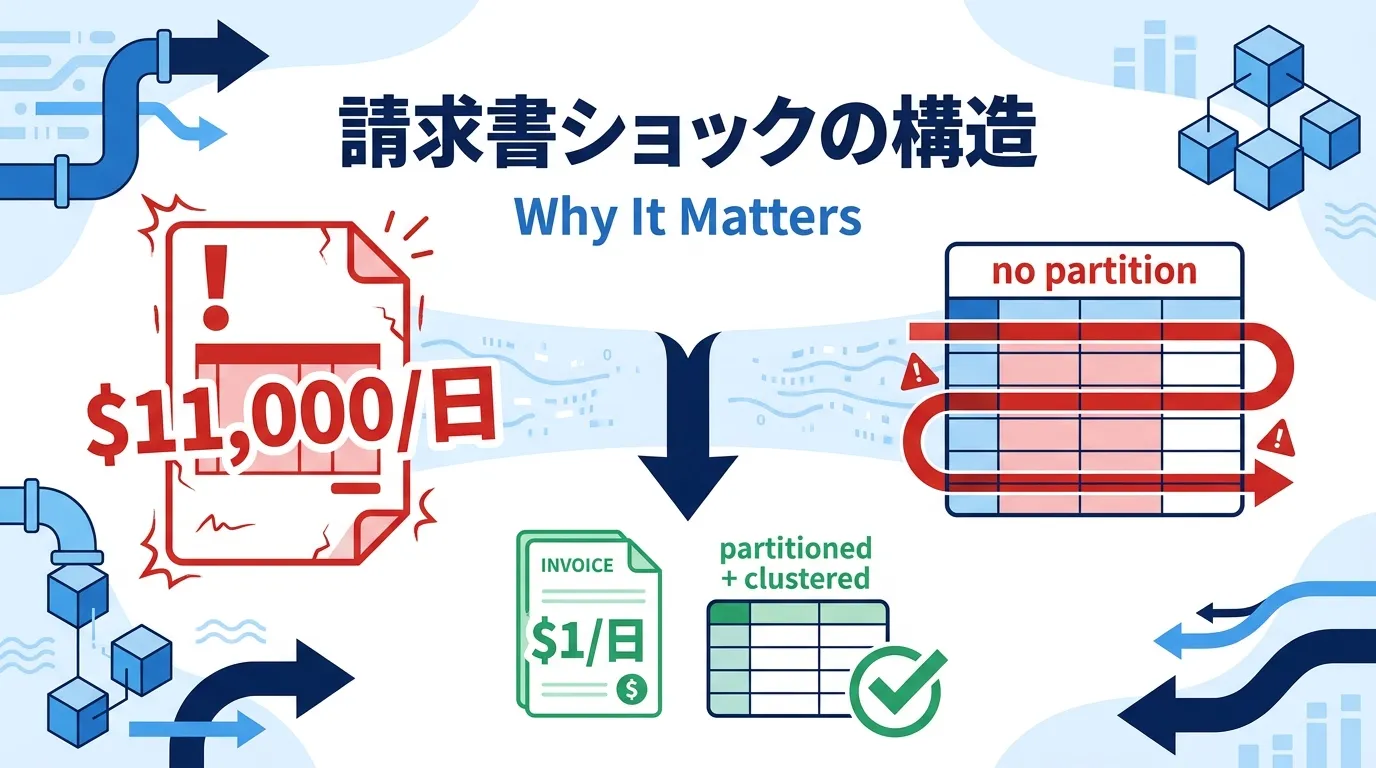
BigQueryのオンデマンド料金は1TiBあたり$6.25(2026年9月時点、月1TiBまでは無料)です。ここで課金対象になるのは結果として返る行数ではなく、クエリがスキャンしたカラムのデータ量です。
例えば1TBのイベントログテーブルに対して、パーティションなしで SELECT user_id FROM events WHERE event_date = '2026-09-01' を実行すると、WHERE句で1日分しか返らなくても1TB分のフルスキャンになり、1回で約$6.25の料金が発生します。
このテーブルをBIダッシュボードが5分ごとに叩いていたら、1日288回×$6.25 = 1日あたり約$1,800の請求が積み上がる計算です。1分ごとにポーリングするタイプの監視画面なら1日あたり$9,000規模になり、実際、この規模で月次の請求書を見て慌てて連絡をいただく現場は珍しくありません。
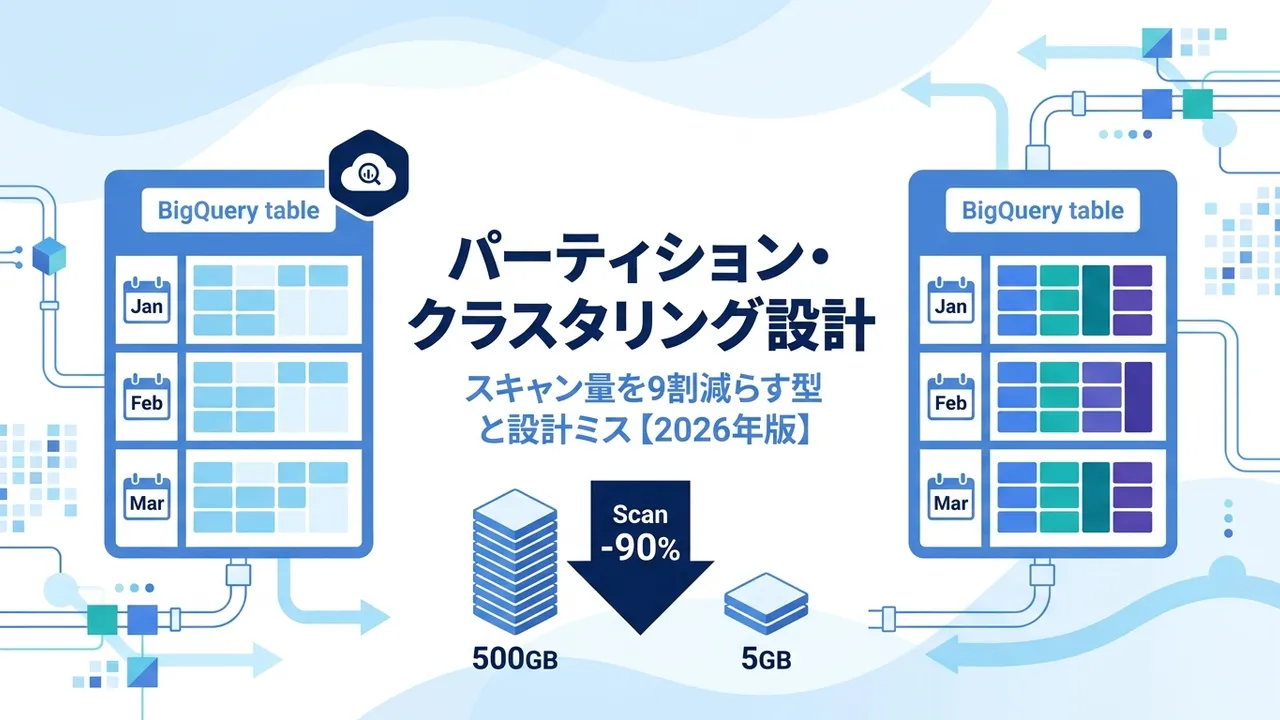
同じテーブルを event_date でパーティション分割し、user_id でクラスタリングしておくと、同じクエリのスキャン量は1日分(数GB)に、さらに関連ブロックだけに絞られて数MB〜数百MBまで落ちます。公開されている事例では、日次$175のダッシュボードを日次$1まで下げた例(月次で約$5,000削減)や、5.2GBスキャンを14MBまで、数百倍のスキャン削減を達成した例も報告されています。
つまり、パーティションとクラスタリングは「性能を上げる仕組み」というより、「スキャン量を桁で減らす請求書対策」として理解しておくのが実態に合っています。
パーティション分割の3種類と選び方
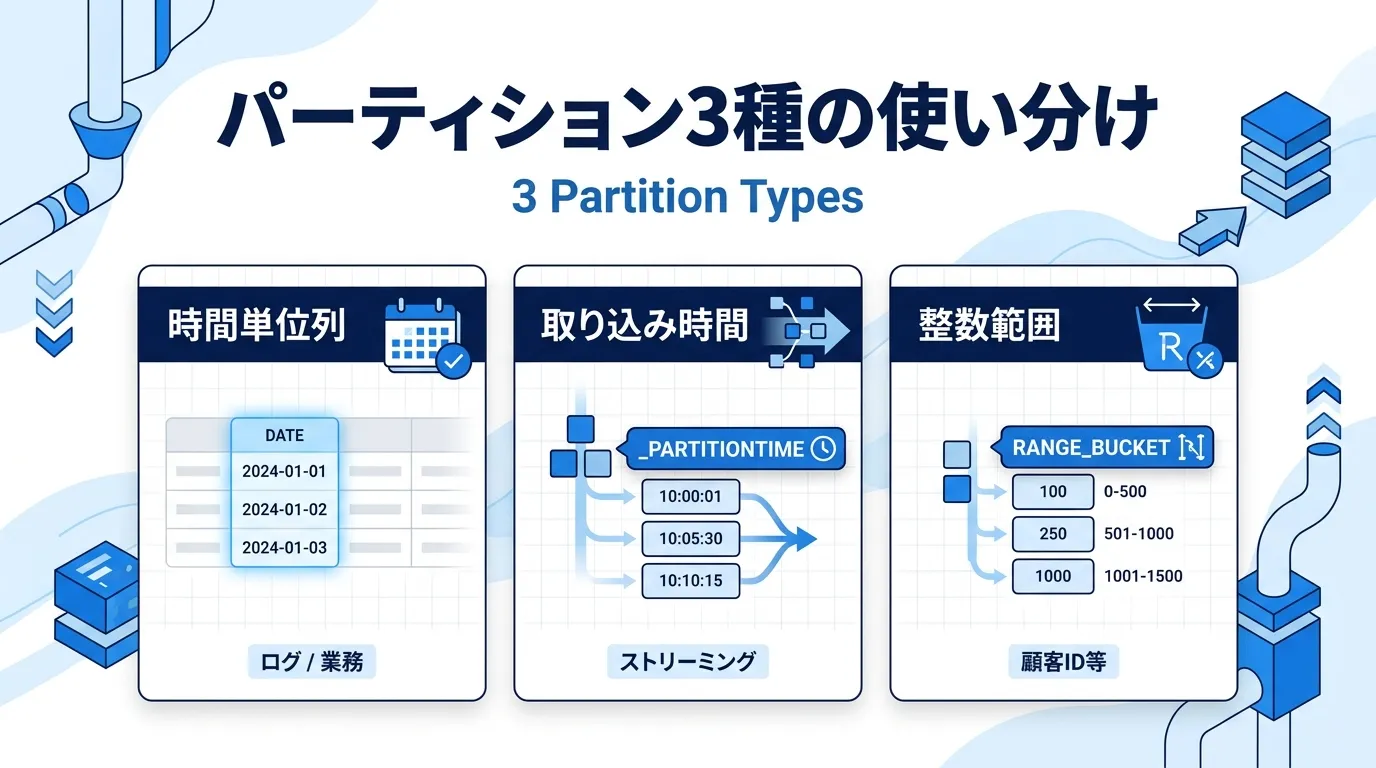
BigQueryが公式にサポートするパーティションは、次の3種類です。
| 種類 | 分割キー | 主な用途 |
|---|
| 時間単位列パーティション | DATE / TIMESTAMP / DATETIME 型の列 | イベント時刻を持つログ、トランザクション、業務系テーブル |
| 取り込み時間パーティション | 自動付与される _PARTITIONTIME | ストリーミング取り込み、CDC、時刻列がない生データ |
| 整数範囲パーティション | RANGE_BUCKET で区切った整数列 | customer_id や shop_id で均等分割したいマスタ系 |
粒度は時単位・日単位・月単位・年単位から選べます。1テーブルあたりのパーティション上限は10,000(2024年に4,000から緩和)で、時間単位パーティションで約1年強、日単位で27年、月単位で833年まで持てる計算になります。
選び方の判断軸
多くの実務ケースで最初の選択肢になるのは、時間単位列パーティション(日単位)です。ログや売上明細のようにイベント時刻がある行データは、ほぼこの型に収まります。
時刻列がなく、後工程のETLで取り込みタイミングだけが分かるデータは、取り込み時間パーティションが向いています。GAやCDCで流し込む生テーブルなどが該当します。
整数範囲パーティションは限定的ですが、顧客IDや店舗IDで論理的に分ける必要があり、かつテーブル自体がそこまで大きくないケースで使います。ただし、後述のクラスタリングで代替できることも多いので、まずは時間パーティション+クラスタリングを検討するのが定石です。
粒度の選び方(細かければよいわけではない)
1パーティションあたりのデータ量は、1GB以上を目安にします。粒度を細かくしすぎるとパーティションあたりのメタデータ管理コストが増え、10,000パーティションの上限にも早く到達します。
例えば1日あたり100MBしかログが発生しないテーブルを日単位で切ると、パーティションがスカスカになりオーバーヘッドが増えます。この場合は月単位パーティション+クラスタリングに切り替えるほうが効率的です。
クラスタリングの仕組みとパーティションとの組み合わせ方
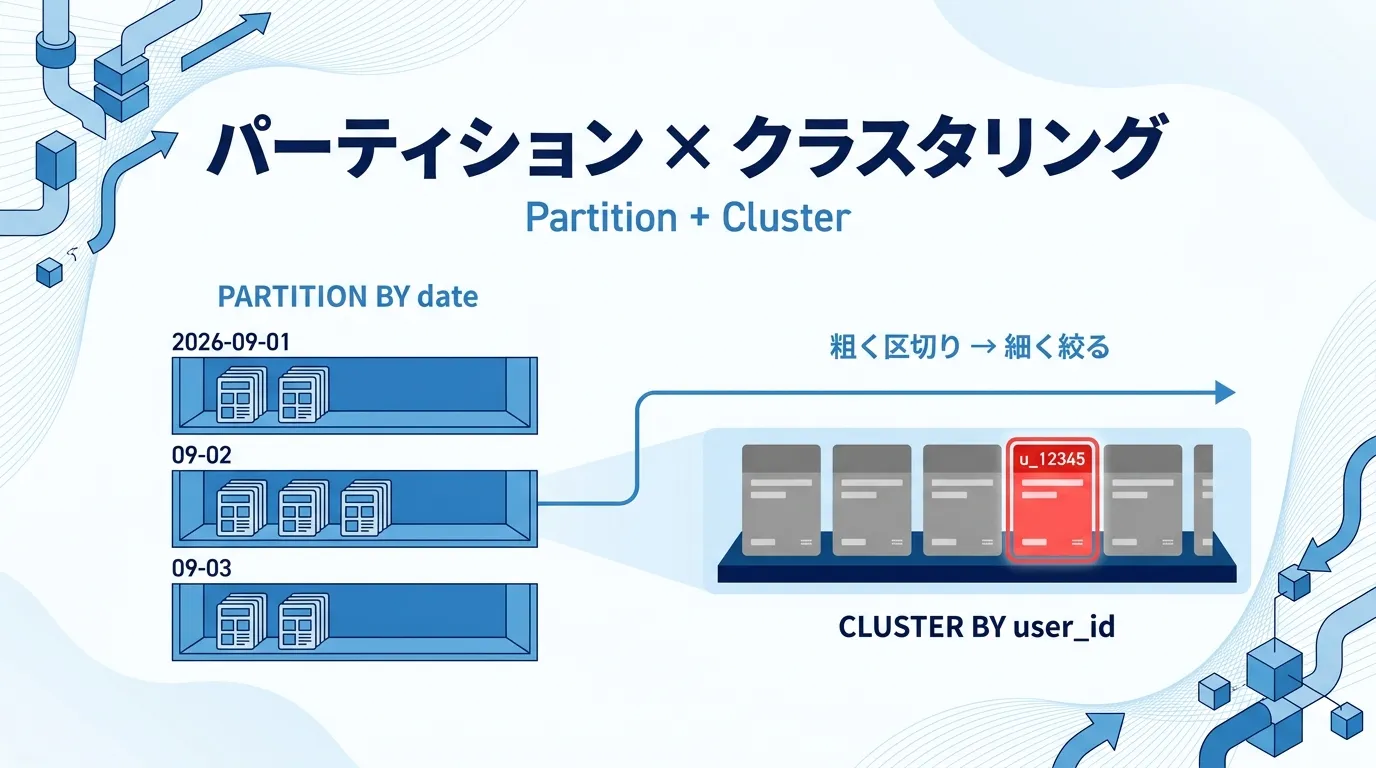
クラスタリングは、指定した列でストレージ内のブロックを物理的にソートし、クエリのフィルタ条件と一致しないブロックをメタデータでスキップする仕組みです。最大4列まで指定でき、指定した順序が意味を持ちます。
パーティションが「棚で分ける」だとすれば、クラスタリングは「棚の中を並べ替える」に近い挙動です。パーティションはドライラン時点でスキャン量が事前に確定するのに対して、クラスタリングは実行するまで実際の削減量が確定しないという違いもあります。
組み合わせの定石
現場で最も効くのは、PARTITION BY で粗く区切り、CLUSTER BY で細く絞る組み合わせです。適切に組み合わさったクエリでは、スキャン量が90〜99%削減されるケースも珍しくありません。
CREATE TABLE analytics.events (
  event_id STRING,
  event_ts TIMESTAMP,
  user_id  STRING,
  country  STRING,
  payload  JSON
)
PARTITION BY DATE(event_ts)
CLUSTER BY user_id, country
OPTIONS (
  partition_expiration_days = 400,
  require_partition_filter  = TRUE
);
このテーブルに対して WHERE event_ts >= '2026-09-01' AND event_ts < '2026-09-02' AND user_id = 'u_12345' のように書けば、まず9月1日のパーティションだけに絞られ、その中で user_id = 'u_12345' を含むブロックだけがスキャンされます。
クラスタリング列の選び方
カーディナリティが高い列を選ぶのが基本です。user_id・product_sku・region のように、値のバリエーションが多く、頻繁にWHERE句で使われる列が向いています。
反対にbool型や YES/NO のような低カーディナリティ列を選んでも、ブロックがほぼ全部残ってしまいプルーニングが効きません。指定できるのは4列までなので、「よくフィルタする順に左から並べる」判断がそのままコスト削減に直結します。
現場でよくある設計ミス5つ
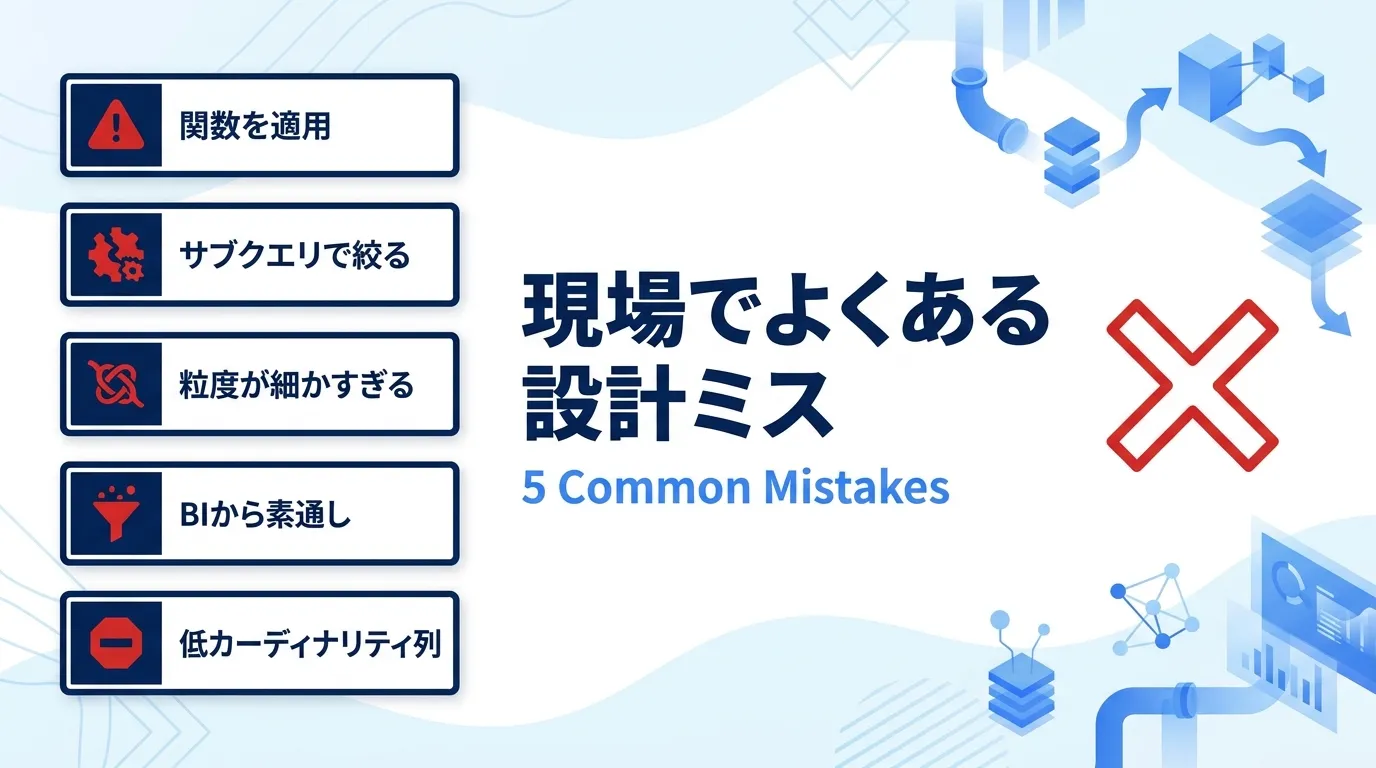
パーティションとクラスタリングを設定しても、次の5つのパターンで期待した削減が得られない現場が多くあります。
ミス1: パーティション列に関数を適用
-- ❌ 関数適用でプルーニングが無効になる
SELECT * FROM events WHERE DATE(event_ts) = '2026-09-01';

-- ✅ 静的な範囲比較で書く
SELECT * FROM events
WHERE event_ts >= '2026-09-01' AND event_ts < '2026-09-02';
パーティション列に DATE() や TIMESTAMP_ADD() などの関数を適用すると、BigQueryはどのパーティションに絞れるかを事前判定できず、フルスキャンに戻ってしまいます。
ミス2: サブクエリや動的値でのフィルタ
-- ❌ サブクエリの結果が事前確定しない
SELECT * FROM events WHERE event_ts = (SELECT MAX(event_ts) FROM events);

-- ✅ 一度別のクエリで値を取り、静的な定数で絞る
SELECT * FROM events
WHERE event_ts >= '2026-09-04 00:00:00' AND event_ts < '2026-09-05 00:00:00';
サブクエリや CURRENT_TIMESTAMP() などの動的値で絞ると、ドライランでスキャン量が判定できず、フルスキャン扱いになる場合があります。定期実行のジョブでは、静的な範囲を事前に組み立てて渡す設計が安全です。
ミス3: パーティション粒度の切りすぎ
1パーティションあたり数十MBしかないような粒度でパーティションを切ると、メタデータのオーバーヘッドが増え、10,000パーティション上限にも早く到達します。データ量に合わせて日次から月次に粒度を上げ、クラスタリングで細かい絞り込みを担わせるほうが効率的です。
ミス4: require_partition_filterを付けずBIから素通し
パーティションを切ってもWHERE句に条件を入れる責任は書き手側にあります。BIツールから接続してきた分析ユーザーがWHERE句を省略すれば、そのままフルスキャンです。後述する require_partition_filter を有効にして、書き忘れを機械的に止める設計が現実的です。
ミス5: クラスタリング列に低カーディナリティ列を選ぶ
is_active や status のような値のバリエーションが少ない列をクラスタリング列に指定しても、ほとんどのブロックがフィルタを満たしてしまい、スキャン削減効果がほぼ出ません。カーディナリティが数百以上ある列を優先し、迷ったら実際のフィルタ回数の多い順に選びます。
既存テーブルに後付けする手順(dbtも含む)
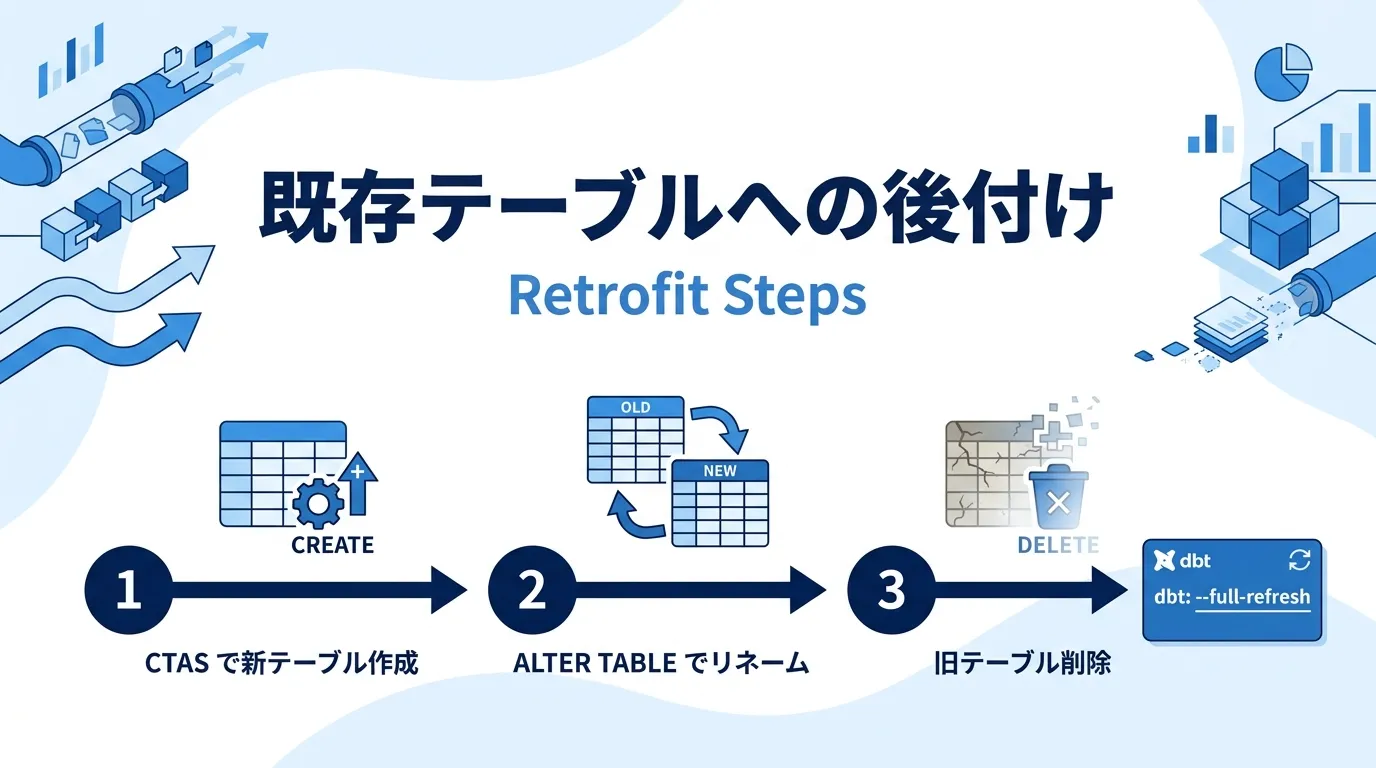
「今動いているテーブルにパーティションが入っていない」というケースは、実務では非常によくあります。ここで問題になるのは、パーティション設計は後付けできないという制約です。
素のBigQueryでの再作成
パーティションを追加するには、テーブルを作り直す必要があります。
-- 1. パーティション付きの新テーブルを作成
CREATE TABLE analytics.events_new
PARTITION BY DATE(event_ts)
CLUSTER BY user_id
OPTIONS (require_partition_filter = TRUE)
AS
SELECT * FROM analytics.events;

-- 2. 旧テーブルを退避 & リネームで置き換え
ALTER TABLE analytics.events RENAME TO events_old;
ALTER TABLE analytics.events_new RENAME TO events;

-- 3. 動作確認後、旧テーブルを削除
DROP TABLE analytics.events_old;
数百GB以上のテーブルでは、CREATE TABLE AS SELECT の実行に数時間かかります。切り替え中はテーブルへの書き込みを止めるか、更新差分を後追いする段取りを合わせて設計しておきます。
一方、クラスタリングは ALTER TABLE ... SET OPTIONS や ALTER TABLE ... CLUSTER BY で後付けできます。ただし既存データは自動で再クラスタリングされないため、UPDATE を打つか全量を書き換えて初めて既存ブロックにも効くようになります。
dbtでの宣言方法
dbtで管理しているモデルなら、config() にパーティションとクラスタリングを宣言するのが標準です。
{{ config(
    materialized='incremental',
    partition_by={
      'field': 'event_ts',
      'data_type': 'timestamp',
      'granularity': 'day'
    },
    cluster_by=['user_id', 'country'],
    require_partition_filter=true
) }}
初回の切り替え時は dbt run --full-refresh でテーブルを作り直します。dbtコミュニティの公開事例では、パーティションとクラスタリングを組み込んだリファクタリングで月次$20,000規模のコスト削減や、日次バッチが6時間から25分に短縮といった数値が報告されています。dbtで扱う場合は、テーブルオーナー判定を含めた再作成手順を事前に確認しておきます。
このあたりの dbt 側の設計思想はdbtとは?データ変換を効率化するツールと使い方を解説でも触れています。
設計を守るためのガードレール(require_partition_filterと監視)
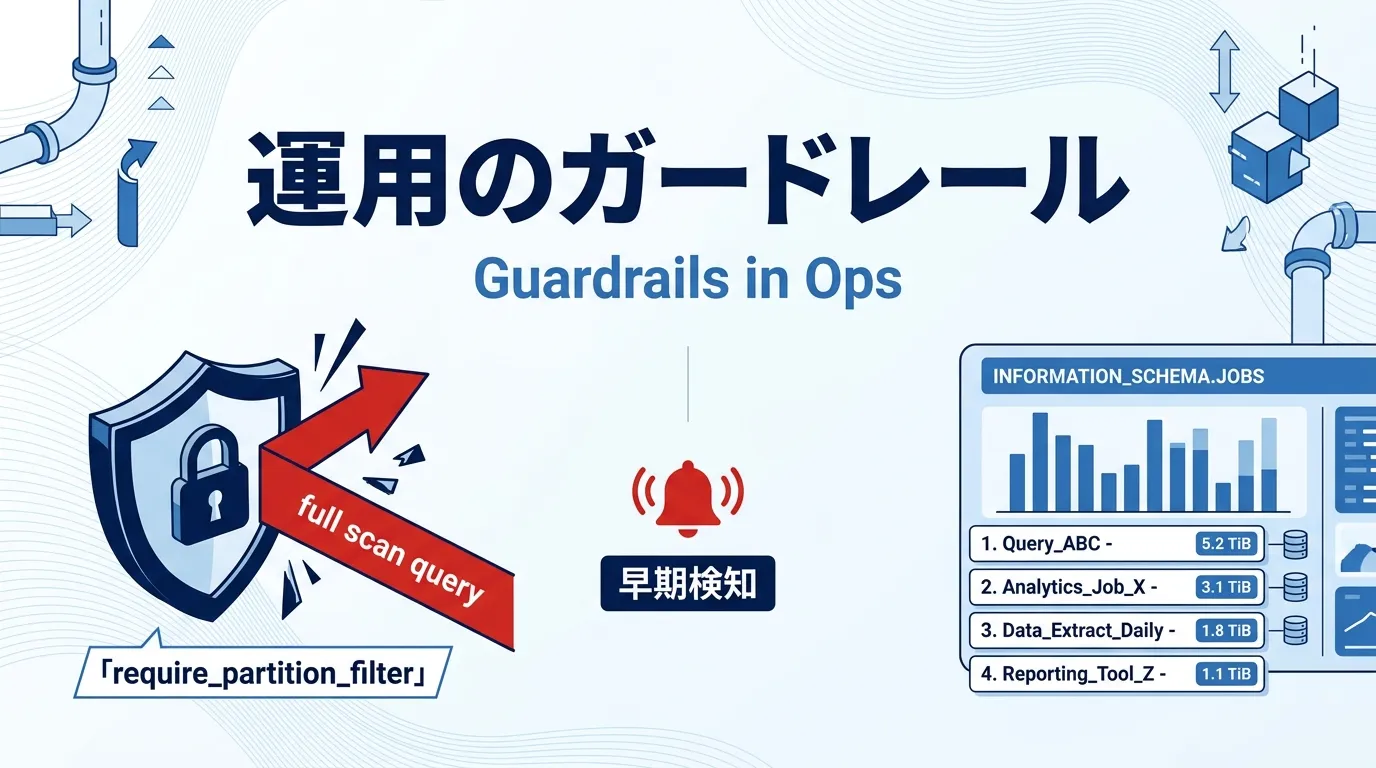
パーティションとクラスタリングを設計しても、書き手のSQLが崩れると効果が消えます。運用フェーズで安定させるには、次の2つのガードレールを組み合わせるのが定石です。
require_partition_filterで書き忘れを止める
テーブルに require_partition_filter = TRUE を付けると、WHERE句にパーティション列の条件がないクエリは実行前にエラーで拒否されます。
Cannot query over table 'analytics.events' without a filter over
column(s) 'event_ts' that can be used for partition elimination
BIツールやアドホック分析からの誤爆を強制的に止める効果があり、コスト事故が起きた組織ではまず全テーブルに付ける判断をしても構いません。既存のダッシュボードやSQLに影響が出るため、開発環境で INFORMATION_SCHEMA.JOBS_BY_PROJECT を使って影響範囲を洗い出してから、本番に反映します。
INFORMATION_SCHEMA.JOBS を集計すれば、ユーザー別・クエリテンプレート別に「どのクエリが何TBスキャンしているか」が見えます。
SELECT
  user_email,
  query,
  ROUND(SUM(total_bytes_billed) / POW(1024, 4), 2) AS scanned_tib,
  ROUND(SUM(total_bytes_billed) / POW(1024, 4) * 6.25, 2) AS estimated_usd
FROM `region-us`.INFORMATION_SCHEMA.JOBS_BY_PROJECT
WHERE creation_time >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 7 DAY)
  AND statement_type = 'SELECT'
GROUP BY user_email, query
ORDER BY scanned_tib DESC
LIMIT 20;
このクエリを週次で流して上位10件を確認するだけで、パーティション未使用のフルスキャンや、想定外に重いクエリを早期に検出できます。「請求書ショックの前に検知する」運用の入口として実装コストが低いので、最初に組み込んでおきたい仕組みです。
2026年時点のEditions前提での考え方
現在、多くの現場はスロット課金のBigQuery Editions(Standard / Enterprise / Enterprise Plus)に移行しています。Editionsではクエリ単位のTB課金ではなくスロット時間課金になるため、「同じ月$3,000でも、パーティション設計次第で処理できるクエリ本数が10倍以上変わる」構造になります。
つまり、Editions化してもテーブル設計の重要性は下がるどころか、投資対効果はむしろ上がっています。オートスケール前提の運用でも、粗くパーティションを切っておく設計はコスト予測の安定にも効きます。
まとめ|設計の型を先に決めておく
パーティションとクラスタリングは、後から変えるコストが高い設計判断です。運用の途中で気付くと、CREATE TABLE AS SELECTでの作り直しと切り替え作業が発生し、対象テーブルが大きいほど工数が跳ねます。
現場で最も効くのは、次の順で「設計の型」を先に決めておくことです。
- 時間単位列パーティション(日単位が基本、少量データは月単位) をまず選ぶ
- カーディナリティの高い列をクラスタリング列に4個まで、フィルタ頻度順に並べる
- 新規テーブルには
require_partition_filter = TRUE を最初から付ける INFORMATION_SCHEMA.JOBS を週次で見て、フルスキャンの兆候を早期検知する- dbtで管理しているモデルは
config() に宣言し、--full-refresh の運用手順を決めておく
Evastでは、BigQuery導入初期から Editions 前提のコスト設計・パーティション/クラスタリング設計・INFORMATION_SCHEMA監視の仕組み化まで、データ基盤構築の伴走支援としてご支援しています。既存の請求書ショックに対する原因調査からのご相談も歓迎です。
もし「これから BigQuery を導入する」段階の方は、料金体系や無料枠を含む全体像をBigQuery導入ガイド|手順・料金・無料枠・費用相場【2026年版】で先に押さえておくと、この記事の設計判断がそのまま初期設計に活かせます。