出発点の違い:DWH vs レイクハウス
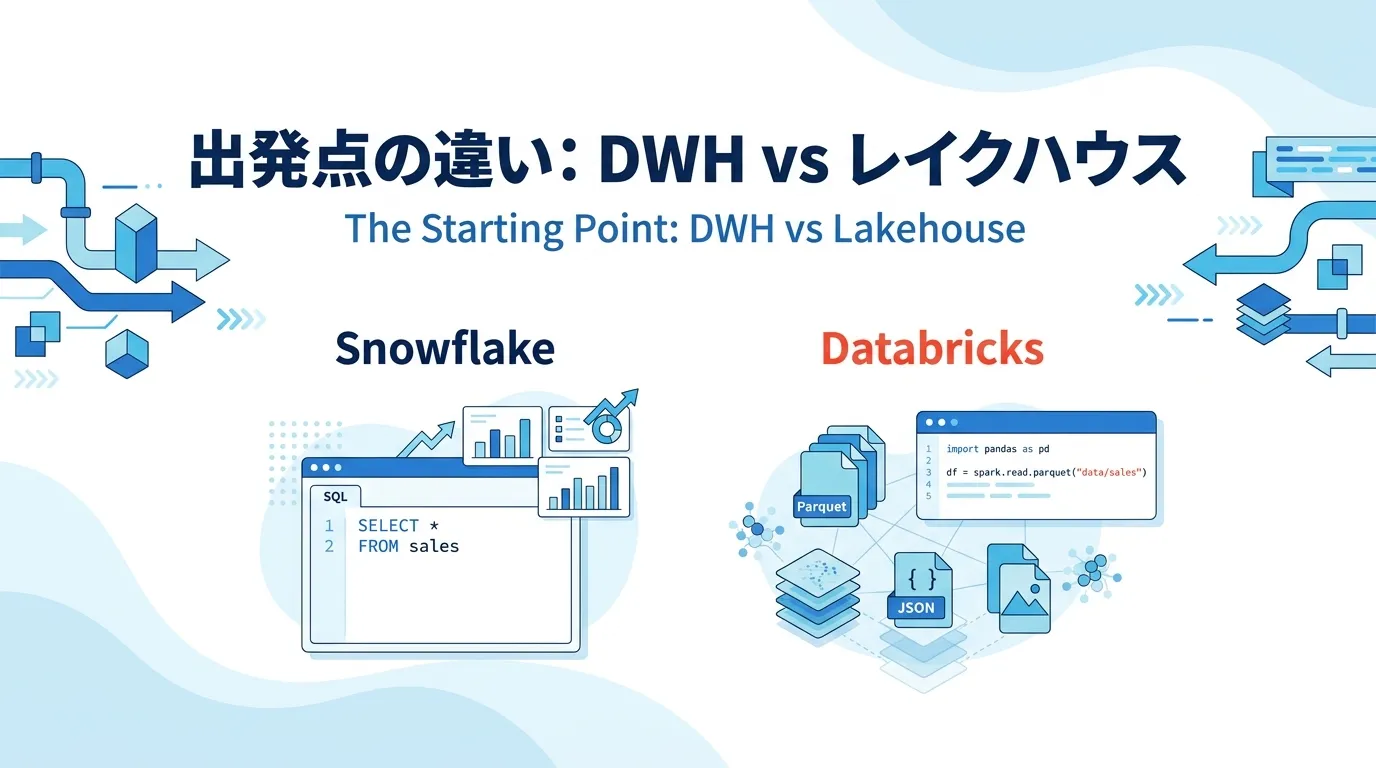
Snowflakeは2012年創業のクラウドDWHです。SQLで書かれた集計クエリを速く・安く回すために設計されました。ストレージとコンピュートを分離し、複数チームが並列でクエリを走らせても互いに干渉しない仕組みを整えたのが強みです。もともとBI・レポート・集計といった用途に最適化されています。
Databricksは2013年創業のデータ×AI基盤です。大規模データ処理の技術であるApache Sparkを生み出した研究者が立ち上げた会社が運営しています。出発点は「あらゆるデータを処理して、機械学習モデルまで作れる基盤」で、ここに後からDatabricks SQLというBI・SQL用の機能を追加してきました。
両者ともここ数年でお互いの領域に侵食しています。SnowflakeはCortexという生成AI機能をSQLから呼べるようにし、DatabricksはDatabricks SQLでBIワークロードにも耐えるように性能を伸ばしました。ただ、得意領域はいまもはっきり分かれています。SQL・BIから見るならSnowflake、機械学習・非構造化データから見るならDatabricksという構図です。
アーキテクチャ:仮想ウェアハウス vs Delta Lake × Sparkクラスタ
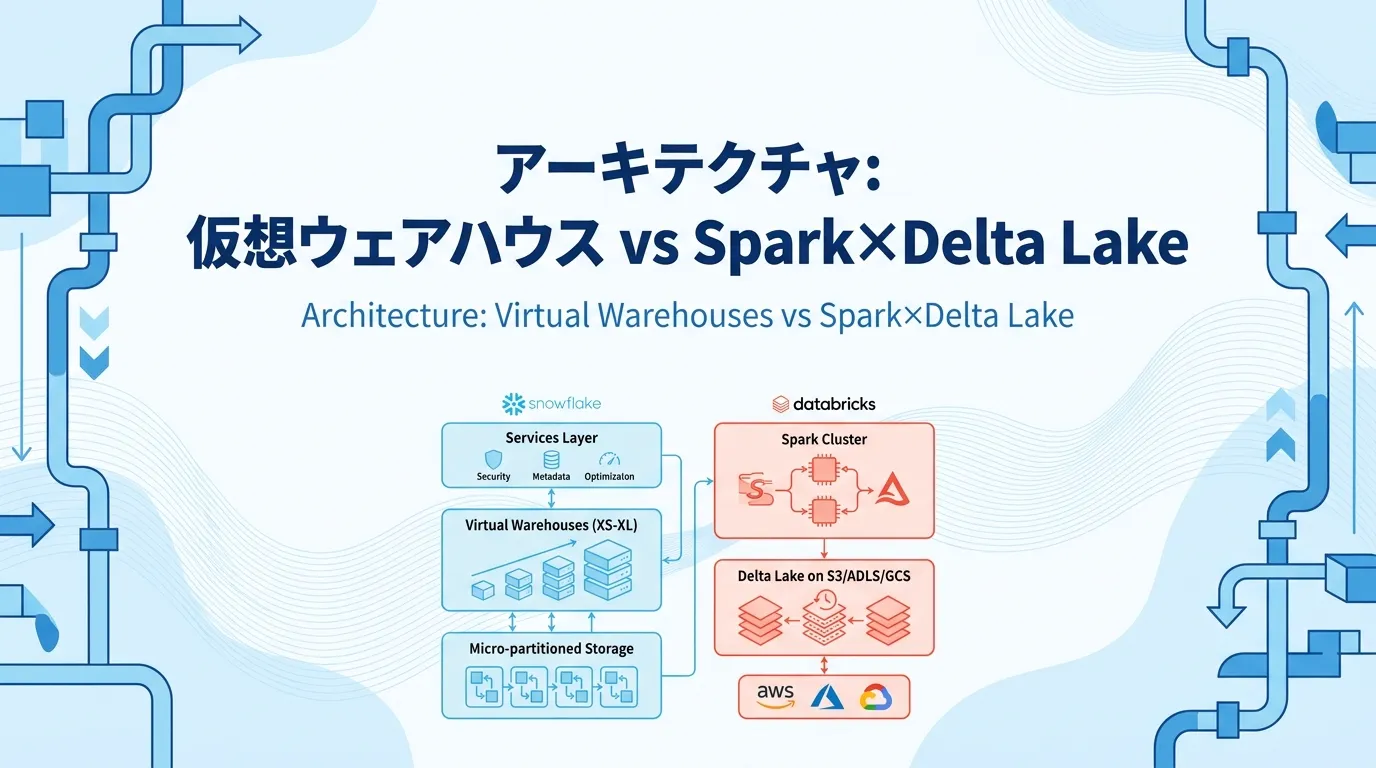
設計思想の違いは、アーキテクチャの絵にそのまま出ます。
Snowflakeは、Snowflake独自の圧縮された列指向フォーマット(マイクロパーティション)でデータを保管し、その上に仮想ウェアハウス(Virtual Warehouse:クエリを実行する計算リソースの単位)を必要な分だけ立ち上げてクエリを走らせます。データはSnowflakeの管理下にあり、ユーザーはストレージフォーマットを意識しません。仮想ウェアハウスの詳細はSnowflakeとは?クラウドDWHの特徴と導入メリットを解説でまとめています。
Databricksは、データをDelta Lakeというオープンフォーマット(Parquetにトランザクション機能を足したもの)で、自社のクラウドストレージ(AWS S3・Azure ADLS・GCP GCS)に置きます。その上でSparkクラスタを立ち上げて処理する構成です。データは自社のクラウドアカウント内に置かれ、フォーマットもオープンで、Databricks以外のツールからも読めます。
この違いから2点の実務的な差が生まれます。1つはデータの持ち方。Snowflakeはベンダーの中に閉じますが、Databricksは自社のクラウド内でオープンな形で持てます。もう1つは処理の柔軟性。Snowflakeはほぼ全てSQLで書きますが、DatabricksはSQLに加えてPython・Scala・Rの選択肢があり、ノートブック上でMLモデルの学習まで書けます。
| 設計軸 | Snowflake | Databricks |
|---|
| ストレージ | 独自フォーマット(Snowflake管理) | Delta Lake(自社クラウドストレージ) |
| 計算リソース | 仮想ウェアハウス(SQL処理向け) | Sparkクラスタ(汎用計算・ML対応) |
| 主要言語 | SQL中心 | SQL・Python・Scala・R |
| データ形式 | 構造化・半構造化 | 構造化・半構造化・非構造化 |
料金モデル:クレジット vs DBU × クラウド代
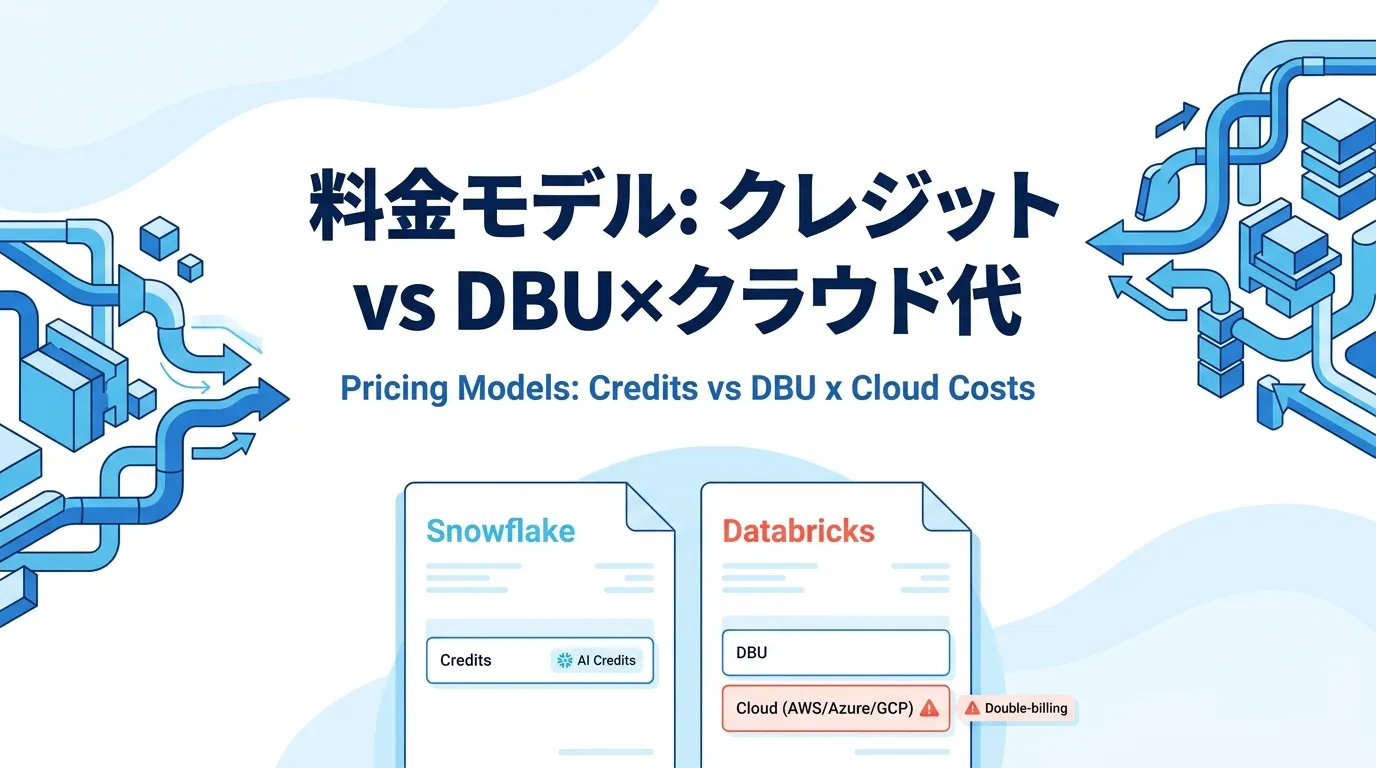
料金の見積もり方も、両者で大きく違います。
Snowflakeの料金は、大きく次の2本です。ストレージ課金(圧縮後のデータ保管量)と、コンピュート課金(仮想ウェアハウスの稼働時間×クレジット単価)です。単価はエディション(Standard/Enterprise/Business Critical)とクラウド・リージョンで変わります。仮想ウェアハウスを止めれば課金は止まるので、使わないときの課金は基本的にありません。
2026年4月からは、AI機能向けにAI Creditsという別枠の課金が加わりました。LLM機能はモデルごとに100万トークン単位で課金され、小型モデルは1ドル未満、フロンティア級モデルは5ドル前後といったレンジです。Cortex Agents・Cortex Codeなどのエージェント機能は1AIクレジット2〜2.2ドルで、既存のSnowflakeクレジットとは独立して測ります。
Databricksの料金は、DBU(Databricks Unit=処理量の単位)+クラウドのサーバー利用料の2本立てです。DBUはJobs Compute(本番バッチ、約0.15ドル/DBU)、All-Purpose Compute(対話的ノートブック、約0.55ドル/DBU)、Serverless SQL(BI・SQL、約0.70ドル/DBU)のように用途で単価が違います。加えて、Sparkクラスタを動かすAWS等のサーバー代が別途、自社のクラウドアカウントに請求されます。
見積もりで一番差が出るのはここです。SnowflakeはSnowflake側の請求書1枚でだいたい把握できるのに対し、Databricksは請求書が2枚(Databricks+クラウド)に分かれます。Databricksでクラウド代を見落として、請求が想定の1.5〜2倍になる事故は珍しくありません。両基盤を含むDWH費用の全体像はクラウドDWH費用比較|BigQuery・Snowflake・Redshiftでまとめています。
AI・機械学習:SQLで完結(Cortex)vs 開発基盤として作り込む(Mosaic AI)
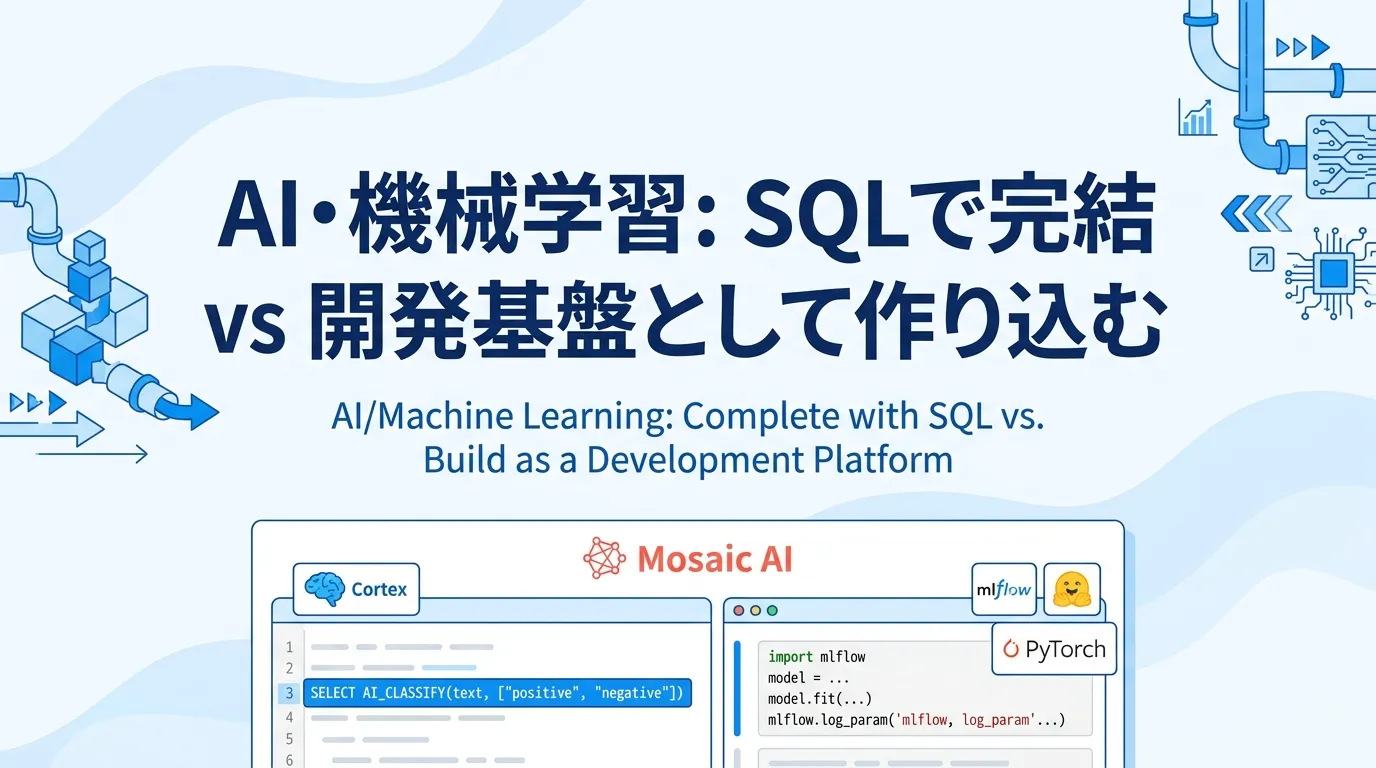
AI対応は両者の差が特に見えるところです。
SnowflakeのCortexは、SQLからそのままLLMや機械学習の機能を呼べるのが特徴です。たとえば SELECT AI_CLASSIFY(review_text, ['positive', 'negative']) FROM reviews; のように、レビュー分類・要約・翻訳などを1行のSQLで実行できます。Anthropic Claude・Meta Llama・Snowflake独自のArcticなど、複数のLLMから選べます。社内文書検索向けのCortex SearchやNL2SQL向けのCortex Analystも用意され、BIエンジニアの延長でAIが使える設計です。
DatabricksのMosaic AIは、モデルの学習から推論・監視までを開発基盤として作り込む発想です。データエンジニアやMLエンジニアがノートブック上で、PyTorchやHugging FaceのモデルをファインチューニングしてMLflowで実験を管理し、モデルサービングで本番運用する、という一連の流れを1つの基盤で回せます。2023年に買収したMosaicMLの技術をベースに、大規模モデルの学習・推論も自前でできます。
選び方の目安はこうです。既存のデータをそのままSQLで分類・要約・検索する程度ならSnowflakeで十分に足ります。逆に、自社独自のモデルを学習させたい・非構造化データを大量に扱うRAGを作り込みたい・MLパイプラインをきちんと運用したいならDatabricksが向きます。生成AIとデータ整備の関係はなぜAI時代にこそデータ基盤が必要か|生成AIが失敗する理由で整理しています。
データエンジニアリング:Snowpark vs Spark
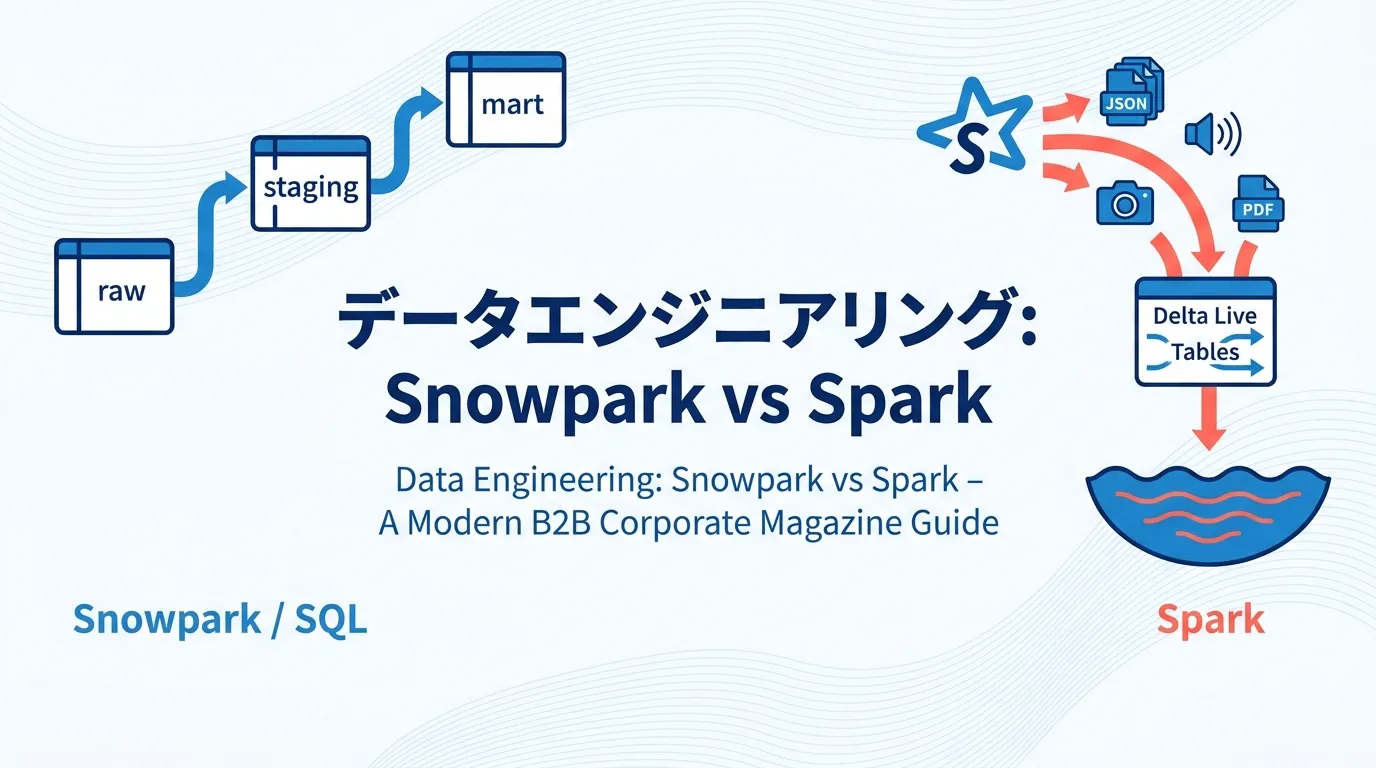
データエンジニアリング(データを取り込み、変換して、分析用に整える工程)の作り方も違います。
SnowflakeはSQLとSnowparkが中心です。多くの変換処理はSQLで書き、それをdbtなどのツールで整理するのが定番です。Pythonが必要な場合はSnowpark(Snowflake上でPythonを走らせる仕組み)を使いますが、Sparkに比べれば適用範囲は狭く、大規模な非構造化データ処理には向きません。ETL・ELTの考え方はETLとELTの違いとは?5つの比較軸とELTが主流になった理由で整理しています。
DatabricksはSparkが土台で、テキスト・画像・音声・PDFといった非構造化データも同じ基盤で扱えます。ストリーミング処理(絶えず流れてくるデータをほぼリアルタイムに処理する仕組み)にも強く、リアルタイムに近い分析パイプラインを組みやすい構造です。Delta Live TablesやWorkflowsといったパイプライン専用の機能も揃っています。
日次バッチのSQL変換が中心で、非構造化データもほぼ扱わない会社ならSnowflakeで十分軽く回せます。一方、ログ・イベント・センサー・画像などを大量に扱う会社や、リアルタイム性が求められる用途ではDatabricksの恩恵が大きく出ます。
ガバナンス・共有:Horizon vs Unity Catalog
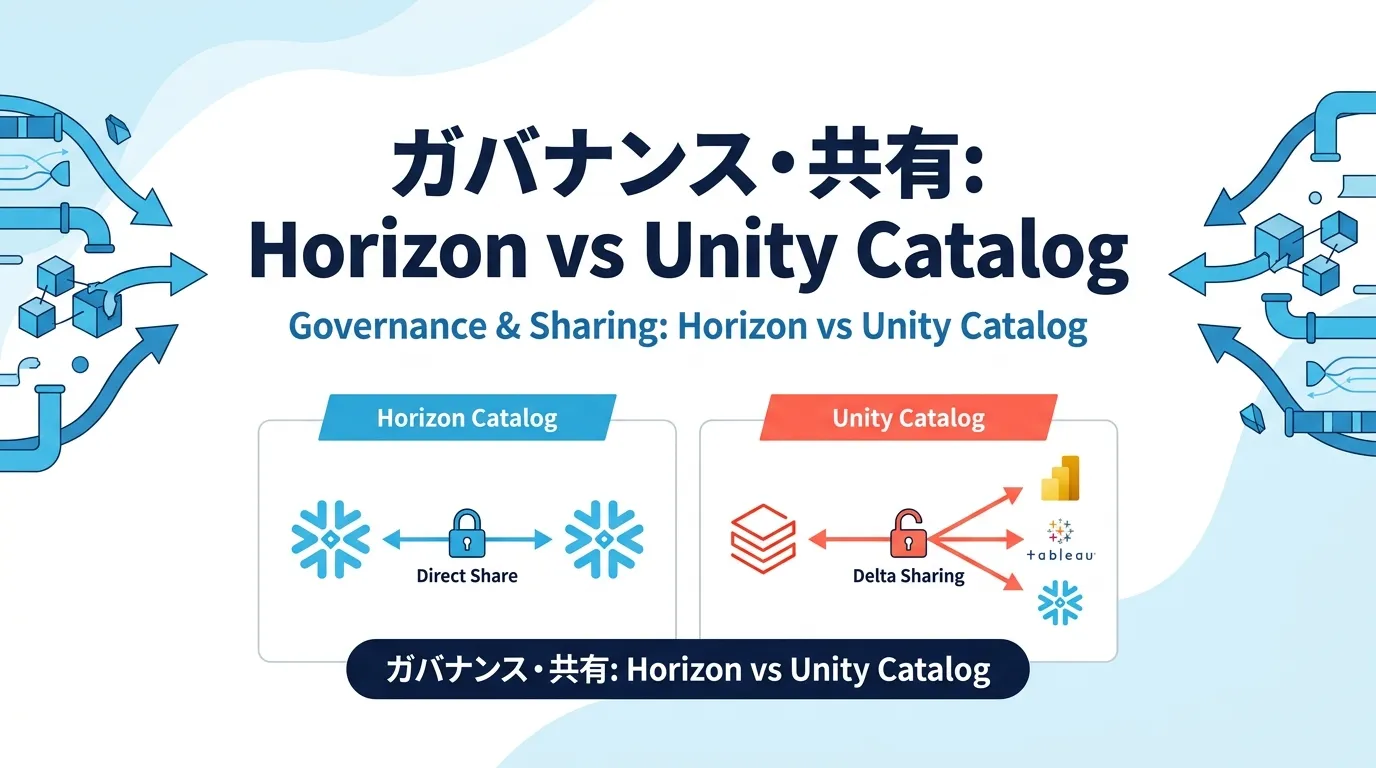
「誰がどのデータを見られるか」「どこから来たデータか」を管理するガバナンス機能は、両者とも近年強化された領域です。
SnowflakeのHorizon Catalogは、権限管理・データマスキング・監査ログ・データリネージ(データの流れの追跡)を提供します。強みは、Snowflake Data Cloudでのデータ共有です。他社Snowflakeアカウントとテーブルを直接共有でき、コピーせずに参照させられます。取引先や社内他部署にデータを渡すユースケースでこの機能が効きます。
DatabricksのUnity Catalogは、権限管理・データマスキング・監査・リネージに加え、Delta SharingというオープンプロトコルでSnowflakeやPower BIといった他ツールからもデータを参照させられます。ベンダー中立な共有規格を推している点が特徴です。
社内で完結する分析基盤としてのガバナンスなら両者とも大差ありません。差が出るのは対外的なデータ共有で、「同業他社もSnowflakeを使っている」ならSnowflake、「共有相手のツールをこちらから縛りたくない」ならDatabricksという選び方になります。
選び方の指針:ユースケース別の使い分け
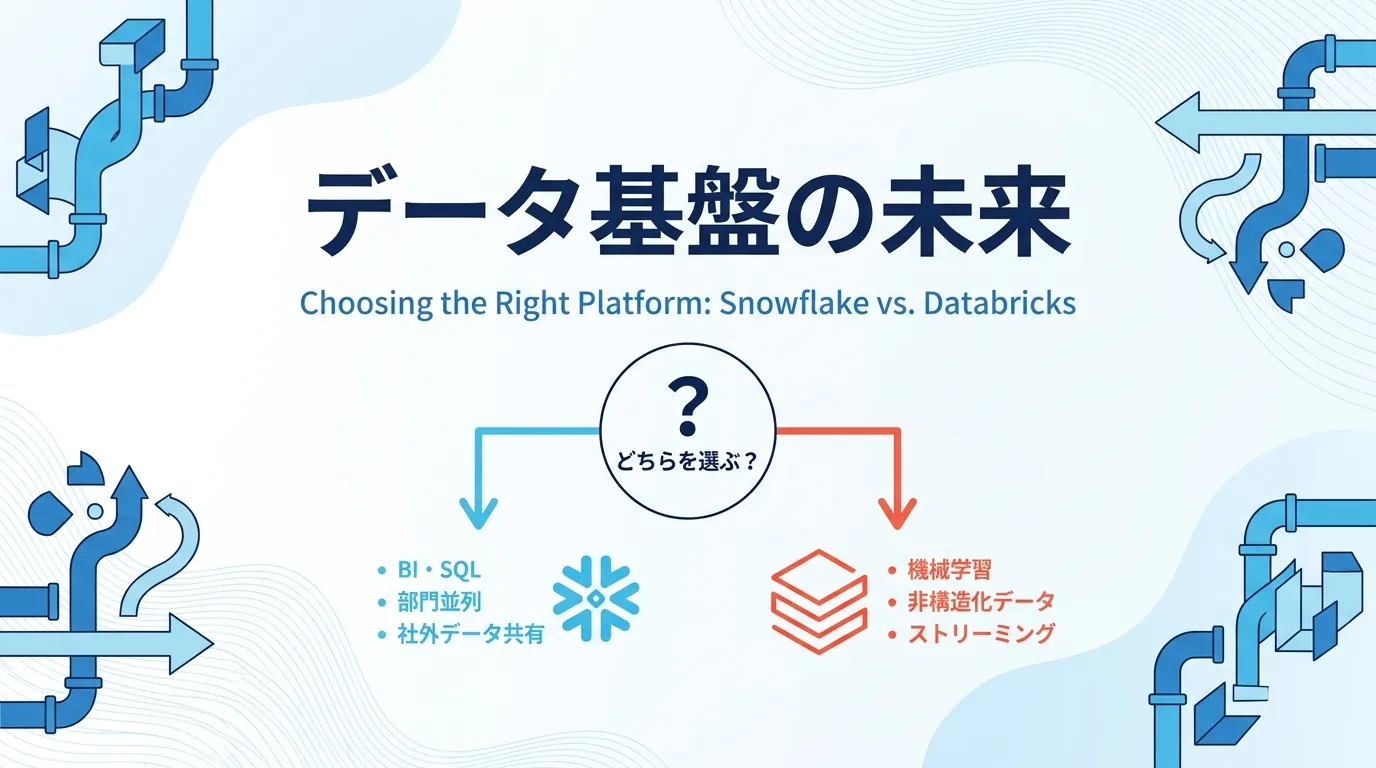
7つの軸を踏まえて、実務での選び方を整理します。判断で迷ったときは、まず自社の基盤の重心がSQL側にあるか、機械学習・非構造化データ側にあるかを見るのが近道です。
Snowflakeが向く会社:
- 経営層・営業・マーケティングにBIダッシュボードを配りたい
- SQLで書ける分析が中心で、開発チームもSQLに慣れている
- 生成AI活用はまずは社内文書検索・分類・要約くらいから始めたい
- 複数チーム・複数部門で並列にクエリを回す運用にしたい
- 取引先とのデータ共有(Snowflake同士)を想定している
Databricksが向く会社:
- 機械学習モデルを自社で開発・運用したい
- テキスト・画像・音声・PDFなど非構造化データを大量に扱う
- ストリーミング処理やリアルタイムに近い分析基盤を組みたい
- データを自社のクラウドアカウント内にオープンフォーマットで持ちたい
- Pythonで書くデータエンジニアリングチームがすでにいる
両方の要素があるときは、片方の得意領域から始めて、必要になった時点で不足分だけ足す進め方が現実的です。基盤を2つ抱えると運用と権限管理が二重になるので、併用は「DatabricksでMLモデルを作り、成果をSnowflakeのBIで見せる」など明確な目的があるときに限るのが無難です。BigQueryも含めて3社を並べたい場合は、SnowflakeとBigQuery比較:コスト・性能・機能の違いと選び方と、DWHベンダーを横断する視点のデータ基盤のベンダー比較|主要8ベンダーの選び方もあわせて参考にしてください。
まとめ:出発点の違いを理解して、自社の重心で選ぶ
DatabricksとSnowflakeの違いを7点で整理します。
- 出発点:SnowflakeはSQL・BI向けクラウドDWH、DatabricksはSpark・ML向けレイクハウス
- アーキテクチャ:Snowflakeは仮想ウェアハウス+独自ストレージ、DatabricksはSparkクラスタ+Delta Lake(自社クラウド上)
- 料金:Snowflakeはクレジット1本立て+AI Credits、DatabricksはDBU+クラウド代の二重課金
- AI:SnowflakeはSQLからLLMを呼ぶCortex、DatabricksはMLパイプラインを作り込むMosaic AI
- データエンジニアリング:SnowflakeはSQL・Snowpark中心、DatabricksはSpark中心で非構造化データ・ストリーミングに強い
- ガバナンス:両者とも一通り揃うが、共有はSnowflake同士の連携かオープン規格のDelta Sharingかで差
- 選び方:BI・SQL中心はSnowflake、ML・非構造化データ中心はDatabricks
両者はAI機能の強化競争で機能面が近づいていますが、出発点の得意領域は依然として異なります。無理に一方を万能に使うより、自社の重心に合ったほうを選ぶほうが、運用も費用も無理がなくなります。
データ基盤・AI活用のご相談はEvastへ
株式会社Evastでは、Snowflake・Databricks・BigQueryなどクラウドDWHとレイクハウスの選定・設計から、ETL/ELT実装・BIダッシュボード開発、機械学習の実装まで、データ基盤の一気通貫支援を行っています。
- 「SnowflakeとDatabricksのどちらを選ぶべきか迷っている」
- 「BIはSnowflakeで動いているが、AI開発も社内で始めたい」
- 「Databricksを入れたが、費用が想定より膨らんでいて見直したい」
構成の選定段階からでも構いません。現状のデータ環境の診断から、設計・実装まで伴走します。
→ データ基盤構築サービスを見る → 無料相談を申し込む