なぜHubSpot→BigQuery連携は選択肢が5つに分かれるのか
同じ「HubSpot → BigQuery」の要望でも、案件ごとに採用される方式が違うのは、要件が3つの軸で大きくばらつくためです。
1つ目は 対象データの範囲 です。標準4オブジェクト(Contact/Company/Deal/Ticket)だけならHubSpot純正統合で足りますが、カスタムオブジェクト(会員/契約/案件など独自オブジェクト)、エンゲージメント(メール送信/開封/クリック、通話履歴、ミーティング)、履歴プロパティ(ライフサイクルステージ遷移)まで含めたい場合、純正統合ではカバーできず、Fivetran・trocco・内製のいずれかが必要になります。
2つ目は 鮮度要件 です。マーケレポートを翌朝9時までに更新できれば十分なのか、時間単位で「今リアルタイムに動いているキャンペーン」を見たいのか。純正統合は日次06:00 UTC固定なので、時間単位の要件がある場合は他の方式に切り替えが必要です。Fivetran・troccoは15分〜1時間単位、内製は分単位も設計可能です。
3つ目は 社内の技術資産と稟議事情 です。すでにデータエンジニアが1人以上いてPythonとBigQueryを触れる会社なら、内製かAirbyte OSSで月額を圧縮できます。エンジニア工数がなく、稟議も国内SaaSしか通りにくい会社ならtroccoが一択。すでにMarketing Hub Enterprise+Reporting Add-onを契約済みなら純正統合を追加コストなしで使える一方、Sales Hub中心の会社では純正統合の対象外になります。
この3軸で要件を整理すれば、5つの選択肢のうちどれが自社に合うかは概ね絞れます。以降のセクションでは、それぞれの方式の中身と、費用相場、選び方の判断軸を順に見ていきます。
5つの連携方式:概要と得意領域
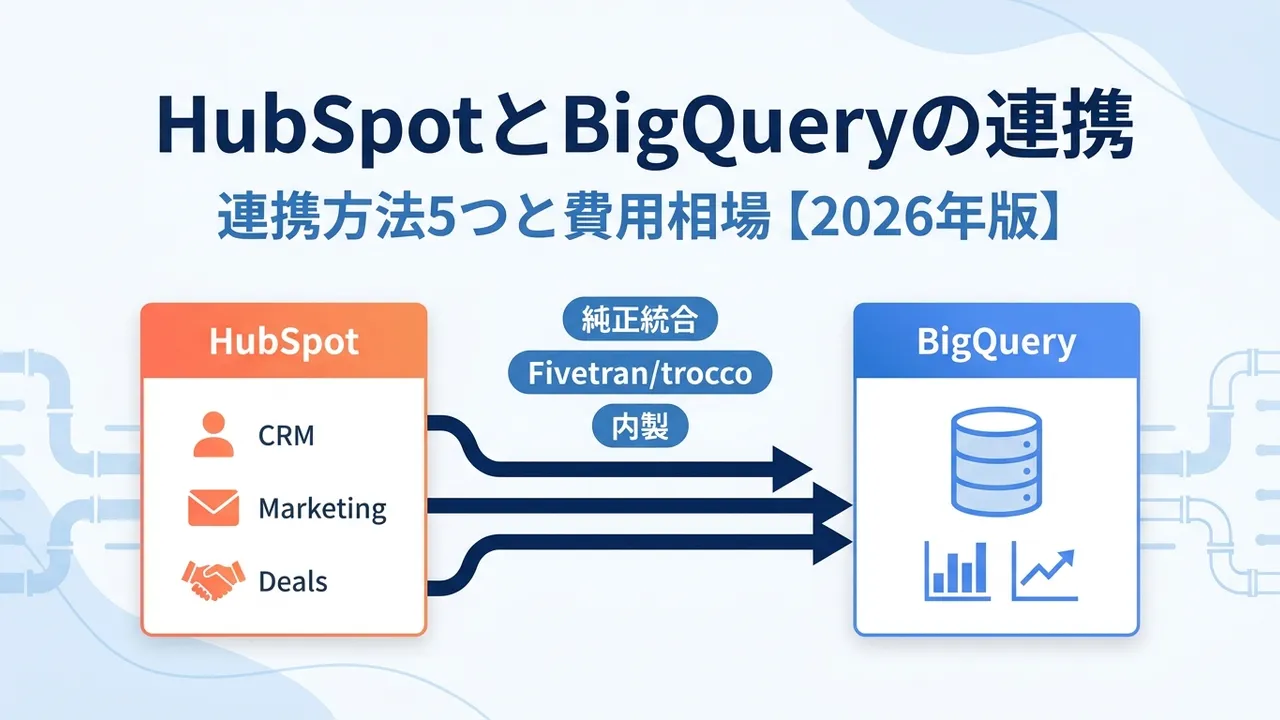
HubSpot → BigQuery の連携方式は、大きく次の5つに整理できます。
| 方式 | 提供元 | 実装難易度 | 得意な要件 |
|---|
| HubSpot純正BigQuery統合 | HubSpot(Beta) | 低 | 標準4オブジェクトのみ、日次で足りる、追加コスト0円 |
| Fivetran | Fivetran(米) | 低 | 複数SaaS横断、スキーマ自動追従、履歴モード |
| trocco | primeNumber(日) | 低 | 日本語サポート、稟議通しやすさ、対象絞り込みの柔軟性 |
| Cloud Run 内製 | Google Cloud+自作 | 高 | 費用最小化、カスタム要件、既存GCP基盤への統合 |
| Airbyte OSS 自ホスト | Airbyte(OSS) | 中〜高 | ライセンス費0円、コネクタ多数、自社運用の余地あり |
HubSpot純正BigQuery統合 は、HubSpotが2024年にBetaで公開した公式コネクタで、Marketing Hub Enterprise + Advanced Reporting Add-on の契約が前提です。管理画面からGoogleアカウントとBigQueryデータセットを認証すると、Contact/Company/Deal/Ticket の4オブジェクトが日次06:00 UTC固定でBigQueryに書き込まれます。コーディング不要で追加コストも0円ですが、カスタムオブジェクト・エンゲージメント・履歴プロパティは対象外、時間単位同期も不可という制約があります。すでにMarketing Hub Enterpriseを使っている会社の「まず標準オブジェクトだけ載せる」用途にははまります。
Fivetran は、700以上のコネクタを備えた米国発のSaaS ELTで、HubSpotコネクタは標準対応(Standard Connectorカテゴリ)です。標準4オブジェクトに加え、カスタムオブジェクト・エンゲージメント・履歴プロパティまで自動同期し、スキーマ変更にも追従します。料金はMAR(Monthly Active Rows:月間の追加・更新・削除された行数)ベースで、HubSpot単体で月$500〜$1,500、複数SaaSを合わせて月$1,000〜$3,000程度が中堅企業の目安。2026年1月からは 削除行と履歴モード行もMARに算入され、コネクタあたり$5の最低課金 も追加されているため、以前より月額が上振れやすくなっています。詳細はFivetranのコスト最適化|MARの削減と契約プランの見直しを参照してください。
trocco は、日本のprimeNumber社が提供するETL/ELT SaaSで、HubSpotコネクタを転送元・転送先の両方で持ちます(2026年3月に転送先が追加)。GUIからノーコードで転送設定を組め、対象オブジェクト・プロパティを転送設定単位で絞り込めるため、Fivetranより MAR相当の転送量をコントロールしやすい のが実務上の強みです。料金はFree(月2時間、0円)、Starter(月75,000円、30時間枠、5ユーザー)、Essential(月150,000円、250時間枠)、Advanced(月300,000円、600時間枠、コネクタ200種類以上)の4段階で、10万コンタクト規模の日次同期ならStarterで十分収まります。円建て請求書払いで国内稟議が通りやすい点も選ばれる理由です(trocco料金体系の詳細と競合比較参照)。
Cloud Run 内製 は、HubSpot API v3(REST)を Python から叩き、Cloud RunとCloud Schedulerで日次バッチを回してBigQueryに書き込む構成です。GCP側の実費は月2,000〜10,000円で、10万コンタクト規模なら余裕を持って収まります。ただし、認証(プライベートアプリのトークン管理)、Batch API(100件/コール)による効率化、Search APIのレート制限、履歴プロパティ取得、多対多の関連付けテーブル設計、削除レコード検知、リトライ処理をすべて自作する必要があり、初期開発費は30万〜80万円、保守工数も上乗せされます。PythonとGCPが触れるエンジニアが1人でもいる会社向けの選択肢です。
Airbyte OSS 自ホスト は、OSSで公開されているAirbyteをGCE(Compute Engine)またはGKE上に自社構築し、HubSpotのソースコネクタでBigQueryに書き込む構成です。ライセンス費は0円、GCP側の実費は月3,000〜8,000円(e2-standard-2 の1台常時稼働+BigQuery実費)で収まります。ただし、Airbyte本体のバージョンアップ追従、DBやワーカーの障害復旧、コネクタ更新時の互換性検証などの運用工数が発生します。既存の自社DevOps体制があり、OSSの運用実績が社内にある会社向けの構成です(マネージド版のAirbyte Cloudを使えば運用工数は下がりますが、月額はtroccoに近づきます)。
HubSpot APIの制限と特有仕様:設計時に必ず押さえるポイント
方式選定と並行して、HubSpot APIの制限と特有仕様を先に押さえておかないと、稼働後に「業務側の他ツールから429エラーが出るようになった」「ダッシュボードの数字が実態とずれた」といった障害を招きます。設計時に必ず確認したいのは、次の3点です。
プラン別のAPIレート上限
- Free/Starter(プライベートアプリ):100リクエスト/10秒、1日250,000コール
- Professional:190リクエスト/10秒、1日625,000コール
- Enterprise:190リクエスト/10秒、1日1,000,000コール
- Search API:全プラン共通で 5リクエスト/秒(別枠制限)
- カウント単位:バーストはアプリ単位、1日上限は アカウント全体で共有
- 超過時:HTTP 429 が返り、リトライは指数バックオフ推奨
10万コンタクトを Batch API(100件/コール)で全件同期する場合、1オブジェクトあたり1,000コール前後で済むため、Professional以上なら日次バッチはAPI上限にほぼ余裕があります。ただし、複数の連携ツール(例:HubSpot純正統合+Fivetran+内製バッチ)を同居させると1日上限を食い合うので、消費配分を意識した設計が必要です。
Search APIの別枠制限
- Search API は他エンドポイントと別枠で 5リクエスト/秒
- 検索条件で差分取得(
updatedAt フィルタなど)する設計を組むと、この制限に接触しやすい - 差分取得は Search API ではなく、CRM Objects API の cursor(
after)ベースで組むのが安全
多対多の関連付け(Association)と型
- Contact ↔ Deal、Contact ↔ Company、Deal ↔ Company などが多対多
- 1つのDealに主担当(Primary Contact)と副担当(Secondary Contact)が別に付く「Association Label」の概念あり
- BigQuery側では中間テーブル(
assoc_contact_deal など)に Association Label まで含めて保存すると、後段の分析柔軟性が上がる
費用相場:初期構築費と月額の目安
「結局いくらかかるのか」を先に押さえたい方向けに、方式別の初期・月額の目安を並べます。対象は「HubSpot Professional/Enterprise + コンタクト10万件 + ディール5万件 + 日次または時間単位同期」の中堅企業ケースを想定しています。
| 方式 | 初期構築費 | 月額運用費(連携部分) | BigQuery費用(別途) |
|---|
| HubSpot純正BigQuery統合 | 0円 | 0円(Marketing Hub Enterprise+Reporting Add-on前提) | 数千〜1万円 |
| trocco Starter | 0円 | 月75,000円(30時間枠) | 数千〜1万円 |
| Fivetran | 50万〜150万円 | 月$500〜$1,500(MAR依存) | 数千〜1万円 |
| Cloud Run 内製 | 30万〜80万円 | 月2,000〜10,000円 | 数千〜1万円 |
| Airbyte OSS 自ホスト | 30万〜60万円 | 月3,000〜8,000円(GCE実費) | 数千〜1万円 |
初期構築費には、要件整理・対象オブジェクト設計・スキーマ設計・変換ロジック(dbt等)・品質検証・ドキュメント整備までを含みます。純正統合とtroccoは設定作業そのものは軽いですが、その周辺の設計工数は他方式と大差ありません。
BigQuery側の実費は、10万コンタクト規模で月数千〜1万円が中央値です。ストレージは論理 $0.02/GB/月、物理 $0.05/GB/月(東京リージョン、2026年目安)で、HubSpotのCRMデータは1本あたり数百MB〜数GBに収まることが多く、費用の主役はクエリスキャン量です。エンゲージメント(メール送信/開封/クリック)まで載せると行数が10倍以上に増えるため、日別パーティションでスキャン量を絞る設計が必須になります。BigQueryのコスト削減の全体像はBigQueryの料金体系とコスト削減|課金トラップと対策にまとめています。
トータルの費用感の中央値は、Marketing Hub Enterprise既契約なら追加0円(純正統合+BQ)、標準的な中堅企業で 月8万円前後(trocco Starter+BQ)、内製で圧縮するなら 月1万円前後(Cloud Run+BQ、初期開発費除く)、複数SaaS横断で運用するなら月15万〜25万円(Fivetran または trocco Essential)のレンジです。3年運用で総額100万〜1,000万円のオーダーになります。
選び方の判断軸:ユースケース・鮮度・技術資産・稟議
方式選定を先に決め打ちで進めると、後から「安く済ませようとしたら要件を満たせなかった」「高機能を選んだが持て余した」というミスマッチが起きます。次の4軸で自社の要件をチェックし、消去法で絞るのが実務的です。
軸1:ユースケースの広さ
- 標準4オブジェクトだけ・Marketing Hub Enterprise契約済み:HubSpot純正BigQuery統合 が追加コスト0円で最速
- カスタムオブジェクト・エンゲージメント・履歴プロパティも欲しい:Fivetran か trocco か 内製
- Sales Hub中心・純正統合の対象外:trocco か Cloud Run 内製 が現実解
軸2:鮮度要件
- 日次で足りる:どの方式でもOK。純正統合と trocco Free が最安
- 時間単位(1時間ごとにダッシュボード更新):trocco Starter、Fivetran、Cloud Run 内製
- 分単位・リアルタイム:HubSpot Webhook を Cloud Run で受けて BigQuery Streaming Insertsに流す 内製構成 が必要(Search APIの5req/秒制限に注意)
軸3:社内の技術資産
- エンジニア工数なし、日本語サポート必須:trocco(Starter以上)
- GCPとPythonが触れるエンジニア1人以上:Cloud Run 内製 が最安・最柔軟
- OSS運用実績あり、DevOpsチームあり:Airbyte OSS 自ホスト
- 複数SaaSを英語系ツールで一元管理したい:Fivetran
軸4:稟議と契約事情
- 円建て請求書払い必須、稟議が厳しい:trocco 一択
- クラウド勘定科目で処理できる、$建てOK:Fivetran も選択肢
- 保守工数を自社で持てる、稟議は柔軟:Cloud Run 内製 か Airbyte OSS
- Marketing Hub Enterprise既契約:純正統合 から始めて足りない部分だけ他方式で補う
この4軸で並べると、多くの中堅企業は「trocco Starter または Cloud Run 内製」の2択に絞れ、複数SaaSを横断する大手はFivetran、Marketing Hub Enterprise既契約組は純正統合+trocco/内製の併用、という切り分けになります。
実装の落とし穴:関連付け・カスタム項目・履歴プロパティ・エンゲージメント
方式を決めたあとに詰まりやすい実装上の落とし穴を4つ挙げます。要件定義の時点で潰しておくと、稼働後の障害対応が大きく減ります。
多対多の関連付け(Association)
Contact ↔ Deal ↔ Company が多対多で結ばれるため、BigQuery側の格納方法を2択で決める必要があります。①中間テーブル(assoc_contact_deal)を作ってContact IDとDeal IDと Association Label(Primary/Secondary/Custom)を保存する正規化パターン、②各テーブルに関連IDの配列カラム(REPEATED INT64)を持たせる非正規化パターン、があります。SQL分析(Looker Studio・Tableauでの結合)を優先するなら①、単一テーブルでUNNESTするなら②。Fivetran・troccoは既定で①(中間テーブル自動生成)を採用しています。内製実装ではAssociation Labelまで含めた設計にしないと、後から「主担当ContactだけでLTVを出したい」といった要件に応えられません。
カスタムオブジェクトとカスタムプロパティのスキーマ変更追従
HubSpotは業務要件に合わせてカスタムオブジェクト(会員/契約/サブスクリプションなど)とカスタムプロパティを増減できます。スキーマ変更時の挙動は方式ごとに違い、Fivetranは自動追従、troccoは自動追従+通知、Airbyteは手動リフレッシュ、純正統合はカスタムオブジェクト対象外 です。カスタム項目が多い(1オブジェクトあたり500項目超)構成では、CRM Objects APIのプロパティ指定を明示的に絞る設計にすると、API消費とBigQueryのカラム数を抑えられます。
履歴プロパティの取り扱い
「ライフサイクルステージがLeadからMQL、SQL、顧客へ何日で遷移したか」といったマーケ分析には、プロパティの値そのものではなく 変更履歴 が必要です。HubSpot API では propertiesWithHistory パラメータを付けて呼ぶと、値・変更日時・変更ソース(ユーザー/ワークフロー/API)の配列が取れます。ただし、ペイロードは通常取得の数倍〜十数倍に膨らむため、API消費とBQストレージ両方に効きます。純正統合は履歴を既定で載せない設計、Fivetranは History Mode(有料・MAR算入対象)、troccoは「値の履歴」取得オプション、内製は自作、と方式ごとに実装差があります。分析要件で必要かどうかを最初に切り分けるのが大事です。
エンゲージメントデータの行数爆発
Email Events API(送信/開封/クリック/バウンス)は、月あたり数万〜数百万イベントを返し、コンタクト数の10〜100倍の行数になります。BigQuery側は必ず日別パーティション(ingested_at DATE型)を切ってスキャン量を制御し、Looker Studioからは直近90日だけを見せるなどのビュー設計を組みます。Fivetranのstandard connectorはエンゲージメントを標準取得しますが、MAR課金が跳ねやすい点に注意。troccoは対象イベントタイプを転送設定で絞れるため、必要な種別(配信/開封/クリック)だけに限定して転送量を抑えるのが定石です。内製ではEmail Events APIのcursor(after)による差分取得と、失敗時の再開ポイント管理が肝になります。
標準構成例:スモール/中規模/複数SaaS横断
具体的な構成イメージがつかめるよう、規模別に3パターン挙げます。
スモール:マーケレポート自動化(月1万円以下)
対象はHubSpot Professional、コンタクト1万〜3万件、ディール5,000件規模。純正統合が使えないケースで、標準4オブジェクトを日次でBigQueryに載せ、Looker Studioで週次のマーケレポートを自動化する構成。
- 連携:trocco Free(月0円、2時間枠)または Cloud Run 内製(月2,000〜5,000円)
- 変換:BigQueryのスケジュールドクエリでシンプルな集計マート
- BI:Looker Studio(無料)
- 想定費用:初期30万〜80万円、月0〜数千円
HubSpotを導入して1〜2年目の中小企業で、まずは営業マネジメントの週次会議で「今月の新規リード数と受注率」を見たい段階の構成です。
中規模:マーケ×営業×CSの横断分析(月8万〜10万円)
対象はHubSpot Enterprise、コンタクト10万件・ディール5万件・チケット3万件規模。カスタムオブジェクト(会員・契約など)と履歴プロパティを含めて BigQueryに統合し、dbtで共通のマーケ→営業→CSファネルテーブルを整備、Lookerで全社ダッシュボードを提供する構成。
- 連携:trocco Starter(月75,000円、30時間枠)
- 変換:dbt Core(自前運用)または dbt Cloud(月$100〜$500)
- BI:Looker Studio Pro または Looker
- 想定費用:初期150万〜400万円、月8万〜15万円
HubSpotを「マーケ・営業・CSの共通データベース」として3部門で使い倒している中堅企業がこのゾーンに入ります。trocco Starterの30時間枠は、10万コンタクト日次+主要オブジェクト時間単位でも余裕を持って収まります。
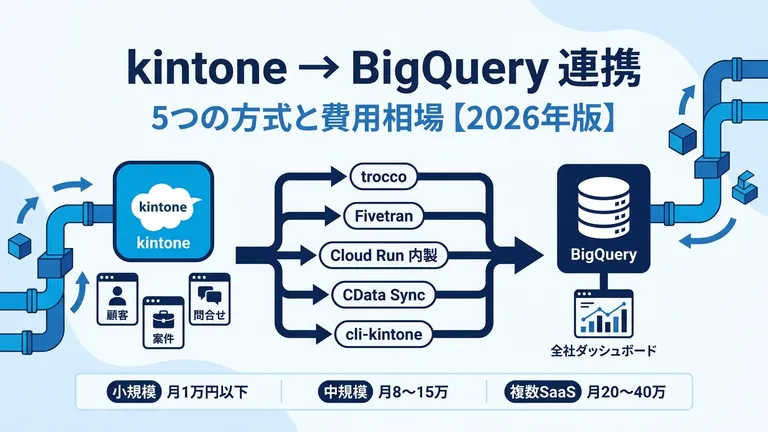
複数SaaS横断:HubSpot+Salesforce+kintone統合(月15万〜25万円)
HubSpot(マーケ)・Salesforce(営業)・kintone(案件管理)など複数SaaSのデータを BigQueryに統合し、部門横断のKPIダッシュボードを Lookerで提供する構成。マーケ×営業×CSの3部門が同じ数字を見ながら意思決定する体制向けです。
- 連携:trocco Essential(月150,000円、250時間枠、ユーザー無制限)または Fivetran(月$1,000〜$3,000)
- 変換:dbt Cloud(月$500〜$1,500)
- BI:Looker(月$3,000〜)または Looker Studio Pro
- 想定費用:初期300万〜600万円、月20万〜40万円
このゾーンでは、稟議と円建て・複数コネクタ数のバランスで trocco Essential と Fivetranのどちらを選ぶかが分かれます。国内SaaS中心なら trocco、海外SaaS比率が高いなら Fivetranが有力です。他SaaSの取り込み方はSalesforceのデータをBigQueryに連携する方法5つと費用相場やkintoneのデータをBigQueryで分析する方法5つと費用相場も参考にしてください。
HubSpot→BigQueryを最短で立ち上げる4ステップ
方式を決めたあとの立ち上げは、次の4ステップで進めるとつまずきにくくなります。
ステップ1:対象オブジェクトとプロパティの絞り込み(1〜2週)
HubSpotにある全オブジェクト・プロパティを載せようとせず、経営会議・部門会議で実際に使われている数字を作るのに必要な範囲に絞ります。標準4オブジェクトに加えて、カスタムオブジェクトは業務上必須のもの、履歴プロパティはライフサイクルステージなど遷移分析で使うものだけ、エンゲージメントは配信/開封/クリックの3種類まで、といった具合に「連携するが誰も見ない」項目を作らないのが立ち上げ時の鉄則です。同時に、Association Labelの棚卸しをして、後段のスキーマ設計に使います。
ステップ2:連携ツールの選定と契約(1〜3週)
前節の4軸で方式を絞り、troccoの場合は Free プランで実データを1オブジェクト通してみます。無料でHubSpot→BigQueryが動くか、関連付けが期待通り分離されるかを確認してから Starter に切り替えます。Cloud Run内製の場合は、まず ContactオブジェクトだけをPythonスクリプトでCloud Runで動かし、Batch APIとcursor取得、Search APIの5req/秒制限を検証します。この段階でAPI消費量を計測し、既存の他連携(HubSpot Zapier等)と合算しての1日上限を確認します。
ステップ3:BigQuery側の設計とdbt構築(2〜5週)
BigQueryに raw_hubspot(連携そのままのテーブル)、stg_hubspot(型変換・命名統一・関連付け中間テーブル生成)、mart_marketing(マーケKPIマート)の3層を作り、dbtでモデルを整備します。この段階で、履歴プロパティの保持方針(全保存か直近N件か)、削除レコードの反映方針、エンゲージメントの日別パーティション設計、Association Labelの持ち方を確定します。マーケ→営業→CSのファネルを見る場合は、ライフサイクルステージの遷移テーブル(fct_lifecycle_transitions)を dbtで組むのが定石です。
ステップ4:ダッシュボード構築と業務移行(1〜3週)
Looker StudioまたはLookerで部門別ダッシュボードを構築し、既存のHubSpot標準レポートやExcelレポートと1〜2週間並行運用して数字が一致することを確認します。並行期間を短くしすぎると「数字が合わない」という指摘で信頼を失うため、最低1週間は取ります。マーケ側で見る配信数と、BigQuery側で集計した配信数がズレるケースの多くは、除外リスト・サブスクライブ解除・ハードバウンスの扱い方に起因するので、切替前に必ず突合しておきます。切替後、既存のHubSpot標準レポートやExcelレポート運用は段階的に廃止します。
HubSpot×BigQuery連携を検討したくなったら
HubSpotのデータをBigQueryに載せると、マーケ・営業・CSをまたいだ横断分析や、Salesforce/kintone等の他SaaSと統合した全社ダッシュボードが一気に組めるようになります。ただし、方式選定・API上限設計・関連付けの正規化・履歴プロパティの保持方針・エンゲージメントの行数管理と、要件定義の段階で決めておくべき論点は多く、選定を誤ると月額が予算の2〜3倍に跳ねたり、必要な分析要件(ファネル遷移・キャンペーンROI)に届かなかったりします。
Evastでは、HubSpotを含む複数SaaSのBigQuery統合基盤構築を、月次のスモールスタートから対応しています。「まず現状のオブジェクト棚卸しと方式選定だけ相談したい」「純正統合とtroccoの見積比較を稟議に使いたい」といった段階からご相談いただけますので、お気軽にお問い合わせください。データ基盤全体の考え方はデータ基盤構築|Evastのデータ基盤構築サービスにまとめています。